N0-VTLA - Scaling Vision-Tactile-Language-Action Model with Latent Tactile Tokens
NeoteAI Team and Fudan TEAI Team, "\(N_0\)-VTLA: Scaling Vision-Tactile-Language-Action Model with Latent Tactile Tokens," arXiv:2607.23782, 2026.
저자
개인 이름이 아니라 NeoteAI Team과 푸단대 TEAI 팀 두 조직 이름으로 나온 기술 리포트입니다. 기여자 명단은 부록에 사전학습, 오프라인 RL, 시뮬레이션 포스트트레이닝, 실기기 포스트트레이닝, 데이터 처리, 학술 지도, 프로젝트 리드 일곱 갈래로 나뉘어 있습니다.
프로젝트 리드는 친이란, 루순린, Shihao Zhao, Daoguo Dong, 우쭈쉬안 다섯 명입니다. 이 조합이 이 논문의 성격을 그대로 설명합니다. 친이란은 Minecraft를 무대로 한 임바디드 에이전트에서 출발해 로봇 조작으로 넘어온 쪽이고, 루순린은 사람의 전신 모션 생성을 하던 쪽입니다. 둘 다 홍콩중문대 선전에서 Ruimao Zhang 지도를 받았습니다. 우쭈쉬안은 푸단대에서 대규모 영상 이해와 영상 생성을 해 온 사람입니다.
촉각을 재구성 대상이 아니라 잠재 예측 대상으로 놓은 이 논문의 핵심 선택은 영상 표현학습 쪽 계보에서 나옵니다. 논문 본문도 JEPA 계열, 특히 LeJEPA와 LeWorldModel을 명시적으로 인용하며 자기 위치를 잡습니다. 영상 사람이 로봇 팀에 들어오면 이런 설계가 나옵니다.
학술 지도는 Ziyi Ye, Guoxiang Dong, 자샤오쑹, Wenming Chen 네 명이 맡았습니다. 자샤오쑹은 엔드투엔드 자율주행에서 Bench2Drive 같은 닫힌 루프 벤치마크를 만들어 온 사람인데, 이 논문이 모든 비교를 하나의 정렬된 평가 규약 아래 두고 롤아웃 성공률로만 판정하겠다고 못 박은 대목과 문제의식이 겹칩니다.
배경
VLA 정책은 조작을 일반화하는 데 성공했습니다. 사전학습된 비전-언어 백본에서 파인튜닝해 지시를 따르고 태스크·장면·몸체를 넘나듭니다. 그런데 촉각은 이 진보에서 거의 빠져 있었습니다.
빠진 자리가 어디인지가 중요합니다. 지금까지 촉각 확장은 태스크 규모 수집에 머물렀습니다. 기껏해야 몇 가지 스킬을 위해 수십 시간을 모은 정도입니다. 그래서 접촉이 결정을 좌우하는 조작에서 정책들이 계속 약합니다.
촉각 신호가 카메라 뷰와 얼마나 다른지를 먼저 봐야 합니다. 이 논문은 시각 기반 촉각 센싱을 다룹니다. 그리퍼 손가락마다 자체 개발 센서를 달아 접촉을 이미지로 읽습니다. 그런데 이 이미지는 카메라 뷰와 성질이 정반대입니다. 노이즈가 많고, 접촉이 없는 동안에는 거의 비어 있고, 정보가 있는 구간은 접촉이 형성되거나 곧 바뀌려는 짧은 순간뿐입니다.
기존 시스템은 촉각을 두 경로 중 하나로 넣었습니다.
첫째, 촉각 토큰을 비전-언어 컨텍스트에 이어붙여 카메라를 하나 더 단 것처럼 다루는 방식입니다. 하지만 정보가 빽빽한 뷰를 전제로 설계된 프리픽스에 희소하고 대부분 침묵하는 신호를 넣어봐야 얻는 게 적습니다.
둘째, 현재 촉각 판독을 액션 경로에 주입해 디노이징을 유도하는 방식입니다. 이쪽은 촉각의 역할 자체를 잘못 규정합니다. 촉각 프레임은 이미 취한 행동이 만들어낸 접촉의 기록입니다. 그 자체로는 다음 행동이 예상해야 할 접촉에 대해 거의 아무것도 말해주지 않습니다. 여기에만 조건을 걸면 정책은 자기가 만든 접촉 사건보다 항상 한 발 늦습니다.
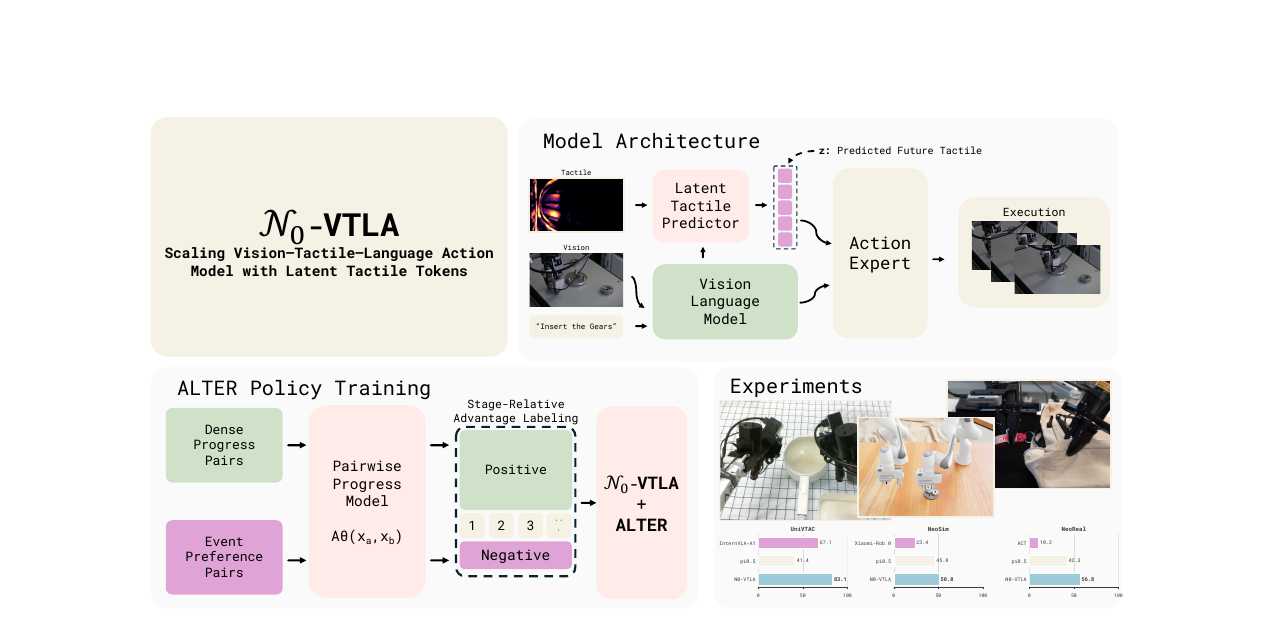
\(N_0\)-VTLA는 세 번째 길을 갑니다. 촉각을 비전-언어 프리픽스 밖에 두고, 액션 전문가를 현재 판독이 아니라 촉각의 예측에 조건 짓습니다.
어떻게 만들었나
촉각 인코더
정책은 원본 촉각 프레임을 절대 보지 않습니다. 뷰 \(k\)에 대해 에피소드 시작 시점의 기준 프레임 \(\mathrm{tac}^k_0\)을 현재 프레임 \(\mathrm{tac}^k_\tau\)에서 픽셀 공간에서 빼고, 그 차이를 얼려둔 자기지도 시각 인코더로 인코딩합니다.
\[g_k = f_{\text{enc}}\left(\mathrm{tac}^k_\tau - \mathrm{tac}^k_0\right) \in \mathbb{R}^{10 \times d}\]
인코더는 DINOv2이고, 뒤에 학습 가능한 선형 프로젝션만 붙습니다. 촉각 이미지 하나가 토큰 10개를 냅니다. 클래스 토큰 1개, 그리고 인코더의 \(16 \times 16\) 패치 그리드에 \(3 \times 3\) 적응형 평균 풀링을 걸어 얻은 공간 토큰 9개입니다.
에피소드별 기준 프레임과의 차분을 쓰는 이유가 있습니다. 절대 젤 이미지를 인코딩하면 젤의 정적 외형과 마운트별 각인이 그대로 들어갑니다. 차분을 쓰면 이게 대부분 사라져서 센서 배치 차이에 강해집니다. 다만 논문은 엄밀한 불변성은 아니라고 선을 긋습니다.
인코더를 얼린 것도 의도적입니다. 자기지도 표현을 그대로 보존하고, 처음 보는 센서를 붙일 때 가벼운 프로젝션만 학습하면 되며, 인코더의 활성값과 옵티마이저 상태를 학습 메모리 예산에서 뺄 수 있습니다.
예측하는 잠재 토큰
예측기는 현재 촉각 차분 토큰 \(g\)를 장면과 지시의 맥락 아래에서 읽어 소수의 학습된 잠재 쿼리로 증류합니다. 이게 잠재 촉각 토큰 \(z\)입니다. 촉각이 아예 없는 에피소드에서는 학습된 널 토큰이 \(g\)를 대신해서, \(z\)는 언제나 생성되고 정책은 실패하는 대신 비전-언어 제어로 폴백합니다.
\(z\)를 서술적이 아니라 예측적으로 만드는 것은 붙은 목표입니다.
\[z^* = \frac{1}{n}\sum_{k=1}^{n} f_{\text{enc}}\left(\mathrm{tac}^k_{\tau+H} - \mathrm{tac}^k_\tau\right) \in \mathbb{R}^{10 \times d}, \quad H = 50\]
같은 촉각 인코더를 다가올 \(H\) 스텝 동안의 촉각 변화에 적용하고 활성 뷰 \(n\)개에 걸쳐 평균낸 값입니다. 즉 \(z\)는 앞으로 올 50 스텝 청크가 만들어낼 순 접촉 변화를 추정하도록 학습됩니다.
\(z\)는 액션 전문가 폭으로 투영되어 노이즈 액션 토큰 앞에 붙습니다. 현재 접촉 토큰 \(g\)는 액션 전문가에 절대 들어가지 않습니다. 예측기를 통해서만 액션 생성에 도달합니다. 액션 토큰은 \(z\)와 비전-언어 프리픽스에 어텐션하지만 프리픽스는 \(z\)에 되돌아 어텐션하지 않고, \(z\) 위치는 출력 헤드 앞에서 잘려나가 액션을 내지 않습니다.
왜 반응하지 않고 예측하는가
논문이 박스로 따로 빼서 강조하는 대목입니다. 촉각이 가장 중요한 행동들은 선행적입니다. 그립이 닫히기 전 밀리미터 단위의 예압, 물체가 움직이기 전에 잡아채는 초기 미끄러짐. 이것들은 접촉 이전의 사각지대에 있습니다. 순수하게 반응적인 신호는 자기를 만들어낸 그 행동을 고치기에는 너무 늦게 도착합니다.
숫자가 이 주장을 받칩니다. 미래 촉각 목표를 현재 촉각 인코딩 \(g\)만으로 순위 매기면 top-1 57%인데, 예측기는 92.3%입니다. 후보 풀이 128개로 커지면 격차가 40% 대 81%로 더 벌어집니다.
3단계 레시피
새로 초기화한 촉각 경로를 사전학습된 백본에 접붙이는 과정입니다. 백본은 PaliGemma 기반 비전-언어 모델에 플로우 매칭 액션 전문가를 단 \(\pi_{0.5}\) 가중치에서 출발합니다.
1단계, 예측기 접지. 베이스 정책 전체를 얼리고 예측기, 촉각 프로젝션, 가벼운 재구성 헤드만 학습합니다. 배치 \(B\)에 대해 \(h(\cdot)\)를 열 개 잠재 토큰의 평균 풀링 뒤 \(\ell_2\) 정규화라 두면, 코사인 유사도는 \(s_{ij} = \langle h(z_i), h(z_j^*) \rangle\)입니다. 대칭 InfoNCE 항은
\[\mathcal{L}_{\text{NCE}} = -\frac{1}{2B}\sum_{i=1}^{B}\left[\log \frac{e^{s_{ii}}}{\sum_{j=1}^{B} e^{s_{ij}}} + \log \frac{e^{s_{ii}}}{\sum_{j=1}^{B} e^{s_{ji}}}\right]\]
이고, 여기에 \(z\)를 성긴 미래 촉각 차분 필드로 디코딩하는 재구성 항 \(\mathcal{L}_{\text{rec}} = \lVert r_\psi(z) - \bar{D}_{\tau \to \tau+H} \rVert_1\)을 더해
\[\mathcal{L}_1 = \mathcal{L}_{\text{NCE}} + \lambda_{\text{rec}} \mathcal{L}_{\text{rec}}\]
를 최소화합니다. 대조 항은 \(z\)가 올바른 미래 접촉을 검색하게 하는 변별 압력을 주고, 재구성 항은 그 접촉이 어디에서 형성되는지의 공간 배치에 \(z\)를 묶어 배치만 분리하는 지름길 잠재를 막습니다.
2단계, 액션 전문가 정렬. 사전학습된 전문가는 이런 토큰을 소비해 본 적이 없습니다. 촉각 인지 스택을 1단계 체크포인트에서 얼리고, 액션 쿼리에 대해 비전-언어 프리픽스의 키와 값을 마스킹합니다. 장면과 지시만으로 액션을 예측하는 지름길을 막았으므로 액션 손실을 낮추는 유일한 경로가 \(z\)를 지나갑니다.
3단계, 종단간 결합 학습. 마스크를 풀고 항상 얼려두는 촉각 인코더 백본을 제외한 전부를 액션 목적함수만으로 함께 학습합니다. 1단계의 대조·재구성 목표는 더 이상 적용되지 않습니다.
논문은 왜 세 단계인지도 박스로 답합니다. 하나의 어려운 결합 최적화를 커리큘럼으로 바꾸는 것입니다. 1단계가 \(z\)의 의미를 고정하고, 2단계가 전문가가 \(z\)를 쓰는 방식을 고정하고, 3단계는 이미 접지되고 이미 소비되는 경로를 다듬기만 합니다. 세 단계를 하나로 합친 free-latent 변형에서는 액션 그래디언트만 \(z\)를 빚기 때문에, 병목이 프리픽스의 복사본으로 퇴화하거나 아예 우회당하는 것을 막을 장치가 없습니다.
ALTER
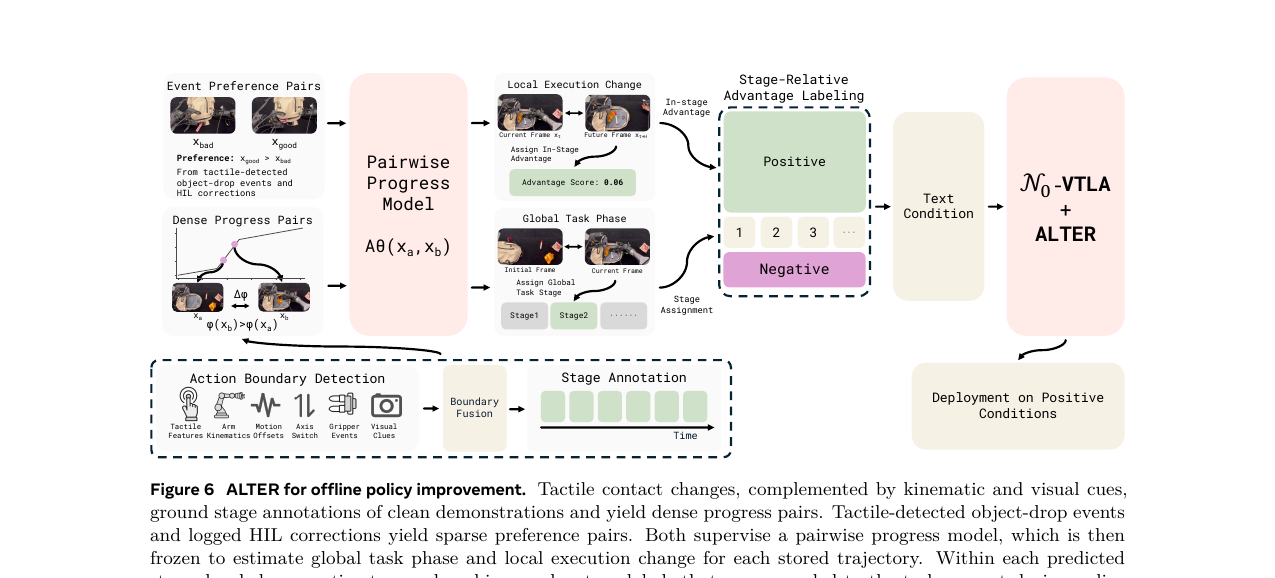
Advantage Labeling from Trajectory Events and Relative Progress의 약자입니다. 고정된 배포 코퍼스가 주어졌을 때 추가 환경 상호작용 없이 어드밴티지 조건부 오프라인 RL을 수행합니다.
지도 신호가 두 종류입니다. 깨끗한 시연은 신호 기반 스테이지 구간에서 조밀한 진척도 지도를 줍니다. 구간 경계는 촉각 접촉 변화, 엔드이펙터 기구학, 그리퍼 상태, 시각 이벤트 단서로 잡습니다. 불완전한 배포 궤적은 촉각으로 검출한 물체 낙하 이벤트와 사람 개입(HIL) 교정 로그에서 희소한 전후 선호를 줍니다.
스테이지 진척도는 지속시간으로 보정합니다. 스테이지 \(k\)의 깨끗한 시연 평균 지속시간 \(\bar{d}_k\)에 대해
\[w_k = \frac{\bar{d}_k}{\sum_{j=1}^{K} \bar{d}_j}, \qquad \phi_t = \sum_{j<k} w_j + w_k u_t\]
여기서 \(u_t \in [0,1]\)은 프레임 \(t\)에서 현재 스테이지의 완료 비율입니다. 스테이지를 평균 지속시간으로 가중하면 짧은 전환 구간과 긴 조작 구간이 \([0,1]\) 범위를 똑같이 나눠 갖는 일을 피할 수 있습니다.
쌍별 진척도 모델 \(A_\theta(x_a, x_b) \in [-1, 1]\)은 이렇게 학습합니다.
\[\mathcal{L}_{\text{prog}} = \mathbb{E}_{\mathcal{D}_{\text{stage}}}\left[A_\theta(x_a,x_b) - (\phi(x_a) - \phi(x_b))\right]^2 + \lambda_{\text{event}} \, \mathbb{E}_{\mathcal{D}_{\text{event}}}\left[\max(0, m - y A_\theta(x_a,x_b))\right]^2\]
낙하 직전 관측을 직후 관측보다 높은 진척도로 라벨링하고, HIL 교정에서는 개입 종료 근처를 시작 근처보다 높게 둡니다. 입력 순서를 무작위로 뒤집어 특정 슬롯이 지름길이 되는 것을 막습니다.
학습된 진척도 모델을 얼린 뒤 저장된 모든 궤적에 적용합니다.
\[\hat{\phi}_t = \delta_e + A_\theta(x_t, x_{e0}), \qquad \hat{r}_t = A_\theta(x_{\min(t+H, T_e-1)}, x_t)\]
\[q_k = \text{Quantile}_{1-\rho}\{\hat{r}_i : s_i = k\}, \qquad c_t = \mathbb{1}[\hat{r}_t \geq q_{s_t}]\]
에피소드 시작과 비교하면 전역 태스크 단계가 나오고, 액션 청크 하나 뒤와 비교하면 국소 실행 변화가 나옵니다. 스테이지 안에서 국소 변화 상위 \(\rho = 0.3\)을 양성으로 남깁니다.
여기서 재미있는 것은 이 이진 라벨을 모델에 넣는 방식입니다. 별도 헤드가 아니라 텍스트입니다. 양성 샘플은 태스크 프롬프트에 Advantage: positive가, 나머지는 Advantage: negative가 붙습니다. 정책 아키텍처와 목적함수는 그대로이고 플로우 매칭 손실도 지도 적응 때와 같습니다. 배포할 때는 프롬프트가 항상 Advantage: positive를 씁니다.
데이터
NeoData는 단일팔·양팔 매니퓰레이터와 UMI 방식 휴대형 수집 그리퍼를 아우르는 다중 플랫폼 시각-촉각 코퍼스입니다. 조작 태스크에 참여하는 모든 그리퍼 손가락에 자체 개발 시각-촉각 센서가 달려서, 접촉이 저차원 힘 신호가 아니라 촉각 이미지 스트림으로 읽힙니다.
모든 몸체를 \(\pi_{0.5}\)에서 물려받은 고정 32차원 상태·액션 컨테이너로 통일합니다. 앞 20차원을 팔당 10차원 슬롯 두 개로 쪼개고 나머지 12차원은 항상 0으로 둡니다. 슬롯 안 10차원은 3차원 엔드이펙터 위치와 6차원 rot6d 회전 등으로 구성됩니다. 각 플랫폼은 자기 몸체가 쓰는 차원만 채우고 나머지는 0 목표를 그대로 재현하도록 학습되므로, 단일팔과 양팔 데이터가 하나의 고정폭 목적함수 아래 공존합니다.
플로우 매칭 목적함수는 32차원 전부에 대해 마스킹 없이 걸리고, 액션 청크 지평은 \(H = 50\)입니다.
결과
평가는 전부 목표 하드웨어 또는 시뮬레이터에서의 롤아웃 성공률로 판정합니다. 이진 성공과 함께 중간 마일스톤에 부분 점수를 주는 100점 진척도 점수도 보고합니다. 베이스 정책과의 비교는 구조적으로 분리됩니다. 촉각 플래그를 끄면 모델이 그대로 베이스 정책이 되므로, 측정된 성공률 차이는 전부 촉각 경로 몫입니다.
시뮬레이션
태스크 |
\(\pi_{0.5}\) |
StarVLA-α |
InternVLA-A1 |
Xiaomi-Rob.-0 |
GigaWorld-P. |
\(N_0\)-VTLA |
|---|---|---|---|---|---|---|
UniVTAC 8개 평균 (%) |
41.4 |
56.1 |
67.1 |
54.3 |
16.5 |
83.1 |
NeoSim 단일팔 4개 (%) |
68.8 |
49.3 |
23.8 |
42.0 |
27.0 |
73.8 |
NeoSim 양팔 8개 (%) |
34.3 |
10.1 |
1.0 |
14.1 |
2.6 |
39.4 |
NeoSim 12개 평균 (%) |
45.8 |
23.2 |
8.6 |
23.4 |
10.8 |
50.8 |
20개 태스크 전체 평균 (%) |
44.0 |
- |
- |
- |
- |
63.8 |
UniVTAC 8개 태스크에서 \(N_0\)-VTLA는 83.1%로 가장 강한 외부 베이스라인 InternVLA-A1의 67.1%를 앞섭니다. 삽입 계열 태스크 몇 개는 포화에 가깝고 grasp-and-classify는 100%입니다.
NeoSim 12개는 모두에게 더 어렵습니다. 전문가 베이스라인들이 8.6%에서 23.4% 사이로 떨어지는 동안 \(N_0\)-VTLA는 50.8%를 지킵니다. 팔 개수에 따른 격차가 눈에 띕니다. 단일팔 4개에서 73.8%인 것이 양팔 8개에서는 39.4%로 반토막 나고, 같은 구간에서 전문가 베이스라인들은 한 자릿수로 무너집니다. InternVLA-A1은 1.0%입니다.
20개 태스크 전체 평균은 63.8% 대 44.0%입니다. 초록의 "44.0%인 가장 강한 베이스라인"은 \(\pi_{0.5}\)를 가리키는데, UniVTAC만 보면 InternVLA-A1이 67.1%로 더 높습니다. 전체 20개 평균 기준의 최강자와 개별 스위트 최강자가 다르다는 점은 표를 볼 때 염두에 둬야 합니다.
실기기
NeoReal 9개 태스크에서 \(N_0\)-VTLA는 성공률 기준으로 모든 태스크에서 가장 강한 베이스라인을 이깁니다. 평균 47.2% 대 \(\pi_{0.5}\) 29.4%입니다. 진척도 점수는 9개 중 8개와 평균에서 앞서고, 평균은 56.8점 대 42.3점입니다. ACT는 어떤 태스크도 완수하지 못하고 평균 10.2 진척도 점수에서 멈춥니다.
태스크 |
ACT |
\(\pi_{0.5}\) |
\(N_0\)-VTLA |
|---|---|---|---|
Socket Plugging (%) |
0 |
60 |
85 |
Board Insertion (%) |
0 |
0 |
25 |
Bottle Standing (%) |
0 |
0 |
30 |
9개 태스크 성공률 평균 (%) |
0 |
29.4 |
47.2 |
9개 태스크 진척도 평균 (점) |
10.2 |
42.3 |
56.8 |
장기 태스크에서는 진척도 점수가 성공률보다 시스템을 더 선명하게 가릅니다. Cardboard Box Folding에서 \(N_0\)-VTLA는 성공률 20%에 스테이지 크레딧 37.2점을 얻는데, \(\pi_{0.5}\)는 19점입니다.
ALTER 적용
태스크 |
\(\pi_{0.5}\)-SFT |
\(N_0\)-VTLA-SFT |
\(\pi_{0.5}\)+ALTER |
\(N_0\)-VTLA+ALTER |
|---|---|---|---|---|
Towel Folding (%) |
40 |
50 |
90 |
95 |
Bag Packing (%) |
65 |
80 |
75 |
80 |
Cardboard Box Folding (%) |
55 |
20 |
60 |
75 |
ALTER를 붙이면 세 태스크 모두에서 크게 오릅니다. 그리고 같은 오프라인 RL 절차를 적용해도 VTLA 백본이 일관되게 앞섭니다. 성공 처리량은 각각 시간당 43회, 15회, 30회입니다.
Cardboard Box Folding의 SFT 열은 눈에 띄는 예외입니다. \(N_0\)-VTLA-SFT가 20%로 \(\pi_{0.5}\)-SFT 55%보다 낮습니다. 본문은 SFT 아래에서 \(N_0\)-VTLA가 세 태스크에서 각각 10, 15, 15점 앞선다고 서술하는데, 그림 9의 막대 수치와는 이 태스크에서 어긋납니다. 프리프린트이므로 그림의 측정값을 정본으로 보는 편이 안전합니다.
표현 분석
1단계가 끝난 시점에 세 가지를 측정합니다.
첫째, 홀드아웃 대조 검색입니다. 홀드아웃 쿼리 378개에 대해 예측된 \(z\)가 약 32개 후보 풀 안에서 자기 미래 촉각 목표 \(z^*\)를 top-1으로 92.3% 검색합니다. 무작위는 3.2%입니다. 논문은 이게 풀 안에서의 비율이지 전체 코퍼스 검색이 아니라고 스스로 단서를 답니다.
둘째, 예측과 자기상관을 가르는 대조군입니다. 예측기의 입력인 현재 촉각 인코딩 \(g\)만으로 같은 후보를 순위 매기면 top-1 57%이고, 128개 풀에서는 40%인데 예측기는 81%를 유지합니다.
셋째, 섭동 프로브입니다. 촉각 입력을 바꾸면 \(z\)가 중심화 코사인 거리로 약 0.9 움직이는 반면 RGB 뷰와 프롬프트를 함께 바꿔도 0.2를 넘지 않습니다. 촉각 대 비전-언어 민감도 비율은 1단계 종료 시점에 4.3이고 종단간 결합 학습 뒤에는 약 1.4입니다.
촉각이 실제로 바꾸는 것
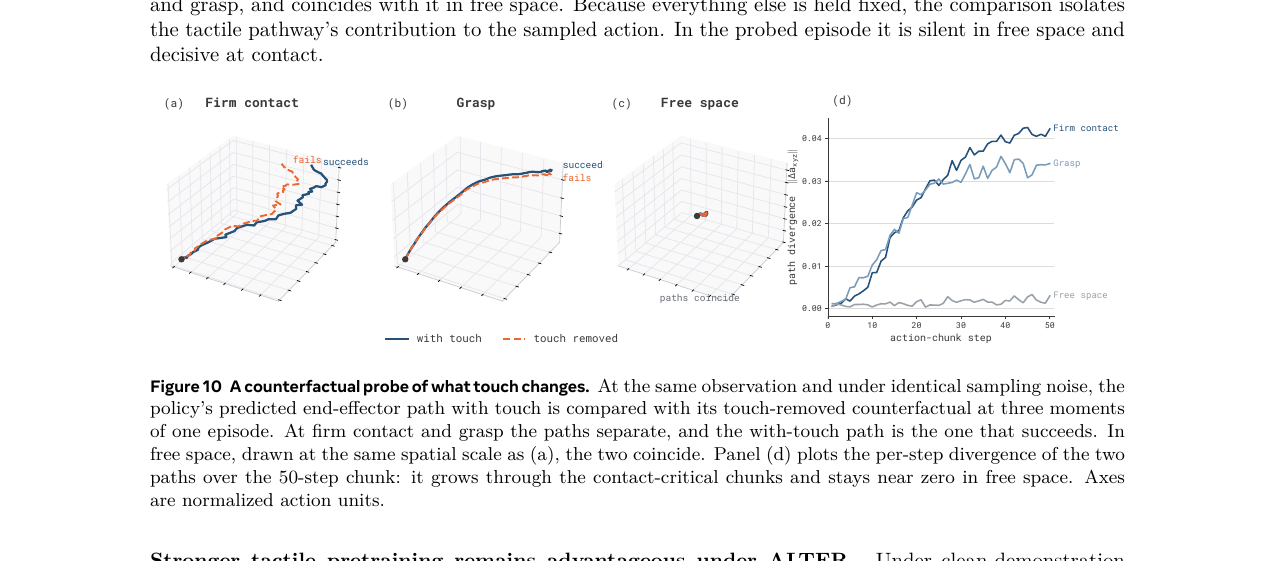
같은 관측과 동일한 샘플링 노이즈 아래에서 촉각을 넣은 정책의 예측 경로와 촉각을 뺀 반사실 경로를 비교한 실험입니다. 단단한 접촉과 파지 순간에는 두 경로가 갈라지고, 갈라진 쪽에서 촉각을 넣은 경로가 성공합니다. 자유 공간에서는 두 경로가 겹칩니다. 50 스텝 청크에 걸친 경로 발산은 접촉 결정 구간에서 자라고 자유 공간에서는 0 근처에 머뭅니다.
행동 수준의 관찰도 붙습니다. Socket Plugging에서 \(\pi_{0.5}\)는 시각 정렬이 삽입 가능하다고 판단하면 하강 동작에 커밋합니다. 플러그가 슬롯이 아니라 테두리에 닿아도 시도를 계속하고 실패합니다. \(N_0\)-VTLA는 예상 못 한 접촉에 팔을 들어 재정렬하고 다시 시도합니다. 삽입이 한 번의 시각적 커밋에서 닫힌 루프 재시도로 바뀝니다.
Bottle Standing에서는 다른 종류의 차이가 나옵니다. 대상은 비어 있는 물렁한 플라스틱 병입니다. \(\pi_{0.5}\)는 병 입구를 너무 세게 잡아 병 전체를 들어올립니다. \(N_0\)-VTLA는 그리퍼 개구를 조금씩 계속 조정해 병을 제어할 만큼만 접촉을 유지하고 들어올리지는 않습니다. 촉각 센서가 힘을 직접 재지는 않지만 변형 신호가 접촉력과 강하게 결합돼 있어 그립 조절의 실용적 피드백이 됩니다.
회고
논문이 스스로 그은 선들을 모으면 이렇습니다.
차분 인코딩이 센서 배치 차이에 강해지긴 하지만 엄밀한 불변성은 아니라고 명시합니다. 92.3% 검색 정확도는 약 32개 후보 풀 안에서의 수치이지 전체 코퍼스 검색이 아니라고 스스로 단서를 답니다. 자율·HIL 궤적에는 단조 라벨을 부여하지 않는데, 이 궤적들이 퇴행하거나 재시도할 수 있기 때문입니다.
논문이 명시적인 Limitations 절을 두지 않은 것은 아쉬운 부분입니다. 대신 결과 곳곳에 남은 문제가 드러납니다.
양팔이 여전히 벽입니다. 단일팔 73.8%가 양팔에서 39.4%로 반토막 납니다. Insert Screw 24%, Unstack Bowl 17%, Unstack Cup 10%처럼 낮은 수치가 몰려 있습니다. 촉각을 넣어도 양팔 협응은 아직 풀리지 않았습니다.
베이스라인이 이기는 칸도 남아 있습니다. NeoSim에서 Insert Screw는 \(\pi_{0.5}\) 26% 대 \(N_0\)-VTLA 24%, Unstack Cup은 Xiaomi-Robotics-0 71% 대 10%로 크게 집니다. UniVTAC의 Insert HDMI는 Xiaomi-Robotics-0 69%에 비해 25%에 그칩니다. "모든 패널에서 앞선다"는 요약은 평균 기준이지 태스크별 전승이 아닙니다.
섭동 프로브의 민감도 비율이 1단계 4.3에서 결합 학습 뒤 1.4로 떨어지는 것도 그대로 읽을 필요가 있습니다. 논문은 잠재가 여전히 촉각 쪽으로 기울어 있다고 해석하지만, 3분의 1로 줄었다는 사실 자체는 3단계가 그래디언트로 접지를 일부 희석한다는 뜻이기도 합니다.
미래 연구로는 두 가지를 듭니다. 예측적 잠재 프레이밍을 이 리포트가 쓴 특정 예측기 구조 너머로 밀어보는 것, 그리고 ALTER를 더 넓은 조작 설정으로 확장해 효과를 검증하는 것입니다.
정리
촉각을 관측 컨텍스트에 하나 더 얹는 대신 다가올 액션 청크가 만들어낼 접촉 변화를 예측하는 잠재 토큰으로 바꿨습니다. 이게 이 논문의 전부이고, 92.3% 대 57%라는 검색 실험이 그 선택이 자기상관이 아니라 예측이라는 것을 보여줍니다.
새로 초기화한 경로를 사전학습 백본에 접붙이는 3단계 커리큘럼이 이 설계를 실제로 작동시킵니다. 의미를 고정하고, 인터페이스를 고정하고, 그다음에 함께 학습합니다. 한 번에 다 하면 병목이 프리픽스의 복사본으로 퇴화합니다.
ALTER는 배포 로그를 어드밴티지 조건부 오프라인 RL로 되먹이는데, 이진 라벨을 별도 헤드가 아니라 프롬프트 텍스트로 넣어 정책 구조와 손실을 그대로 둡니다. 다만 양팔 조작은 촉각을 넣어도 여전히 절반 이하이고, 개별 태스크에서 베이스라인이 이기는 칸도 남아 있습니다.