PhiZero - A World Model Built Around Physical Language
S. Shang, Y. Wang, R. Gao, X. Chen, T. Tan, L. Fan, and Z. Zhang, "PhiZero: A World Model Built Around Physical Language," arXiv:2607.28624, 2026.
영상 월드 모델은 시각적으로 그럴듯한 미래를 잘 만듭니다. 그런데 테니스공이 고무 오리를 때리는 장면을 생성하면, 공은 날아가는데 오리는 아무 일도 없었다는 듯 가만히 있습니다. 충돌은 그렸지만 충돌의 결과는 그리지 못한 것입니다.
주류 접근이 픽셀 공간에서 직접 예측하도록 학습되기 때문입니다. 세계가 어떻게 변하는지에 대한 지식이 고차원 시각 표현 안에 암묵적으로만 남아 있고, 명시적인 추론 대상이 되지 못합니다. PhiZero는 여기에 중간 표현을 하나 끼워 넣습니다.

저자
중국과학원 자동화연구소(CASIA) 패턴인식 국가중점연구실 팀입니다. 1저자는 상수야오(Shuyao Shang)이고, 프로젝트 리더이자 교신저자는 Yuqi Wang입니다.
이 조합이 왜 이 논문을 냈는지는 이력에서 읽힙니다. 왕위치와 Lue Fan, Zhaoxiang Zhang은 Drive-WM(CVPR 2024)과 잠재 월드 모델 기반 엔드투엔드 자율주행(ICLR 2025)으로 자율주행 월드 모델을 이어 온 팀입니다. 자율주행은 도메인이 좁고 잘 정의돼 있어서 "픽셀을 잘 그리는 것과 세계가 어떻게 변하는지 아는 것은 다르다"는 문제가 가장 먼저 드러나는 자리입니다. 이 논문은 그 문제의식을 도메인을 열어젖힌 채로 다시 던진 결과에 가깝습니다.
Tieniu Tan은 중국과학원 원사이자 CASIA 전 소장으로, 중국 컴퓨터비전의 세대를 만든 인물입니다.
배경
논문은 사람의 지능에서 출발점을 가져옵니다. 사람은 개별 시각적 결과를 통째로 외우지 않습니다. 시각 경험에서 패턴을 추상화해 세계가 어떻게 변하는지에 대한 일반화 가능한 지식으로 만듭니다. 그리고 자연어가 그 지식을 조직하고 표현하는 주된 매체 역할을 합니다. 언어 모델이 디지털 영역 전반에서 성공한 것도 언어가 학습과 추론의 기질(substrate)로서 확장 가능함을 보여 줍니다.
그런데 모델링 대상이 디지털 세계에서 물리 세계로 옮겨가면 자연어는 너무 거칩니다. "공이 오리를 친다"는 문장으로는 시각 경험에 담긴 복잡한 상태 전이를 충실히 표현할 수 없습니다.
그래서 논문의 질문은 이렇게 됩니다. 자연어를 넘어서면서, 명시적 추론이 가능할 만큼 구조화된, 더 세밀한 물리 세계 전이 표현을 학습할 수 있는가.
저자들이 각주로 못 박아 둔 것이 하나 있습니다. 여기서 physical은 물리 세계를 폭넓게 가리키는 말이지 물리 법칙의 기호 체계를 뜻하지 않습니다. 이름 때문에 이 논문이 뉴턴 방정식을 학습한다고 오해하기 쉬운데 그런 논문이 아닙니다.
어떻게 만들었나
문제 설정
미래 영상을 \(V\), 현재 세계 상태를 나타내는 첫 프레임을 \(I^0\), 텍스트 행동 의도를 \(c\), \(I^0\)에서 \(V\)로의 전이를 서술하는 이산 physical language를 \(z\)라 둡니다. 미래 예측을 physical language 시퀀스와 미래 영상의 결합 모델링으로 놓고 둘로 인수분해합니다.
\[p_{\theta,\psi}(V, z \mid I^0, c) = \underbrace{p_\theta(z \mid I^0, c)}_{\text{추론}} \cdot \underbrace{p_\psi(V \mid I^0, z)}_{\text{렌더링}}\]
이것이 reason-then-render 패러다임입니다. 상태 전이 추론과 픽셀 수준 합성을 분리합니다.
Physical Language Tokenizer
세계 역학을 시각적 외형에서 떼어내는 것이 관건입니다. 토크나이저는 자기지도 영상 재구성으로 이 표현을 학습합니다.
영상 \(V \in \mathbb{R}^{B \times 3 \times T \times H \times W}\)를 시공간 인코더에 넣어 잠재 특징 \(x \in \mathbb{R}^{B \times C \times t \times h \times w}\)를 얻습니다. 여기서 설계 선택이 갈립니다. 영상 전체에서 전역 표현을 뽑는 대신, 인접한 잠재 상태 쌍 사이의 전이를 명시적으로 모델링합니다. 시간 \(i\)의 잠재 상태를 \(x_i\)라 할 때, 인접 쌍 \((x_i, x_{i+1})\)마다 공유 Q-Former로 전이 표현을 뽑습니다.
\[q_i = \text{QFormer}(Q; x_i, x_{i+1})\]
\(Q \in \mathbb{R}^{M \times D_q}\)는 \(M\)개의 공유 학습 가능 전이 쿼리입니다. 이것이 국소 시간 귀납 편향을 넣어 각 압축 전이의 복잡도를 낮추면서 전체 시퀀스의 시간 순서는 보존합니다. 모든 인접 구간의 특징을 시간 순으로 이어 붙이면 \(q \in \mathbb{R}^{B \times N \times D_q}\)이고 \(N = (t-1)M\)입니다.
이 전이 특징을 유한 스칼라 양자화(FSQ)로 이산화합니다.
\[z = \text{FSQ}(\text{Proj}_{\text{down}}(q))\]
FSQ는 어휘를 스칼라 양자화 준위의 데카르트 곱으로 구성하므로 별도로 학습하는 코드북이 필요 없습니다. 구현에서는 준위를 \((8,5,5,5,5,5)\)로 두어 어휘 크기 \(8 \times 5^5 = 25{,}000\)을 얻고, 전이 쿼리는 \(M = 32\)개를 씁니다. 33프레임 영상은 9개 시간 잠재 상태로 인코딩되므로 physical language 시퀀스 길이는 \((9-1) \times 32 = 256\)입니다.
확산 사전 디코더
용량이 제한된 병목이 재구성에 필요한 모든 외형 디테일까지 떠안으면 안 됩니다. 그래서 디코더로 사전학습된 영상 확산 모델(Wan2.2-5B)을 씁니다. 원래 아키텍처를 그대로 두고 텍스트 조건 자리만 physical language 컨텍스트 \(P_c\)로 갈아 끼웁니다.
여기에 첫 프레임 \(I^0\)을 깨끗한 시각 조건으로 함께 넣습니다. 정적 외형은 첫 프레임이 담당하게 만들어, 이산 병목이 중복된 외형 정보 대신 미래의 상태 변화에 집중하도록 밀어붙이는 설계입니다. 손실은 표준 flow matching입니다.
\[\mathcal{L}_{\text{FM}} = \mathbb{E}_{x,\epsilon,\tau}\left[\left\lVert v_\psi(x_\tau, \tau; I^0, P_c) - (\epsilon - x^0)\right\rVert_2^2\right], \quad x_\tau = (1-\tau)x^0 + \tau\epsilon\]
순수 노이즈 워밍업
여기가 이 논문에서 가장 실용적인 트릭입니다. 사전학습된 확산 디코더는 새로 들어온 physical language 조건을 그냥 무시할 수 있습니다. 부분적으로 손상된 타깃 정보와 자기가 이미 가진 디노이징 사전만으로도 어느 정도 복원이 되기 때문입니다.
이 지름길을 막기 위해 워밍업 단계에서 미래 프레임 잠재를 전부 순수 노이즈로 초기화합니다. 그러면 디코더는 physical language 컨텍스트와 첫 프레임에 의존하는 것 외에 방법이 없습니다. 워밍업이 끝나면 표준 flow matching 노이즈 스케줄로 복귀합니다.
데이터 큐레이션
인터넷 영상 5만 시간 규모의 실세계 풀과 1천 시간 규모의 시뮬레이션 풀에서 시작합니다. 중복 제거, 압축 아티팩트·손상 프레임·워터마크 같은 기술적 결함 제거, 해상도·길이 미달과 급격한 샷 전환 제거를 거쳐 토크나이저 사전학습용 10K 시간을 얻습니다.
SFT 단계에서는 미학적 품질, 모션 크기, 그리고 VLM 판정자가 평가한 상태 전이의 관측 가능성으로 2차 필터링을 겁니다. 실세계와 시뮬레이션 데이터를 합쳐 4초 클립 500만 개가 나옵니다. 여기서 다시 VLM 기반 리치모션 필터와 물리 필터를 걸어 리즈너 SFT용 100만 클립을 남깁니다.
커리큘럼도 붙습니다. 사전학습은 \(256 \times 448\) 해상도에서 클립 길이를 1초 → 2초 → 4초로 늘려가며 진행해, 토크나이저가 국소 상태 변화를 먼저 배우고 나서 더 긴 범위의 세계 진화를 다루게 합니다. 그다음 \(512 \times 896\)으로 해상도를 올려 SFT하고, 마지막에 토크나이저를 동결한 채 확산 디코더만 다듬습니다.
Physical Language Reasoner
리즈너는 사전학습된 VLM(Qwen3-VL-4B)에서 초기화합니다. 토크나이저가 학습한 physical language 공간에 맞추기 위해 어휘를 확장하는데, FSQ 인덱스 하나마다 별개의 원자 심볼을 하나씩 붙입니다. 즉 25K개 심볼이 VLM 어휘에 추가됩니다.
첫 프레임 \(I^0\)과 텍스트 프롬프트 \(c\)가 주어지면 길이 \(N\)의 시퀀스를 자기회귀로 예측합니다.
\[p_\theta(z \mid I^0, c) = \prod_{j=1}^{N} p_\theta(z_j \mid I^0, c, z_{<j})\]
지도 신호는 오프라인으로 만듭니다. 동결된 토크나이저로 학습 영상을 인코딩해 \(z = T_\phi(V)\)를 얻고, 티처 포싱 아래 자기회귀 교차 엔트로피로 최적화합니다.
\[\mathcal{L}_{\text{VLM}} = -\sum_{j=1}^{N} \log p_\theta(z_j \mid I^0, c, z_{<j})\]
캡션을 만들 때 주의를 하나 기울입니다. 텍스트 조건이 결과를 미리 알려주면 안 되므로, VLM에게 클립의 세밀한 전이를 서술하지 말고 상위 수준의 시작 행동이나 상호작용만 요약하라고 지시합니다. "와인이 잔에 채워지고 표면이 출렁인다"가 아니라 "와인을 잔에 따른다"입니다.
무엇으로 구성돼 있나
토크나이저의 압축률이 이 설계의 핵심 주장입니다. 4초 실세계 영상 500개를 8 FPS로 샘플링해 \(512 \times 896\) 해상도에서 평가한 결과입니다. 토큰 수는 첫 프레임 조건을 제외한 표현 토큰 기준입니다.
모델 |
토큰 수 |
PSNR |
SSIM |
LPIPS |
|---|---|---|---|---|
Wan2.2-5B VAE |
44,800 |
37.7 |
0.957 |
0.042 |
Video-LaVIT |
270 |
23.6 |
0.835 |
0.175 |
VideoFlexTok (\(k=32\)) |
288 |
25.2 |
0.858 |
0.177 |
VideoFlexTok (\(k=64\)) |
576 |
26.5 |
0.870 |
0.167 |
PhiZero |
256 |
28.9 |
0.903 |
0.087 |
읽는 법이 중요합니다. Wan2.2 VAE가 모든 재구성 지표에서 압도적으로 좋지만 연속 시각 토큰을 44,800개 씁니다. PhiZero는 256개 이산 심볼로 미래 상태 전이를 표현합니다. 175배 압축입니다. 비교 대상은 VAE가 아니라 같은 고압축 진영인 Video-LaVIT과 VideoFlexTok이고, 그 안에서는 토큰을 가장 적게 쓰면서 재구성 품질이 가장 좋습니다.
토크나이저 절제 실험도 설계 선택을 하나씩 확인합니다.
구성 |
PSNR |
SSIM |
LPIPS |
|---|---|---|---|
확산 디코더 제거 |
26.6 |
0.875 |
0.119 |
전이 수준 Q-Former 제거 |
28.2 |
0.896 |
0.089 |
순수 노이즈 워밍업 제거 |
27.9 |
0.894 |
0.091 |
전체 |
28.9 |
0.903 |
0.087 |
가장 크게 무너지는 것은 확산 디코더를 결정론적 디코더로 바꿨을 때입니다. 생성 사전이 세밀한 외형을 복원해 주기 때문에 압축 병목이 상태 전이에만 집중할 수 있다는 가설이 여기서 확인됩니다. 전이 수준 Q-Former를 전역 Q-Former로 바꾸면 국소 시간 귀납 편향이 사라져 성능이 떨어지고, 순수 노이즈 워밍업을 빼면 디코더가 자기 디노이징 사전에 기대는 지름길로 돌아갑니다.
결과
생성 벤치마크 세 개와 이해 벤치마크 세 개를 씁니다. 이해 쪽 평가 프로토콜이 특이한데, 세 벤치마크 모두 쌍 비교입니다. 물리적·인과적으로 타당한 영상과 그렇지 않은 짝을 구분해야 합니다. PhiZero는 두 영상을 각각 physical language 시퀀스로 인코딩한 뒤 리즈너 아래에서 로그 우도를 계산해 더 높은 쪽을 타당한 영상으로 고릅니다.
생성
모델 |
S-IoU |
ST-IoU |
WS-IoU |
IQ-Score |
|---|---|---|---|---|
Wan2.2-5B |
24.7 |
22.6 |
13.3 |
21.2 |
Sora 2 |
37.3 |
27.0 |
26.9 |
26.5 |
Cosmos3-Nano |
40.4 |
22.0 |
24.6 |
29.1 |
Wan2.2-14B |
51.1 |
20.5 |
28.5 |
32.2 |
Hunyuan-Video |
47.1 |
26.9 |
29.7 |
33.4 |
Grok-Video |
52.7 |
21.4 |
35.7 |
34.8 |
Cosmos3-Super |
미보고 |
미보고 |
미보고 |
39.5 |
PhiZero |
58.2 |
36.8 |
27.6 |
41.2 |
Physics-IQ Verified는 생성 영상을 실제 참조 영상과 규칙 기반 지표로 비교합니다. PhiZero가 IQ-Score 41.2로 1위이고, 특히 ST-IoU 36.8은 2위 Sora 2의 27.0을 크게 앞섭니다. 다만 WS-IoU에서는 Grok-Video의 35.7에 밀립니다. 모든 칸을 이긴 것은 아닙니다.
베이스라인이 Wan2.2-5B라는 점을 함께 봐야 합니다. PhiZero의 확산 디코더가 바로 그 Wan2.2-5B에서 초기화됐고, 같은 백본이 21.2에서 41.2로 갑니다. 이 논문이 자기 기여를 가장 정직하게 보여 주는 대조군입니다.
PhyGround(물리 법칙 준수, 물리 특화 VLM 판정자)에서는 종합 2.97로 Wan2.2-14B의 2.95를 앞서지만, 일반 품질(General Quality)은 2.93으로 Wan2.2-14B의 3.00과 Veo3.1의 3.01에 밉니다. 물리 점수 3.01은 1위입니다. 물리적 일관성을 사고 시각 품질을 조금 내준 결과입니다.
WorldModelBench에서는 물리 준수 4.88, 상식 1.71, 총점 8.19로 모두 1위입니다.
이해
모델 |
Easy |
Medium |
Hard |
전체 |
|---|---|---|---|---|
Cosmos-4B |
46.00 |
52.00 |
48.05 |
49.41 |
Qwen2.5-VL |
50.96 |
53.25 |
51.49 |
52.27 |
GPT-4o |
57.69 |
54.75 |
54.17 |
53.75 |
V-JEPA |
52.00 |
53.00 |
57.42 |
53.75 |
Gemini-2.5 Flash |
64.42 |
56.75 |
54.46 |
55.63 |
PhiZero |
60.98 |
60.50 |
52.38 |
56.34 |
IntPhys2(직관 물리 이해)에서 전체 56.34로 1위이지만 분해해 보면 그림이 다릅니다. Medium에서 60.50으로 확실히 앞서는 대신 Hard에서는 52.38로 V-JEPA(57.42)와 Gemini-2.5 Flash(54.46)에 밀립니다. Easy도 Gemini-2.5 Flash가 앞섭니다. 어려운 문제일수록 격차가 사라지는 패턴입니다.
LikePhys(물리 타당성 판별, 오차가 낮을수록 좋음)에서는 평균 오차 41.7로 1위입니다. 강체 오차 29.14는 2위 Hunyuan-Video(36.34)를 크게 앞서지만, 유체 오차 53.15는 표에서 거의 최하위권이라 LTX-Video-2B의 33.43과 비교가 안 됩니다. 강체 역학은 잘 잡고 유체는 못 잡는다는 뜻이고, 이것이 이 모델의 현재 능력 지도에 가깝습니다.
YoCausal(실세계 인과 이해)에서는 종합 순위 2.0으로 1위이고 CCI 6.20이 최고치입니다.
Physical language가 실제로 무엇을 담고 있나
두 개의 분석이 표현의 성격을 보여 줍니다.
전이성 실험은 이렇습니다. 소스 영상의 상태 전이를 인코딩한 뒤, 첫 프레임만 다른 외형으로 편집하고, 바뀌지 않은 physical language 시퀀스를 그 프레임 조건에서 디코딩합니다. 결과 영상은 따르기, 점성 있는 퍼짐, 액체 흐름 같은 전이 패턴을 외형과 배경이 크게 바뀌어도 유지합니다. 상태 전이가 외형과 실제로 분리돼 있다는 직접 증거입니다.
의미 구조 분석은 자율주행과 로봇 조작 두 도메인에서 진행합니다. 각 4개 범주에 300샘플씩(nuScenes에서 좌회전·우회전·직진·정지, AGI-Bot RealRobot에서 그리퍼 하강·폐쇄, 상승·폐쇄, 하강·개방, 쓸기) 전이 특징을 클립 수준으로 모아 PCA로 20차원으로 줄이고 UMAP으로 3D에 투영합니다. 자율주행에서는 정지 클립이 뚜렷한 군집을 이루고 조향 패턴들이 연속 매니폴드를 따라 배열됩니다. 로봇 조작에서는 네 그리퍼 전이 패턴이 압축된 별개 군집을 이룹니다. 시각적 내용이 아니라 세계가 어떻게 변하는지에 따라 영상이 조직된다는 뜻입니다.
제로샷 전이
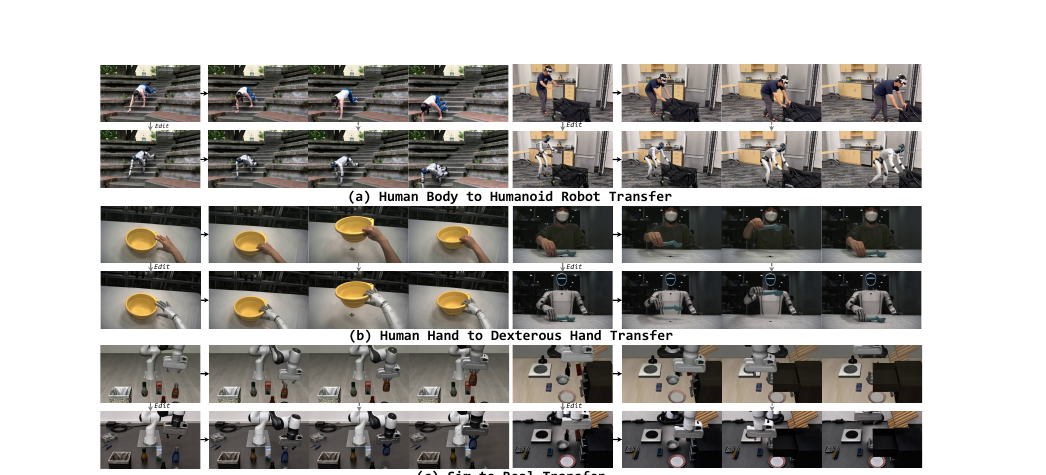
외형과 분리돼 있다는 성질이 응용으로 이어집니다. 사람 동작 영상의 상태 전이를 physical language로 인코딩하고, 첫 프레임에서 사람 몸을 Unitree G1 휴머노이드로, 사람 손을 Sharpa 다지 핸드로 갈아 끼운 뒤, 바뀌지 않은 시퀀스를 디코딩합니다. 대상별 학습 없이 전신 동작과 손 동작 패턴이 전혀 다른 형태의 몸으로 옮겨집니다. 같은 방식으로 LIBERO 시뮬레이션 영상의 첫 프레임을 사실적 도메인으로 바꿔 sim-to-real 전이도 합니다.
리즈너 절제 실험 하나를 짚고 넘어가야 합니다.
방법 |
IQ-Score |
|---|---|
Wan2.2-5B (베이스라인) |
21.2 |
|
26.6 |
PhiZero, 시뮬레이션 데이터 없이 |
37.7 |
PhiZero, 2단계 학습 없이 |
39.2 |
PhiZero 전체 |
41.2 |
프롬프트 강화는 자연어를 더 정교하게 써서 같은 베이스라인을 끌어올리는 방법입니다. 21.2에서 26.6으로 오르지만 41.2와는 거리가 큽니다. 자연어 추론만으로는 세밀한 상태 전이를 모델링하기에 부족하다는 논문의 전제를 직접 검증한 실험입니다. 이 표가 없으면 "그냥 프롬프트를 잘 쓰면 되는 것 아닌가"라는 반론에 답할 수 없습니다.
회고
저자들이 부록에 적은 한계가 세 가지입니다.
첫째, physical language는 상태 전이의 경험적 표현으로 학습됐을 뿐 기호적 물리 법칙의 명시적 정식화가 아닙니다. 데이터 기반이라 라벨 없는 다양한 영상에서 확장 가능하게 학습되지만, 결과로 나온 이산 심볼들이 해석 가능한 물리 변수나 형식적 법칙에 접지돼 있지는 않습니다. 25K개 심볼 중 무엇이 "중력"이고 무엇이 "마찰"인지 아무도 모릅니다. 이름이 language인데 사람이 읽을 수는 없는 언어입니다.
둘째, 관찰 영상에서 주로 학습되므로 커버리지가 학습 데이터에서 시각적으로 관측 가능한 것에 제한됩니다. 촉각 상호작용이나 미시적 입자 역학처럼 시각적으로 모호하거나 시각으로 접근하기 어려운 전이는 모델링이 어렵습니다. 앞서 본 유체 오차 53.15가 이 한계의 한 단면일 수 있습니다.
셋째, 데이터와 계산 자원의 제약으로 현재 구현은 비교적 작은 규모 모델(리즈너 4B, 디코더 5B)과 물리 세계의 다양성에 비하면 제한적인 학습 코퍼스를 씁니다. 저자들은 이 규모에서 나온 성능을 근거로 스케일업 여지를 주장합니다.
여기에 한 가지를 더해야 정직합니다. 현재 구현은 고정 길이 클립, 그것도 4초짜리를 다룹니다. 저자들이 향후 과제로 계층적·순환적 예측을 통한 장기 지평 모델링을 꼽은 것이 이 지점입니다. 33프레임을 256심볼로 압축하는 구조 자체가 긴 시간축으로 그대로 확장되지 않는다는 뜻이기도 합니다.
정리
세 가지가 남습니다.
첫째, 픽셀을 바로 예측하지 않고 이산 표현을 끼우는 결정이 무엇을 사고 무엇을 파는지가 이 논문의 전부입니다. 삽니다. 상태 전이가 명시적 추론 대상이 되고, 외형에서 분리되고, 다른 몸체로 옮겨집니다. 팝니다. 표현이 담지 못하는 현상은 원천적으로 못 만듭니다. 유체 오차와 IntPhys2 Hard 성적이 그 대가가 어디로 갔는지 보여 줍니다.
둘째, physical language라는 이름을 액면가로 받으면 안 됩니다. 저자들이 각주로 못 박았듯 물리 법칙의 기호 체계가 아니라 물리 세계를 폭넓게 가리키는 말이고, 25K개 심볼은 사람이 해석할 수 없습니다. 어휘 크기, 무엇을 한 심볼로 묶는지(\(M=32\)개 전이 쿼리 × 인접 잠재 쌍), 학습 신호가 어디서 오는지(자기지도 영상 재구성)를 확인하고 나서야 이 표현의 실체가 잡힙니다.
셋째, 추가 학습 없이 다섯 가지 태스크를 처리한다는 주장은 표현이 태스크 중립적이라는 뜻입니다. 그리고 실제로 모든 태스크에서 1등을 하지는 않습니다. Physics-IQ의 WS-IoU는 Grok-Video에, PhyGround 일반 품질은 Veo3.1과 Wan2.2-14B에, IntPhys2 Hard는 V-JEPA에 밀립니다. 하나의 인터페이스로 전부를 덮은 대가입니다. 이 논문의 주장은 "제일 잘한다"가 아니라 "같은 표현 하나로 생성·이해·제어·전이가 전부 붙는다"입니다.
프로젝트 페이지는 Phi-Zero.github.io이고 정성 결과가 영상으로 올라와 있습니다.