Deep Residual Learning for Image Recognition
K. He, X. Zhang, S. Ren, and J. Sun, "Deep Residual Learning for Image Recognition," arXiv:1512.03385, 2015.
저자
저자 네 명은 모두 마이크로소프트 리서치 아시아(MSRA) 소속이었습니다. 1저자 허카이밍과 시니어 저자 쑨젠은 같은 시각 컴퓨팅 그룹에서 몇 년째 함께 논문을 내던 사이였고, 장샹위와 런사오칭은 그 그룹의 젊은 연구자였습니다.
이 팀이 ResNet을 쓰게 된 배경은 그들의 이전 논문 목록에 있습니다. 허카이밍과 쑨젠은 2015년 CVPR 논문 "Convolutional Neural Networks at Constrained Time Cost"에서 층을 더 쌓았는데 오히려 성능이 떨어지는 현상을 이미 보고했습니다. 같은 해 네 사람은 ReLU 신경망용 가중치 초기화(흔히 "He 초기화"라고 부르는 방법)와 PReLU를 제안한 논문으로 ImageNet에서 사람 수준 오류율을 넘겼다고 발표했습니다. 런사오칭은 Faster R-CNN의 1저자였습니다. 초기화, 검출, 깊이의 한계를 모두 직접 다뤄 본 팀이 "깊이 자체를 막는 것은 무엇인가"라는 질문에 답한 논문입니다.
논문은 CVPR 2016 최우수 논문상을 받았습니다. Nature가 2025년에 집계한 자료에서는 21세기에 가장 많이 인용된 논문으로 꼽혔습니다.
배경
2012년 AlexNet 이후 ImageNet 성적은 깊이를 따라 올라갔습니다. 8층이던 네트워크가 VGG에서 16~19층, GoogLeNet에서 22층으로 깊어졌고, Batch Normalization을 쓴 Inception은 30층 가까이 되었습니다. 그렇다면 층을 계속 쌓기만 하면 될까요. 논문은 이 질문으로 시작합니다.
오랫동안 걸림돌은 기울기 소실·폭주였습니다. 이 문제는 정규화된 초기화와 중간 정규화층(Batch Normalization)으로 상당 부분 풀려서 수십 층 네트워크도 SGD로 수렴하기 시작했습니다. 그런데 수렴하게 되자 다른 문제가 드러났습니다. 깊이를 늘리면 정확도가 포화되다가 급격히 떨어집니다. 저자들은 이를 성능 저하(degradation) 문제라고 불렀습니다.
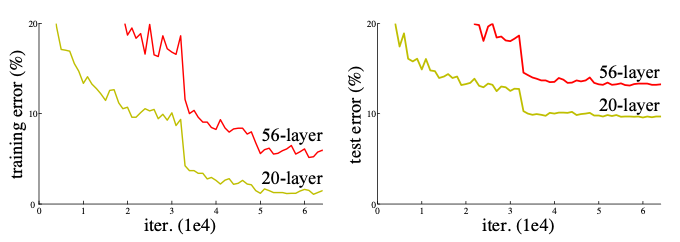
CIFAR-10에서 20층과 56층 "plain" 네트워크를 비교한 그림입니다(왼쪽은 학습 오류, 오른쪽은 테스트 오류). 56층이 테스트 오류뿐 아니라 학습 오류까지 높습니다. 과적합이라면 학습 오류는 낮아야 하므로, 이것은 과적합이 아니라 최적화 문제입니다.
저자들의 논증은 간단합니다. 얕은 모델에 층을 더한 깊은 모델을 생각해 봅니다. 더한 층이 항등 함수이고 나머지 층이 얕은 모델을 그대로 복사하면, 깊은 모델은 얕은 모델과 똑같은 해를 가집니다. 따라서 깊은 모델의 학습 오류가 더 높을 이유가 없습니다. 그런데 실제 SGD는 이 해조차 찾지 못합니다. 여러 비선형 층으로 항등 함수를 근사하는 일이 생각보다 어렵다는 뜻입니다.
어떻게 만들었나
잔차 학습
몇 개의 층이 근사해야 할 함수를 \(\mathcal{H}(\mathbf{x})\)라고 합니다. 층이 \(\mathcal{H}(\mathbf{x})\)를 직접 배우는 대신, 입력과의 차이만 배우게 합니다.
\[\mathcal{F}(\mathbf{x}) := \mathcal{H}(\mathbf{x}) - \mathbf{x}, \qquad \mathcal{H}(\mathbf{x}) = \mathcal{F}(\mathbf{x}) + \mathbf{x}\]
두 형태 모두 원하는 함수를 근사할 수 있다면 표현력은 같습니다. 달라지는 것은 학습의 쉬움입니다. 항등 함수가 최적이라면 비선형 층의 가중치를 0으로 보내기만 하면 됩니다. 실제로 항등 함수가 최적일 가능성은 낮지만, 최적 함수가 0보다 항등 함수에 가깝다면 항등 함수를 기준으로 작은 변화만 찾는 편이 쉽다는 것이 저자들의 가설입니다. 저자들은 이를 문제의 사전 조건화(preconditioning)라고 표현합니다.
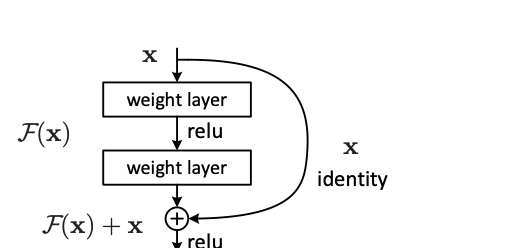
구현은 "지름길 연결(shortcut connection)" 하나입니다. 입력 \(\mathbf{x}\)와 출력 \(\mathbf{y}\)에 대해 빌딩 블록을 다음과 같이 정의합니다.
\[\mathbf{y} = \mathcal{F}(\mathbf{x}, \{W_i\}) + \mathbf{x}\]
위 그림처럼 층이 두 개면 \(\mathcal{F} = W_2\, \sigma(W_1 \mathbf{x})\)이고 \(\sigma\)는 ReLU입니다(편향 생략). 덧셈 뒤에 ReLU를 한 번 더 적용합니다. 항등 지름길은 파라미터도 연산량도 늘리지 않습니다. 그래서 깊이, 폭, 파라미터 수, 연산량이 같은 plain 네트워크와 잔차 네트워크를 공정하게 비교할 수 있습니다.
채널 수가 바뀌어 차원이 맞지 않을 때는 선형 사상 \(W_s\)로 맞춥니다.
\[\mathbf{y} = \mathcal{F}(\mathbf{x}, \{W_i\}) + W_s \mathbf{x}\]
\(\mathcal{F}\)가 층 하나뿐이면 \(\mathbf{y} = W_1\mathbf{x} + \mathbf{x}\)로 선형층과 다를 바 없어서 이점이 관찰되지 않았습니다. 그래서 블록은 두 층 또는 세 층으로 만듭니다.
구조
기준이 되는 plain 네트워크는 VGG의 설계 철학을 따릅니다. 대부분 \(3 \times 3\) 합성곱을 쓰고, 두 가지 규칙을 지킵니다. 출력 특징 맵 크기가 같으면 필터 수도 같게 하고, 특징 맵 크기가 절반이 되면 필터 수를 두 배로 늘려 층당 연산량을 유지합니다. 다운샘플링은 stride 2 합성곱으로 하고, 마지막은 global average pooling과 1000-way 완전 연결층입니다. 34층 plain 네트워크의 연산량은 36억 FLOPs로 VGG-19(196억 FLOPs)의 18%입니다. VGG의 거대한 완전 연결층을 없앤 덕분입니다.
여기에 \(3 \times 3\) 층 두 개마다 지름길을 붙이면 잔차 네트워크가 됩니다. 차원이 늘어나는 지점의 지름길은 세 가지 방식으로 실험했습니다.
- (A) 늘어난 차원을 0으로 채운 항등 지름길. 파라미터가 늘지 않습니다.
- (B) 차원이 늘어날 때만 \(1 \times 1\) 합성곱 사상을 쓰고 나머지는 항등 지름길을 씁니다.
- (C) 모든 지름길을 사상으로 바꿉니다.
50층 이상은 학습 시간 때문에 블록을 "병목(bottleneck)" 구조로 바꿨습니다. \(1 \times 1\) 합성곱으로 차원을 줄이고, \(3 \times 3\) 합성곱을 적용한 뒤, 다시 \(1 \times 1\)로 차원을 되돌리는 세 층 블록입니다. 병목 블록에서는 항등 지름길이 특히 중요합니다. 지름길을 사상으로 바꾸면 고차원 양 끝을 잇게 되어 연산량과 모델 크기가 두 배가 됩니다.
| 단계 | 출력 | ResNet-18 | ResNet-34 | ResNet-50 | ResNet-101 | ResNet-152 |
|---|---|---|---|---|---|---|
| conv1 | \(112 \times 112\) | \(7 \times 7\), 64, stride 2 | 〃 | 〃 | 〃 | 〃 |
| conv2_x | \(56 \times 56\) | 기본 × 2 | 기본 × 3 | 병목 × 3 | 병목 × 3 | 병목 × 3 |
| conv3_x | \(28 \times 28\) | 기본 × 2 | 기본 × 4 | 병목 × 4 | 병목 × 4 | 병목 × 8 |
| conv4_x | \(14 \times 14\) | 기본 × 2 | 기본 × 6 | 병목 × 6 | 병목 × 23 | 병목 × 36 |
| conv5_x | \(7 \times 7\) | 기본 × 2 | 기본 × 3 | 병목 × 3 | 병목 × 3 | 병목 × 3 |
| FLOPs | \(1.8 \times 10^9\) | \(3.6 \times 10^9\) | \(3.8 \times 10^9\) | \(7.6 \times 10^9\) | \(11.3 \times 10^9\) |
기본 블록은 \(3 \times 3\) 합성곱 두 개, 병목 블록은 \(1 \times 1\), \(3 \times 3\), \(1 \times 1\) 합성곱 세 개입니다. conv2_x 앞에는 \(3 \times 3\) max pooling이 있고, 끝은 average pooling + 1000-d 완전 연결층 + softmax입니다.
152층 ResNet은 VGG-16/19(153억/196억 FLOPs)보다 연산량이 적습니다. 깊이는 8배인데 더 가볍습니다.
학습
구현은 AlexNet과 VGG의 관행을 따랐습니다. 짧은 변을 \([256, 480]\)에서 무작위로 정해 크기를 바꾸고, \(224 \times 224\)를 무작위로 잘라냅니다(좌우 반전 포함). 픽셀 평균을 빼고 AlexNet의 색상 증강도 썼습니다. 모든 합성곱 직후, 활성화 함수 직전에 Batch Normalization을 넣었고, 가중치는 He 초기화로 시작했습니다.
SGD를 배치 256, 학습률 0.1(오류가 정체되면 10분의 1로), weight decay 0.0001, 모멘텀 0.9로 최대 60만 반복 돌렸습니다. Dropout은 쓰지 않았습니다. 비교 실험은 표준 10-crop 테스트로 평가했고, 최고 기록에는 여러 해상도의 완전 합성곱 평가를 평균했습니다.
결과
plain과 잔차의 비교
먼저 지름길 외에는 완전히 같은 네트워크를 비교했습니다. 잔차 네트워크는 옵션 A를 썼으므로 파라미터가 하나도 늘지 않았습니다.
| 깊이 | plain top-1 오류 (%) | ResNet top-1 오류 (%) |
|---|---|---|
| 18층 | 27.94 | 27.88 |
| 34층 | 28.54 | 25.03 |
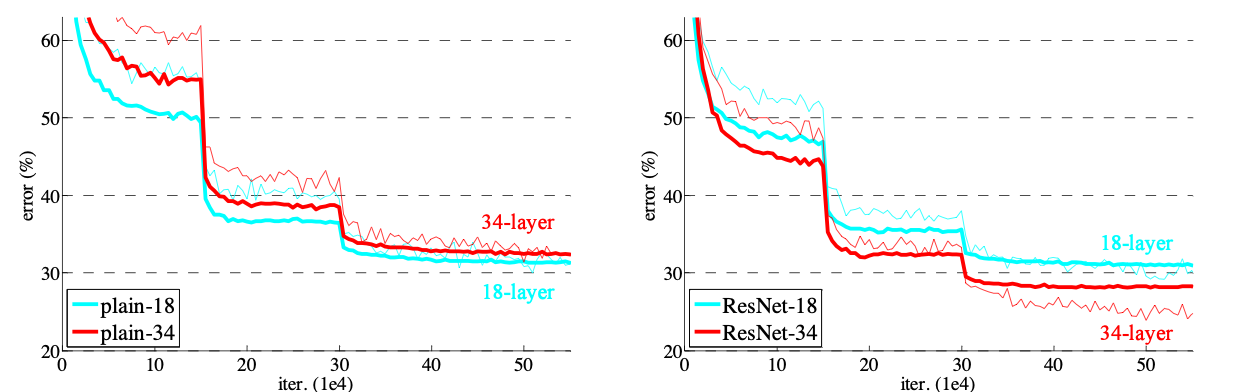
가는 선은 학습 오류, 굵은 선은 검증 오류입니다. 왼쪽 plain 네트워크에서는 34층(빨강)이 18층(하늘색)보다 학습 내내 오류가 높습니다. 18층의 해 공간이 34층의 부분집합인데도 그렇습니다. 오른쪽 잔차 네트워크에서는 상황이 뒤집혀 34층이 18층보다 2.8%p 낮습니다.
세 가지가 읽힙니다. 첫째, 잔차 학습으로 성능 저하가 사라지고 깊이에서 이득을 얻습니다. 둘째, 34층 기준으로 잔차 네트워크가 plain보다 top-1 오류를 3.5%p 낮춥니다. 셋째, 18층에서는 둘의 정확도가 비슷하지만 잔차 쪽이 훨씬 빨리 수렴합니다. 너무 깊지 않은 네트워크라면 SGD가 plain에서도 좋은 해를 찾고, 잔차 연결은 초반 수렴을 빠르게 해 줍니다.
저자들은 plain 네트워크의 실패가 기울기 소실 때문이 아니라는 점도 확인했습니다. BN 덕분에 순전파 신호의 분산은 0이 아니고, 역전파 기울기의 노름도 건강했습니다. 반복 횟수를 3배로 늘려도 성능 저하는 그대로였습니다. 저자들은 깊은 plain 네트워크의 수렴 속도가 지수적으로 느릴 수 있다고 추측만 하고, 원인 규명은 향후 과제로 남겼습니다.
깊이와 지름길 방식
ImageNet 검증셋, 10-crop 테스트 결과입니다(논문 Table 3).
| 모델 | Top-1 오류 (%) | Top-5 오류 (%) |
|---|---|---|
| VGG-16 | 28.07 | 9.33 |
| GoogLeNet | - | 9.15 |
| PReLU-net | 24.27 | 7.38 |
| plain-34 | 28.54 | 10.02 |
| ResNet-34 A | 25.03 | 7.76 |
| ResNet-34 B | 24.52 | 7.46 |
| ResNet-34 C | 24.19 | 7.40 |
| ResNet-50 | 22.85 | 6.71 |
| ResNet-101 | 21.75 | 6.05 |
| ResNet-152 | 21.43 | 5.71 |
A, B, C 모두 plain보다 훨씬 낫고, 셋 사이의 차이는 작습니다. B가 A보다 약간 나은 이유를 저자들은 A에서 0으로 채운 차원은 잔차 학습을 하지 않기 때문이라고 봤습니다. C가 B보다 아주 조금 나은 것은 사상 지름길 13개가 추가한 파라미터 덕으로 해석했습니다. 결론은 사상 지름길이 성능 저하 해결에 필수가 아니라는 것이고, 이후로는 메모리와 연산을 아끼려고 C를 쓰지 않았습니다. 50/101/152층으로 갈수록 오류가 꾸준히 떨어지며 성능 저하는 관찰되지 않았습니다.
최고 기록과 대회
| 방법 | 형태 | Top-5 오류 (%) |
|---|---|---|
| GoogLeNet (ILSVRC'14) | 앙상블, test | 6.66 |
| VGG (v5) | 앙상블, test | 6.8 |
| PReLU-net | 앙상블, test | 4.94 |
| BN-Inception | 앙상블, test | 4.82 |
| ResNet-152 | 단일 모델, val | 4.49 |
| ResNet (ILSVRC'15) | 앙상블, test | 3.57 |
ResNet-152 단일 모델(4.49%)이 기존의 모든 앙상블을 넘었습니다. 깊이가 다른 모델 6개를 묶은 앙상블(제출 시점에는 152층이 2개뿐이었습니다)은 테스트셋에서 3.57%로 ILSVRC 2015 분류 부문 1위를 했습니다. 단일 모델은 검증셋, 앙상블은 테스트셋 기준이라 두 숫자를 직접 비교할 수는 없습니다.
CIFAR-10과 1,000층
CIFAR-10에서는 일부러 단순한 구조를 썼습니다. 첫 층 \(3 \times 3\) 합성곱 다음에 특징 맵 크기 \(\{32, 16, 8\}\)마다 \(2n\)개 층(필터 \(\{16, 32, 64\}\)개)을 쌓아 총 \(6n + 2\)층입니다. 지름길은 모두 항등(옵션 A)이므로 잔차 네트워크와 plain 네트워크의 깊이, 폭, 파라미터 수가 정확히 같습니다.
| 모델 | 층 수 | 파라미터 | 테스트 오류 (%) |
|---|---|---|---|
| FitNet | 19 | 2.5M | 8.39 |
| Highway | 19 | 2.3M | 7.54 |
| Highway | 32 | 1.25M | 8.80 |
| ResNet | 20 | 0.27M | 8.75 |
| ResNet | 56 | 0.85M | 6.97 |
| ResNet | 110 | 1.7M | 6.43 (5회 평균 6.61 ± 0.16) |
| ResNet | 1202 | 19.4M | 7.93 |
plain 네트워크는 ImageNet처럼 깊어질수록 학습 오류가 높아졌고(plain-110은 오류가 60%를 넘어 그림에서 제외), 잔차 네트워크는 깊어질수록 좋아졌습니다. 110층에서는 처음 학습률 0.1이 너무 커서, 학습 오류가 80% 아래로 내려갈 때까지(약 400 반복) 0.01로 "warm up"한 뒤 0.1로 돌아갔습니다. 2017년 Transformer 논문보다 먼저 등장한 warmup입니다.
1,202층 네트워크도 최적화에는 아무 문제가 없어 학습 오류가 0.1% 아래로 떨어졌습니다. 그런데 테스트 오류(7.93%)는 110층보다 나빴습니다. 저자들은 작은 데이터셋에 19.4M 파라미터는 지나치게 커서 생긴 과적합이라고 봤고, maxout이나 dropout 같은 강한 정규화를 쓰지 않았다는 점을 밝혔습니다.
층 응답 분석도 있습니다. 각 \(3 \times 3\) 층 출력(BN 뒤, 비선형 전)의 표준편차를 재 보니 잔차 네트워크가 plain보다 대체로 작았고, 깊을수록 더 작았습니다. 잔차 함수가 0에 가깝다는 처음 가설을 뒷받침하는 결과이고, 층이 많을수록 개별 층이 신호를 덜 바꾼다는 뜻입니다.
검출로의 전이
Faster R-CNN의 백본을 VGG-16에서 ResNet-101로 바꾸기만 한 결과입니다. 검출 구현이 같으므로 차이는 순전히 표현의 차이입니다.
| 데이터 | 지표 | VGG-16 | ResNet-101 |
|---|---|---|---|
| PASCAL VOC 2007 test | mAP (%) | 73.2 | 76.4 |
| PASCAL VOC 2012 test | mAP (%) | 70.4 | 73.8 |
| COCO val | mAP@.5 (%) | 41.5 | 48.4 |
| COCO val | mAP@[.5, .95] (%) | 21.2 | 27.2 |
COCO 표준 지표가 6.0%p, 상대적으로 28% 올랐습니다. 초록의 "28% 상대 개선"이 이 숫자입니다. 박스 정제, 전역 문맥, 다중 스케일 테스트, 앙상블을 더해 ImageNet 검출(2위보다 8.5%p 앞섬), ImageNet 위치 추정(top-5 오류 9.0%, ILSVRC'14 대비 64% 감소), COCO 검출, COCO 분할까지 2015년 대회 1위를 휩쓸었습니다.
회고
"왜"는 열린 채로 남았습니다. 논문은 plain 네트워크가 왜 실패하는지 설명하지 못했고, 저자들도 이를 인정했습니다. 기울기 소실이 아니라는 것만 확인하고 "수렴 속도가 지수적으로 느릴 수 있다"는 추측을 남겼습니다. 잔차 형태가 왜 최적화를 쉽게 하는지도 사전 조건화라는 직관과 층 응답이 작다는 간접 증거에 기댑니다. 각주에서는 "여러 비선형 층이 복잡한 함수를 점근적으로 근사할 수 있다"는 전제 자체가 아직 열린 문제라고 밝힙니다.
동시대 연구. 같은 시기에 Highway Networks가 게이트가 달린 지름길을 제안했습니다. 저자들은 차이를 분명히 합니다. Highway의 게이트는 데이터에 따라 열리고 닫히며 파라미터가 있습니다. 게이트가 닫히면 잔차가 아닌 함수를 배웁니다. ResNet의 항등 지름길은 파라미터가 없고 절대 닫히지 않습니다. 그리고 Highway는 100층 이상에서 정확도 향상을 보여 주지 못했습니다. 결과적으로 살아남은 쪽은 더 단순한 설계였습니다.
덧셈 뒤의 ReLU. 원 논문은 덧셈 뒤에 ReLU를 한 번 더 적용합니다. 그래서 지름길이 완전한 항등 경로가 아닙니다. 저자들은 몇 달 뒤 후속 논문 "Identity Mappings in Deep Residual Networks"에서 BN과 ReLU를 잔차 가지 앞으로 옮긴 "pre-activation" 구조로 1,001층 네트워크를 학습시켰습니다. 1,202층 실험이 남긴 숙제를 저자들이 직접 푼 셈입니다.
실험상의 빈틈. ImageNet 결과는 대부분 단일 실행이고, 0.3~0.5%p 차이의 A/B/C 비교에는 분산이 없습니다. CIFAR-10의 ResNet-110만 5회 평균을 보고했습니다. 병목 블록은 "학습 시간을 감당하기 위해" 들어간 실용적 선택이라서, 깊이의 효과와 블록 구조 변경의 효과가 50층 이상에서는 섞여 있습니다. 각주에서 병목이 아닌 깊은 ResNet도 깊이로 이득을 본다고(CIFAR-10 기준) 덧붙였지만 ImageNet 수치는 없습니다.
ImageNet을 넘어서. 서론의 마지막 문장은 잔차 학습 원리가 범용적이고 시각 외 문제에도 적용될 것이라는 기대입니다. 그 기대는 그대로 맞았습니다. 1년 반 뒤 Attention Is All You Need가 이 논문을 인용하며 모든 하위층에 잔차 연결을 붙였고, 지금의 LLM도 같은 구조를 씁니다. 수천 층을 쌓는 것이 목표였던 논문이 결과적으로 "층을 쌓아도 망가지지 않는 블록"이라는 더 일반적인 부품을 남겼습니다.
정리
- 깊은 네트워크의 학습 오류가 오히려 커지는 성능 저하는 과적합도 기울기 소실도 아닌 최적화 문제였고, 층이 \(\mathcal{F}(\mathbf{x}) = \mathcal{H}(\mathbf{x}) - \mathbf{x}\)만 배우게 하는 항등 지름길 하나로 해결되었습니다.
- 파라미터와 연산량을 늘리지 않고 152층까지 쌓아 VGG보다 가벼운 모델로 ImageNet top-5 3.57%를 기록했고, ILSVRC와 COCO 2015의 다섯 개 부문에서 1위를 했습니다.
- 잔차 연결은 이후 CNN, Transformer, LLM의 공통 부품이 되었습니다. 다만 그것이 왜 잘 작동하는지는 이 논문에서 끝까지 설명되지 않았습니다.