ImageNet Classification with Deep Convolutional Neural Networks
A. Krizhevsky, I. Sutskever, and G. E. Hinton, "ImageNet Classification with Deep Convolutional Neural Networks," in Advances in Neural Information Processing Systems 25 (NIPS 2012), 2012.
저자
저자는 세 명이고 모두 토론토 대학교 소속이었습니다. 알렉스 크리젭스키와 일리야 수츠케버는 제프리 힌턴 연구실의 대학원생이었습니다.
세 사람의 역할은 분명하게 나뉩니다. 크리젭스키는 석사 논문에서 CIFAR-10 데이터셋을 만들었고, GPU용 합성곱 라이브러리 cuda-convnet을 직접 짠 사람입니다. 이 논문의 계산은 사실상 그의 코드 위에서 돌아갔습니다. 컴퓨터 역사 박물관(CHM)의 정리에 따르면, ImageNet에 CNN을 적용하자는 아이디어는 신경망 성능이 데이터 양에 따라 커질 것이라고 믿은 수츠케버에게서 나왔습니다. 2011년 수츠케버가 크리젭스키를 설득했고, 힌턴은 연구 책임자를 맡았습니다. 학습은 크리젭스키 부모님 집 침실에 있던, GPU 두 장을 꽂은 컴퓨터에서 돌아갔습니다. 힌턴은 이 과정을 "일리야가 해야 한다고 생각했고, 알렉스가 그걸 해냈고, 노벨상은 내가 받았다"고 요약했습니다. 그리고 이 논문에 쓰인 ReLU와 Dropout은 모두 힌턴 연구실에서 나온 기법입니다.
ILSVRC-2012에는 "SuperVision"이라는 팀 이름으로 참가했습니다. 우승 직후 세 사람은 DNNresearch라는 회사를 세웠고, Google이 2013년에 이 회사를 인수했습니다. 그 뒤 힌턴은 Google Brain에 합류했고 수츠케버는 OpenAI를 공동 창업했습니다. 크리젭스키는 2017년 Google을 떠나 스타트업 Dessa의 기술 자문을 맡았고, 그 뒤로는 공개 활동이 거의 없습니다.
배경
2012년 이전 이미지 인식의 주류는 사람이 설계한 특징이었습니다. SIFT 같은 지역 기술자를 뽑고, 이를 Fisher Vector나 sparse coding으로 묶은 다음, 선형 분류기에 넣는 파이프라인이었습니다. 합성곱 신경망(CNN)은 얀 르쿤의 LeNet 이후 숫자 인식에서는 통했지만, 고해상도 자연 이미지에서는 계산 비용과 과적합 때문에 주류가 되지 못했습니다.
이 논문의 서론은 바로 그 빈자리를 짚습니다. 기존 라벨 데이터셋(NORB, Caltech-101/256, CIFAR-10/100)은 수만 장 규모라서 큰 모델을 학습시킬 수 없었습니다. 그런데 페이-페이 리 팀의 ImageNet이 1,500만 장, 22,000개 범주라는 규모를 열었습니다. 여기에 GPU가 받쳐 주면서 큰 CNN을 과적합 없이 학습시킬 조건이 처음으로 갖춰졌습니다.
저자들은 CNN이 이미지에 대해 "통계의 정상성(stationarity)과 픽셀 의존성의 지역성"이라는 강하고 대체로 옳은 가정을 한다고 설명합니다. 그래서 비슷한 크기의 완전 연결 신경망보다 연결과 파라미터가 훨씬 적고, 성능 상한은 거의 떨어지지 않는다고 봤습니다. 남은 문제는 규모였고, 이 논문은 그 규모를 실제로 돌려 본 첫 사례입니다.
어떻게 만들었나
데이터
ILSVRC는 ImageNet에서 1,000개 범주, 범주당 약 1,000장을 떼어 낸 대회입니다. 학습 120만 장, 검증 5만 장, 테스트 15만 장으로 구성됩니다. 테스트 라벨이 공개된 버전은 ILSVRC-2010뿐이라서 실험 대부분은 2010 데이터로 했습니다.
전처리는 최소한으로 했습니다. 짧은 변을 256으로 맞추고 가운데 \(256 \times 256\)을 잘라낸 뒤, 학습셋 평균 픽셀값만 뺐습니다. 손으로 설계한 특징은 전혀 쓰지 않고 중심화한 RGB 원시값을 그대로 넣었습니다. 이것이 이 논문의 가장 급진적인 선택입니다.
아키텍처
학습되는 층은 8개로, 합성곱층 5개와 완전 연결층 3개입니다. 파라미터는 약 6,000만 개, 뉴런은 약 65만 개입니다.
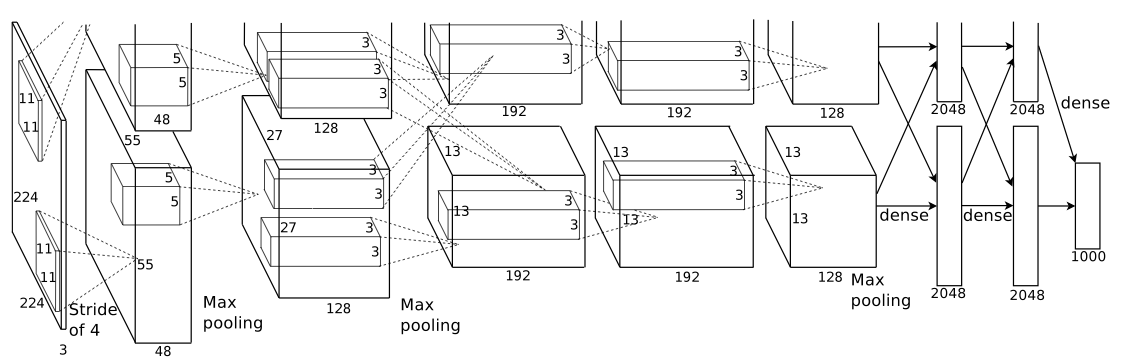
그림이 위아래로 나뉜 이유는 GPU 두 장에 모델을 반씩 나눠 올렸기 때문입니다. GTX 580 한 장의 메모리가 3GB라 모델 전체가 들어가지 않았습니다. 두 GPU는 특정 층에서만 서로의 출력을 주고받습니다.
| 층 | 커널 / 뉴런 | 크기 | 뒤따르는 연산 |
|---|---|---|---|
| conv1 | 96 | \(11 \times 11 \times 3\), stride 4 | ReLU → LRN → max pool |
| conv2 | 256 | \(5 \times 5 \times 48\) | ReLU → LRN → max pool |
| conv3 | 384 | \(3 \times 3 \times 256\) (두 GPU 교차 연결) | ReLU |
| conv4 | 384 | \(3 \times 3 \times 192\) | ReLU |
| conv5 | 256 | \(3 \times 3 \times 192\) | ReLU → max pool |
| fc6 | 4096 | 완전 연결 (교차) | ReLU → Dropout |
| fc7 | 4096 | 완전 연결 (교차) | ReLU → Dropout |
| fc8 | 1000 | 완전 연결 | softmax |
conv2, conv4, conv5는 같은 GPU에 있는 이전 층의 커널 맵만 입력으로 받습니다. conv3와 완전 연결층만 두 GPU를 가로질러 연결됩니다. 커널 깊이가 48, 192처럼 절반으로 적힌 것도 그래서입니다.
저자들은 3장의 구성 요소를 중요도 순으로 정렬했습니다. 그 순서를 그대로 따라가 보겠습니다.
ReLU. 당시 표준 활성화 함수는 \(\tanh(x)\)나 \((1+e^{-x})^{-1}\)처럼 포화하는 함수였습니다. 이 논문은 Nair & Hinton (2010)의 ReLU를 씁니다.
\[f(x) = \max(0, x)\]
CIFAR-10에서 4층 CNN으로 학습 오류 25%에 도달하는 시간을 비교하니, ReLU가 tanh보다 6배 빨랐습니다. 저자들은 포화하는 뉴런을 썼다면 이 정도 크기의 네트워크로는 실험 자체를 할 수 없었을 것이라고 적었습니다. ReLU의 의미는 성능보다 실험 속도에 있었습니다.
여러 GPU에 나눠 학습. 커널(뉴런)을 GPU마다 절반씩 두고 일부 층에서만 통신하게 했습니다. 연결 패턴은 교차 검증으로 정했습니다. 커널 수를 절반으로 줄인 단일 GPU 넷과 비교하면 top-1 오류가 1.7%p, top-5 오류가 1.2%p 줄었습니다.
Local Response Normalization(LRN). ReLU는 입력 정규화 없이도 포화하지 않습니다. 그래도 저자들은 같은 위치의 인접한 커널끼리 경쟁시키는 정규화가 일반화에 도움이 된다고 봤습니다. 커널 \(i\)의 위치 \((x, y)\) 활성값을 \(a^i_{x,y}\), 그 층의 커널 수를 \(N\)이라고 두면 다음과 같습니다.
\[b^i_{x,y} = a^i_{x,y} \bigg/ \left( k + \alpha \sum_{j=\max(0,\, i-n/2)}^{\min(N-1,\, i+n/2)} \left(a^j_{x,y}\right)^2 \right)^{\beta}\]
검증셋으로 정한 값은 \(k=2\), \(n=5\), \(\alpha=10^{-4}\), \(\beta=0.75\)입니다. 실제 뉴런의 측면 억제(lateral inhibition)에서 착안했고, 평균을 빼지 않으므로 저자들은 "밝기 정규화"라고 부르는 편이 정확하다고 덧붙였습니다.
겹치는 풀링. 풀링 간격 \(s\)와 창 크기 \(z\)를 같게 두는 대신 \(s=2\), \(z=3\)으로 창을 겹쳤습니다. 출력 크기가 같은 \(s=z=2\) 방식과 비교했을 때 효과가 있었고, 겹치는 풀링을 쓴 모델이 조금 더 과적합하기 어려웠다고 보고합니다.
과적합 대응
저자들은 4장을 과적합에 할애했습니다. 클래스가 1,000개이므로 학습 예시 하나가 주는 제약은 \(\log_2 1000 \approx 10\)비트입니다. 6,000만 개 파라미터를 학습시키기에는 120만 장도 모자랐습니다.
데이터 증강 1: 자르기와 뒤집기. \(256 \times 256\) 이미지에서 무작위로 \(224 \times 224\) 패치를 잘라내고 좌우 반전도 섞었습니다. 학습셋이 2,048배로 늘어나는 효과입니다(물론 서로 강하게 의존하는 예시들입니다). 테스트할 때는 네 모서리와 중앙에서 자른 패치 5장과 그 반전본 5장, 모두 10장의 softmax 출력을 평균했습니다. 증강 이미지는 GPU가 이전 배치를 학습하는 동안 CPU의 Python 코드가 만들었으므로 계산 비용은 사실상 0이었습니다.
데이터 증강 2: PCA 색상 변형. ImageNet 학습셋 전체의 RGB 픽셀에 PCA를 돌려 \(3 \times 3\) 공분산 행렬의 고유벡터 \(\mathbf{p}_i\)와 고유값 \(\lambda_i\)를 구합니다. 각 픽셀 \(I_{xy}\)에 다음 값을 더합니다.
\[[\mathbf{p}_1, \mathbf{p}_2, \mathbf{p}_3]\,[\alpha_1 \lambda_1,\ \alpha_2 \lambda_2,\ \alpha_3 \lambda_3]^{T}, \qquad \alpha_i \sim \mathcal{N}(0,\, 0.1^2)\]
\(\alpha_i\)는 이미지 한 장에 한 번 뽑고, 그 이미지가 다시 학습에 쓰일 때 새로 뽑습니다. 조명의 세기와 색이 바뀌어도 물체의 정체는 그대로라는 자연 이미지의 성질을 흉내 낸 것입니다. 이 기법으로 top-1 오류가 1%p 넘게 줄었습니다.
Dropout. 여러 모델의 예측을 합치면 테스트 오류가 줄지만, 학습에 며칠씩 걸리는 큰 신경망으로는 감당하기 어렵습니다. Dropout은 각 은닉 뉴런의 출력을 확률 0.5로 0으로 만듭니다. 입력이 들어올 때마다 가중치를 공유하는 다른 구조를 샘플링하는 셈입니다. 테스트 때는 모든 뉴런을 쓰되 출력에 0.5를 곱합니다. 이 논문은 fc6과 fc7에만 적용했고, 같은 해 공개된 Hinton et al. (2012)의 기법을 대규모로 처음 검증한 사례이기도 합니다. Dropout이 없으면 과적합이 심했고, 있으면 수렴까지 반복 횟수가 약 2배로 늘었습니다.
학습
SGD를 배치 128, 모멘텀 0.9, weight decay 0.0005로 돌렸습니다. 반복 인덱스를 \(i\), 모멘텀 변수를 \(v\), 학습률을 \(\epsilon\), \(i\)번째 배치 \(D_i\)에서의 평균 기울기를 \(\langle \cdot \rangle_{D_i}\)로 두면 업데이트 규칙은 다음과 같습니다.
\[\begin{aligned} v_{i+1} &:= 0.9\, v_i - 0.0005\, \epsilon\, w_i - \epsilon \left\langle \frac{\partial L}{\partial w} \Big|_{w_i} \right\rangle_{D_i} \\ w_{i+1} &:= w_i + v_{i+1} \end{aligned}\]
눈여겨볼 부분은 weight decay에 대한 언급입니다. 저자들은 이 작은 weight decay가 단순한 정규화가 아니라 학습 오류 자체를 낮췄다고 적었습니다.
가중치는 표준편차 0.01의 가우시안으로 초기화했습니다. conv2, conv4, conv5와 완전 연결 은닉층의 편향은 1로 두었는데, ReLU에 처음부터 양수 입력을 줘서 초기 학습을 빠르게 하려는 의도입니다. 학습률은 0.01에서 시작해 검증 오류가 멈출 때마다 손으로 10분의 1로 줄였고, 끝날 때까지 세 번 줄였습니다. 120만 장을 약 90바퀴 도는 데 GTX 580 두 장으로 5~6일이 걸렸습니다.
결과
ILSVRC-2010 테스트셋 결과입니다.
| 모델 | Top-1 오류 (%) | Top-5 오류 (%) |
|---|---|---|
| Sparse coding (2010 대회 1위) | 47.1 | 28.2 |
| SIFT + Fisher Vectors (이후 최고 기록) | 45.7 | 25.7 |
| CNN (이 논문) | 37.5 | 17.0 |
기존 최고 기록 대비 top-1은 8.2%p, top-5는 8.7%p 낮습니다. 10패치 평균을 빼도 39.0% / 18.3%라서 기존 기록을 크게 앞섭니다.
ILSVRC-2012 결과는 다음과 같습니다. 2012는 테스트 라벨이 비공개라 검증 오류 위주로 보고했고, 저자들은 두 값의 차이가 0.1%p 이내였다고 밝힙니다.
| 모델 | Top-1 val (%) | Top-5 val (%) | Top-5 test (%) |
|---|---|---|---|
| SIFT + FVs (2위 팀) | - | - | 26.2 |
| CNN 1개 | 40.7 | 18.2 | - |
| CNN 5개 평균 | 38.1 | 16.4 | 16.4 |
| CNN 1개* | 39.0 | 16.6 | - |
| CNN 7개 평균* | 36.7 | 15.4 | 15.3 |
* ImageNet Fall 2011 전체(1,500만 장, 22,000개 범주)로 사전학습한 뒤 ILSVRC-2012로 파인튜닝한 모델. 마지막 풀링층 위에 6번째 합성곱층을 더 얹었습니다.
여기서 흔히 놓치는 사실이 있습니다. 대회 우승 기록 15.3%는 논문 본문의 단일 모델이 아니라 7개 CNN 앙상블의 결과이고, 그중 2개는 더 큰 데이터로 사전학습한 모델입니다. 단일 모델만 봐도 18.2%로 2위 팀(26.2%)을 8%p 앞서므로 결론은 달라지지 않습니다. 다만 "사전학습 후 파인튜닝"이라는 이후의 표준 레시피가 이미 이 표에 들어 있다는 점은 기억할 만합니다.
ImageNet Fall 2009(10,184개 범주, 890만 장)에서도 top-1 67.4%, top-5 40.9%를 기록해 기존 최고(78.1%, 60.9%)를 크게 앞섰습니다.
구성 요소별 기여
논문 곳곳에 흩어진 절제 결과를 모으면 다음과 같습니다.
| 구성 요소 | 비교 대상 | Top-1 개선 (%p) | Top-5 개선 (%p) |
|---|---|---|---|
| 2-GPU 분할 | 커널 절반인 1-GPU 넷 | 1.7 | 1.2 |
| LRN | 정규화 없음 | 1.4 | 1.2 |
| 겹치는 풀링 | \(s=z=2\) | 0.4 | 0.3 |
| PCA 색상 증강 | 증강 없음 | 1 이상 | - |
| 10패치 테스트 평균 | 중앙 패치 1장 | 1.5 | 1.3 |
| 중간 합성곱층 유지 | 하나 제거 | 약 2 | - |
ReLU와 Dropout은 같은 형식의 수치가 없습니다. ReLU는 학습 속도(CIFAR-10에서 6배)로, Dropout은 "없으면 과적합이 심하다"는 정성적 서술로만 효과를 보였습니다.
네트워크가 본 것
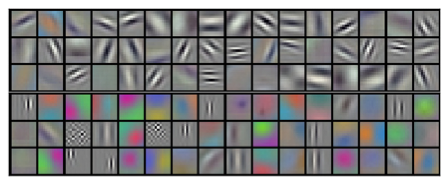
conv1이 학습한 96개 커널입니다. 위 48개는 GPU 1, 아래 48개는 GPU 2에서 학습했습니다. GPU 1의 커널은 대부분 색과 무관한 방향·주파수 검출기이고, GPU 2의 커널은 대부분 색 덩어리입니다. 연결을 제한한 구조 때문에 생긴 분업이고, 저자들은 이 분업이 초기화와 상관없이 매번 나타났다고 보고합니다.
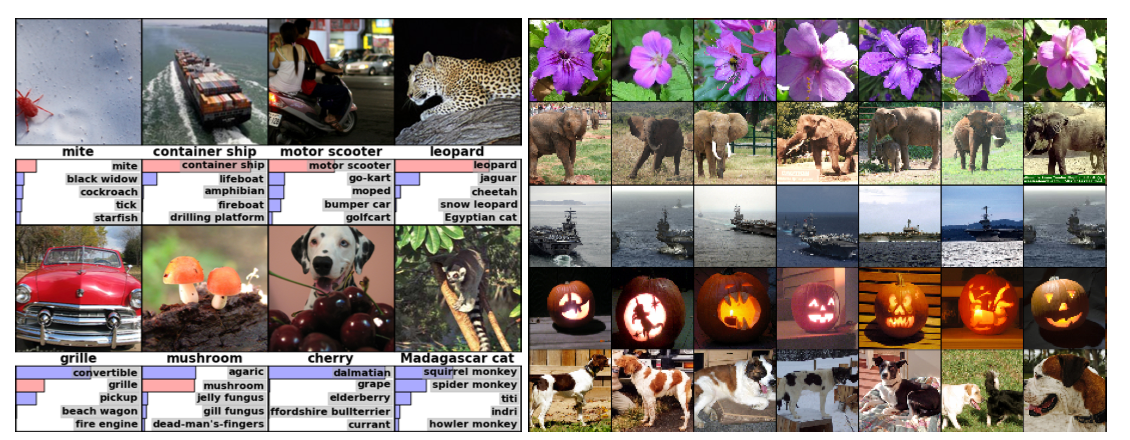
왼쪽은 테스트 이미지의 top-5 예측입니다. 표범에 대해서는 다른 고양잇과 동물만 후보로 올리고, 중앙에서 벗어난 진드기도 잡아냅니다. 오른쪽이 더 중요합니다. 마지막 4,096차원 은닉층에서 유클리드 거리가 가장 가까운 학습 이미지를 찾았더니, 픽셀 수준으로는 전혀 닮지 않은 다양한 자세의 코끼리와 개가 나왔습니다. 마지막 층의 벡터가 의미 공간이라는 관찰이고, 이후 "CNN 특징을 뽑아 다른 과제에 쓰는" 전이학습과 임베딩 검색의 출발점이 되었습니다.
회고
규모에 대한 예언. 서론의 마지막 문장은 "모든 실험 결과는 더 빠른 GPU와 더 큰 데이터셋을 기다리기만 해도 결과가 좋아질 수 있음을 시사한다"입니다. 결론에서도 네트워크를 키우고 오래 학습할수록 결과가 좋아졌다고 적습니다. 10년 뒤 스케일링 법칙으로 정식화될 직관이 2012년 논문에 이미 들어 있습니다.
비지도 사전학습을 쓰지 않은 이유. 2006년 이후 힌턴 연구실의 간판은 DBN 기반 비지도 사전학습이었습니다. 그런데 이 논문은 "실험을 단순화하기 위해" 비지도 사전학습을 쓰지 않았고, 순수 지도 학습만으로 기록을 냈습니다. 저자들은 사전학습이 도움이 될 것이라고 예상했지만, 실제 역사는 라벨 데이터와 연산을 늘리는 쪽으로 흘렀습니다. 힌턴 연구실이 자기 간판 기법을 스스로 밀어낸 논문인 셈입니다.
저자들이 인정한 편향. 2-GPU와 1-GPU 비교에는 각주가 붙어 있습니다. 1-GPU 넷의 마지막 합성곱층과 완전 연결층은 절반으로 줄이지 않았으므로 비교가 1-GPU 쪽에 유리하다는 내용입니다. 반대로 LRN과 겹치는 풀링의 개선폭은 단일 실행 기준이고 분산이 보고되지 않았습니다. 0.3~0.4%p 수준의 차이는 시드 차이와 구분하기 어렵습니다.
살아남은 것과 사라진 것. ReLU, Dropout, 데이터 증강, GPU 학습, 사전학습 후 파인튜닝은 표준이 되었습니다. LRN은 2014년 VGGNet이 효과가 없다고 보고한 뒤 사라졌고, 이후 Batch Normalization이 그 자리를 차지했습니다. 11×11 큰 커널은 3×3 커널을 쌓는 방식으로, 6,000만 파라미터의 대부분을 차지하던 완전 연결층은 global average pooling으로 대체되었습니다. GPU 메모리 때문에 생긴 2-GPU 분할은 훗날 grouped convolution(ResNeXt)이라는 이름으로 다시 등장합니다.
224와 227. 논문은 입력을 \(224 \times 224\)라고 적었지만, stride 4인 \(11 \times 11\) 커널을 그대로 적용하면 \((224-11)/4+1 = 54.25\)로 나누어떨어지지 않습니다. 그림 2의 conv1 출력 55와 맞추려면 입력이 \(227 \times 227\)이어야 합니다. 그래서 대부분의 재구현은 227을 씁니다. 학습률을 사람이 직접 조정했다는 점까지 더하면, 이 논문은 깔끔한 이론보다 엔지니어링과 감각으로 만든 결과물에 가깝습니다.
코드 공개. cuda-convnet은 당시에도 공개되었지만, 대회에 쓴 원본 코드는 Google의 DNNresearch 인수와 함께 묶여 있었습니다. 컴퓨터 역사 박물관(CHM)이 Google과 5년간 협상한 끝에 2025년 3월 원본 소스 코드를 공개했습니다.
정리
- 손으로 설계한 특징 없이 원시 픽셀에서 학습한 대형 CNN이 ImageNet에서 기존 최고 기록보다 top-5 오류를 약 9~11%p 낮췄습니다.
- 핵심은 개별 기법보다 조합에 있습니다. ImageNet 규모의 데이터, GPU 두 장, ReLU로 확보한 학습 속도, 증강과 Dropout으로 억제한 과적합이 처음으로 한 시스템에 모였습니다.
- 마지막 층 특징으로 이미지를 검색하는 실험, 사전학습 후 파인튜닝, "더 큰 GPU와 데이터면 더 좋아진다"는 관찰까지, 이후 10년의 딥러닝 흐름이 이 9쪽짜리 논문에 거의 다 들어 있습니다.
후속 연구 링크
이 논문의 한계는 Hinton의 이후 연구에서 다루어졌습니다:
- 과적합 문제 → Dropout - A Simple Way to Prevent Neural Networks from Overfitting: Dropout의 체계적 분석과 다양한 분야에서의 검증을 수행했습니다
- 모델 배포 어려움 → Distilling the Knowledge in a Neural Network: 지식 증류로 큰 모델을 작은 모델로 압축하는 방법을 제안했습니다