Qwen-UI-Agent Technical Report - Toward Next-Generation Real-World Centric Foundation GUI Agents
H. Zhou, P. Tong, X. Zhang, Q. Kong, et al., "Qwen-UI-Agent Technical Report: Toward Next-Generation Real-World Centric Foundation GUI Agents," arXiv:2607.28227, 2026.
그동안 GUI 에이전트는 많이 발전했지만, 한계도 여실히 드러났습니다. 벤치마크 성공률은 계속 오르는데, 실제로는 광고 팝업 하나에 무너집니다. Qwen-UI-Agent는 이 간극을 모델 문제가 아니라 환경 문제로 바라봅니다. 100대가 넘는 물리 단말을 학습 인프라로 세우는 쪽을 택했습니다.

저자
Alibaba Token Hub 산하 MAI-UI 팀의 작업입니다. 2025년 말에 나온 MAI-UI의 직계 후속작이라고 리포트 첫 페이지 각주에 명시돼 있습니다.
Hanzhang Zhou와 Panrong Tong, Xu Zhang이 공동 1저자이자 프로젝트 공동 리더이고, Yue Wang이 프로젝트 리더, Steven Hoi가 마지막에 이름을 올립니다. Core Contributors 16명에 Contributors 11명, 총 27명이 참여했습니다.
인물 구성이 이 리포트의 성격을 그대로 설명합니다. 저우한장은 MAI-UI에서도 같은 자리에 있었고, 두 리포트를 잇는 축입니다. 퉁판룽은 난양이공대에서 모바일 센싱으로 박사를 받고 Alibaba Cloud에 합류한 사람인데, 100대 단말과 150개 앱을 다루는 런타임은 모델링 문제가 아니라 분산 시스템 문제라서 이런 배경이 필요합니다. Quyu Kong은 이 리포트가 평가와 학습 양쪽에서 쓰는 MobileWorld 벤치마크의 1저자입니다. 자기가 만든 벤치마크를 학습 인프라의 기반으로 다시 쓴 셈입니다.
스티븐 호이는 Salesforce Research Asia를 세우고 BLIP을 냈던 사람이고, 지금은 Alibaba 부사장으로 Token Hub 산하 멀티모달 에이전트 연구를 총괄합니다. 왕웨가 그 그룹 안에서 실무 팀을 이끕니다.
배경
GUI 에이전트는 매력이 있습니다. 모든 서비스가 API를 열지 않아도 사람이 쓰는 화면을 그대로 조작하면 되니까, 기존 애플리케이션 생태계 전체가 곧 실행 표면이 됩니다.
문제는 지금까지의 GUI 에이전트가 대부분 시뮬레이션 벤치마크에 맞춰 최적화됐다는 점입니다. 리포트는 여섯 가지 전환을 제시하며 시작합니다. 시뮬레이션에서 실기기로, 단일 도메인에서 크로스 플랫폼 워크플로로, GUI 전용 액션에서 GUI+CLI 하이브리드와 배치 액션으로, 단기 태스크에서 장기 태스크로, 사람이 손으로 돌리는 학습 파이프라인에서 AutoResearch 방식으로, 반응형 실행에서 선제적 서비스 개시로.
여기서 첫 번째 숫자 문제가 나옵니다. 도입부는 "여섯 가지 핵심 전환"을 나열해 놓고, 바로 다음 문단에서 "이 다섯 가지 전환을 중심으로 개발했다"고 씁니다. 실제로 나열된 항목은 여섯 개이므로 본문 목록이 정본입니다. preprint에서 자주 나오는 종류의 불일치라 크게 문제 삼을 건 아니지만, 숫자를 인용할 때는 여섯 개로 세는 편이 안전합니다.
전환 목록보다 중요한 것은 §4.1의 실패 분석입니다. 팀은 Qwen 3.7 Plus가 실기기에서 실패한 궤적을 전수 검토해 원인을 분류했습니다.
차원 |
실패 패턴 |
비중 (%) |
전형적 행동 |
|---|---|---|---|
실행 능력 한계 (40.3) |
탐색 실패 |
19.5 |
앱 깊은 곳의 진입점을 못 찾음 |
오류 액션 루프 |
14.3 |
효과 없는 액션을 반복 |
|
실행 상태 상실 |
6.5 |
끝낸 하위 태스크를 잊음 |
|
실세계 시나리오 (52.0) |
UI 오독 |
24.7 |
상태를 가진 페이지 의미를 잘못 읽음 |
팝업 간섭 |
18.2 |
광고, 페이월, CAPTCHA, 빈 페이지 |
|
물리 위젯 제어 |
9.1 |
목표를 지나쳐 수렴하지 않음 |
|
기타 |
7.7 |
미완 실행, 조기 종료 |
절반이 넘는 52.0%가 시뮬레이터가 재현하지 않는 실세계 조건에서 발생합니다. 세부 항목이 특히 구체적입니다. UI 오독의 대표 사례는 회색 플레이스홀더 힌트를 사용자가 입력한 텍스트로 착각해서, 그 위에 그냥 타이핑하면 될 것을 계속 지우려 드는 행동입니다. 물리 위젯 제어는 스크롤 휠이나 날짜 선택기처럼 값을 보면서 스와이프 강도를 조절해야 하는 컨트롤에서 나오는데, 시뮬레이터에서는 이런 값이 보통 텍스트 주입이나 단일 탭으로 설정되기 때문에 모델이 고정 강도 스와이프만 배웁니다. 그래서 양방향으로 목표를 계속 지나칩니다.
이 표가 이 논문의 출발점입니다. "실기기가 어렵다"는 막연한 진술이 아니라, 무엇이 어떤 비중으로 어렵고 그게 왜 시뮬레이션 학습의 부산물인지를 분해해 놓았고, 인프라 설계가 여기서 역산됩니다.
어떻게 만들었나
시스템은 네 부분입니다. 환경 인프라, 데이터 플라이휠, 학습 프레임워크, 하네스 레이어.
액션 공간
태스크를 \(\tau = (I, E_\tau)\)로 정의합니다. \(I\)는 사용자 지시, \(E_\tau\)는 이 태스크가 쓸 수 있는 환경 집합으로 모바일, 브라우저, 컴퓨터, DeepSearch가 들어갑니다.
결정 단계 \(t\)에서 관측은 세 채널을 묶습니다.
\[o_t = \left( o_t^{\text{GUI}},\ o_t^{\text{CLI}},\ o_t^{\text{API}} \right)\]
\(o_t^{\text{GUI}}\)는 현재 스크린샷, \(o_t^{\text{CLI}}\)는 명령 실행 결과, \(o_t^{\text{API}}\)는 검색 API 같은 외부 서비스의 구조화된 응답입니다. 해당 채널이 없거나 필요 없으면 비워 둡니다. 정책은 추론 \(r_t\)와 액션 \(a_t\)를 함께 냅니다.
\[(r_t,\ a_t) = \pi_\theta ( I,\ o_t,\ h_t )\]
여기서 \(h_t = (o_1, r_1, a_1, \dots, o_{t-1}, r_{t-1}, a_{t-1})\)은 이전 상호작용 이력입니다.
배치 액션이 들어오는 곳이 그다음입니다. 한 번의 모델 결정이 액션 하나가 아니라 순서 있는 액션 열을 낼 수 있습니다.
\[a_t = \left( a_t^{(1)}, \dots, a_t^{(K_t)} \right), \quad a_t^{(k)} \in A_t\]
\(K_t = 1\)이면 단일 액션 실행이고, \(K_t > 1\)이면 배치입니다. 배치 안의 액션들은 같은 결정 단계에서 연속 실행됩니다. 추가 환경 피드백 없이 끝낼 수 있는 연산이 여러 개일 때 관측과 추론 사이클을 줄이는 장치입니다.
액션 목록 자체는 단순합니다. GUI 쪽은 click, double_click, long_press, type, open, drag, system_button, wait. 여기에 cli_command(bash 실행)와 api_call이 붙고, 마지막으로 ask_user와 terminate가 있습니다.
ask_user가 장식이 아니라는 점이 중요합니다. 결제나 민감 데이터 처리처럼 되돌리기 어려운 조작 앞에서 모델이 사용자에게 확인을 요청하도록 학습 시나리오에 넣었습니다. 실기기에서 CAPTCHA나 로그인이 걸리면 사용자에게 제어를 넘기는 takeover 경로도 런타임에 들어가 있습니다.
왜 GUI와 CLI를 섞는가
이 결정이 이 논문에서 가장 흥미로운 지점입니다.
GUI는 시각 인터페이스에 보편적으로 접근할 수 있지만, 구조화된 연산을 그라운딩과 클릭과 타이핑의 긴 열로 바꿔 놓습니다. CLI는 파일과 코드와 시스템 설정에 프로그래밍 방식으로 직접 접근하지만, 시각 이해에 의존하거나 프로그래밍 접근이 없는 서비스에는 못 씁니다. 둘은 같은 일을 다른 방식으로 하는 게 아니라 서로 다른 접근 표면입니다.
구현에서 눈여겨볼 부분은 CLI가 GUI를 통해 나가지 않는다는 점입니다. 컴퓨터 환경에서 cli_command는 화면에서 터미널 앱을 찾아 클릭하고 타이핑하는 대신, VM 안의 경량 실행 서비스가 비대화형 셸에서 바로 돌립니다. stdout, stderr, 종료 코드가 액션 직후 스크린샷과 함께 구조화된 관측으로 돌아옵니다. 명령 실패는 에피소드를 중단시키지 않고 에러 관측으로 반환되므로 모델이 같은 궤적 안에서 진단하고 복구할 수 있습니다. 실행된 명령은 셸 히스토리에 기록돼서, 터미널 상태를 검사하는 검증기가 CLI 기반 해법도 인정합니다.
실기기 런타임
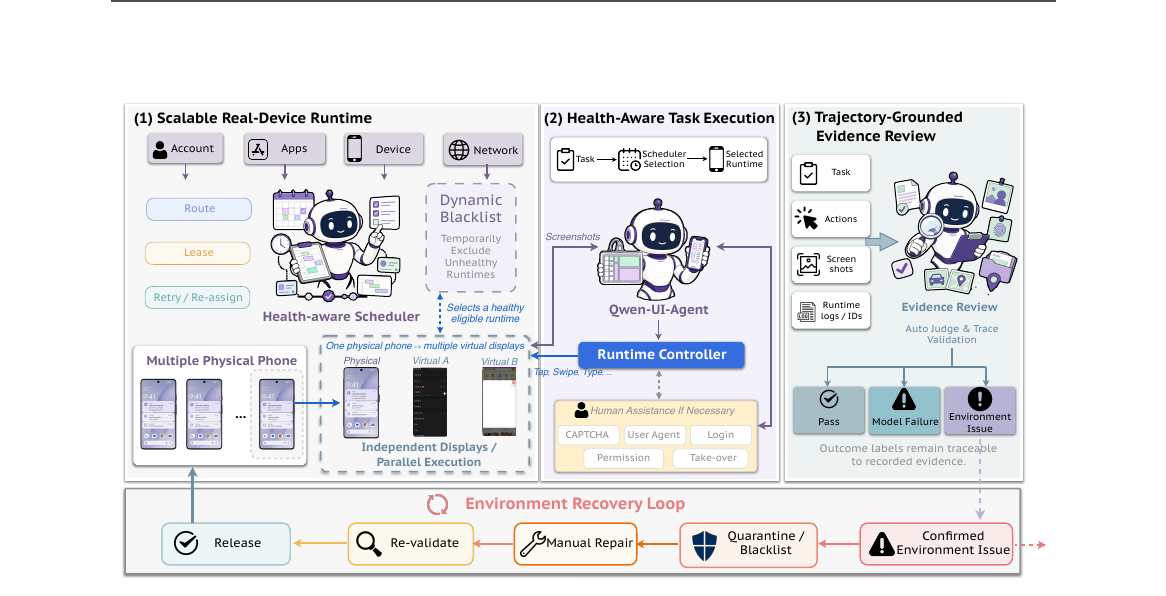
100대 넘는 물리 단말과 150개 이상 앱으로 구성됩니다. 이 규모에서는 "태스크에 쓸 만한 기기를 배정하는 것" 자체가 시스템 문제가 됩니다.
헬스 어웨어 스케줄러가 기기, 애플리케이션, 계정, 네트워크, 디스플레이 각각의 상태와 가용성을 추적합니다. 태스크가 큐에 들어오면 적합한 실행 대상을 골라 리소스를 리스로 빌려주고, 실패하면 다른 대상으로 재라우팅합니다. 상태가 나쁜 기기는 동적 블랙리스트에 올려 라우팅에서 빼고, 사람이 점검한 뒤에야 복귀시킵니다.
처리량은 가상 디스플레이로 늘립니다. 폰 한 대가 여러 애플리케이션 세션을 서로 다른 디스플레이에 동시에 올릴 수 있고, 런타임 컨트롤러가 각 가상 디스플레이를 해당 에이전트 세션에 묶어 관측과 액션이 엇갈리지 않게 합니다. 이 장치 하나로 실기기 클러스터의 롤아웃 처리량이 약 20배 늘었다고 보고합니다.
실기기 런타임에서 가장 까다로운 문제는 모델 실패와 환경 실패를 구분하는 일입니다. 앱 제한, 서비스 장애, 불안정한 기기, 네트워크 오류는 모델 판단이 옳아도 궤적을 끊습니다. VLM 판정기가 전체 궤적을 검사해 성공, 모델 실패, 환경 실패 셋으로 가릅니다. 확인된 환경 실패는 스케줄러와 정비 큐로 되돌아가고, 검증된 궤적만 학습에 남습니다.
샌드박스 쪽도 언급할 만합니다. 모바일 샌드박스는 MobileWorld 환경을 기반으로 하는데, KVM 기반 에뮬레이터의 확장 병목을 피하려고 redroid 위에 다시 올렸습니다. QEMU나 중첩 KVM 없이 안드로이드를 호스트 커널 위 컨테이너로 돌리는 방식이라, 평범한 컨테이너 호스트에서 기기와 백엔드를 통째로 복제할 수 있습니다. 이 재구축이 1만 개 동시 샌드박스의 전제입니다.
데이터 플라이휠
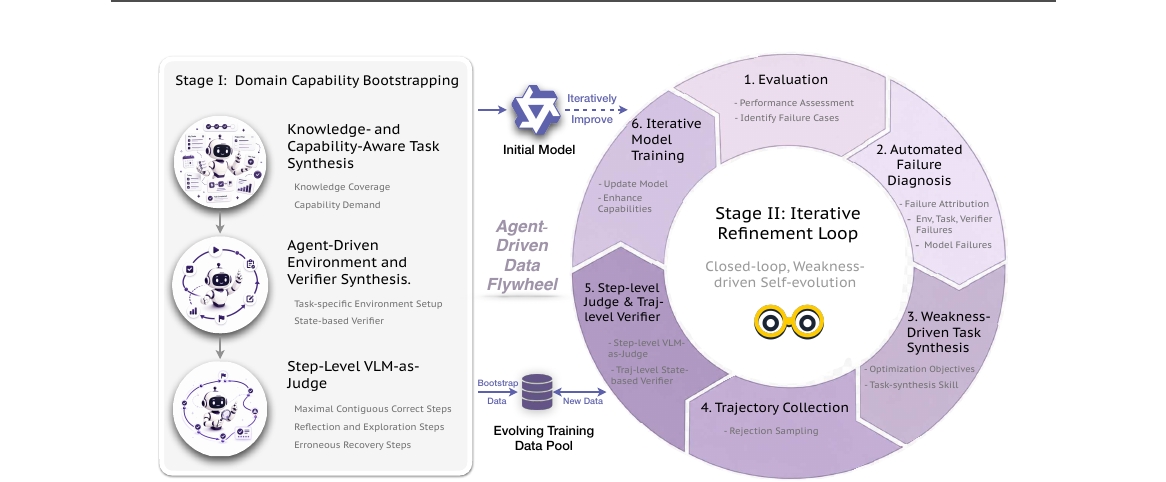
두 단계로 나뉩니다. 도메인 능력 부트스트래핑과 반복 개선 루프.
부트스트래핑에서는 강한 파운데이션 모델이 도메인에 필요한 지식과 능력을 분석하고, 그에 따라 초기 태스크 풀과 환경 컨텍스트를 만듭니다. 여러 라운드의 rejection sampling을 거쳐 통과한 궤적을 SFT 코퍼스로 모읍니다.
이후 루프가 돕니다. 실패 분석 에이전트가 남은 약점을 찾아 다음 사이클의 목표로 매핑하고, 그 목표에 맞춰 새 태스크와 환경 설정과 검증기를 만듭니다. 사람은 시스템을 설계하고 감독하고 필요할 때 개입하는 역할로 물러납니다.
태스크 합성을 두 축으로 나눈 게 이 설계의 핵심입니다. 지식 커버리지는 에이전트가 무엇을 알아야 하는지(앱 기능, 인터페이스 관습, 툴 사용법, 일반적 워크플로), 능력 요구는 에이전트가 어떻게 추론하고 행동해야 하는지(장기 상태 추적, 제약 준수, 수치·시간 추론, 오류 복구)를 담당합니다. 도메인마다 계층적 기능 트리와 능력 프로필을 만들고, 이를 조합 규칙과 난이도 제어와 환경 전제조건을 담은 재사용 가능한 태스크 합성 스킬로 컴파일합니다.
검증 신호는 용도에 따라 나눠 씁니다. 실행 가능한 검증기는 정확도가 높지만 만들고 검증하는 비용이 큽니다. 반면 모델 기반 판정기의 정확도는 모델이 좋아질수록 함께 좋아집니다. 그래서 SFT용 프로세스 감독은 VLM 판정기로 스케일하고, 온라인 RL이 요구하는 고정밀 결과 신호에만 실행 가능한 검증기를 씁니다. 판정기는 궤적에서 세 가지를 뽑습니다. 태스크를 올바르게 진전시킨 최대 연속 구간, 각 반성·탐색 구간을 시작하는 첫 스텝, 오류 상태에서 정상 경로로 돌아오는 복구 구간. 반성 구간에서 첫 스텝만 남기는 이유는 재고하겠다는 판단 자체는 유용하지만 그 뒤 가지는 노이즈일 수 있어서입니다. 팀은 이 방식의 스텝 단위 필터링이 실행 검증기로 고른 완전 궤적 학습과 대등하거나 낫다고 보고합니다.
학습
SFT, Action RL, Online RL 세 단계입니다.
SFT는 도메인별 전문가를 따로 학습한 뒤 체크포인트를 병합합니다. 각 전문가는 자기 도메인 데이터를 주로 쓰되 다른 도메인 데이터를 통제된 비율로 섞어 과적합을 줄입니다.
일반 능력 보존에서 나온 관찰이 실무적으로 유용합니다. 팀은 시작 모델이 이미 풀 수 있는 예제로 학습하는 쪽이, 시작 모델이 틀리는 어려운 예제보다 능력 보존에 훨씬 효과적이라고 보고합니다. 전자는 모델 자신의 응답 분포에 정렬된 타깃으로 기존 능력을 복습시키는 반면, 후자는 학습을 능력 습득 쪽으로 밀면서 경쟁하는 최적화 신호를 만들기 때문입니다.
긴 궤적 SFT는 슬라이딩 윈도로 처리합니다. 궤적을 연속 \(n = 5\) 스텝 윈도로 자르고 \(n - 1 = 4\) 스텝씩 전진시켜 인접 윈도가 한 스텝 겹치게 합니다. 겹친 경계 스텝은 입력 컨텍스트에 남지만 앞 윈도에서 이미 감독됐으므로 손실은 마스킹합니다. 현재 윈도 이전 스크린샷은 시각 입력에서 빼고 텍스트 이력만 남깁니다.
Action RL은 반복되는 액션 오류를 잡습니다. 팀은 여섯 가지 패턴을 정리했습니다. 혼동되는 요소 그라운딩, 정렬·순위, 수량과 다중 타깃 완결성, 조기 완료, 반복 액션 루프, 롱테일 액션 선택 실패. 마지막 항목은 open이나 ask_user, long_press 같이 드물지만 결정적인 액션을 못 부르고 click으로 때우는 실패입니다. 이 패턴들은 자연 수집 궤적에서의 빈도가 중요도를 반영하지 않기 때문에, 과거 궤적 마이닝과 능동적 환경 탐색을 섞어 일부러 비중을 키운 코퍼스를 만듭니다.
보상은 스텝 단위로 매깁니다.
\[r_t = F_t \left( w_{\text{type}} C_t + w_{\text{arg}} C_t Q_t - \lambda_{\text{sens}} S_t - \lambda_{\text{rep}} L_t \right)\]
\(F_t \in \{0, 1\}\)은 형식 유효성, \(C_t\)는 액션 타입 정확도, \(Q_t\)는 픽셀 거리와 어휘 유사도, 태그 일치, LLM 판정으로 재는 인자 품질입니다. \(S_t\)와 \(L_t\)은 각각 잘못된 민감 액션과 액션 이력 내 반복에 대한 페널티입니다. 학습 중 토큰 엔트로피가 떨어지고 추론이 짧아지는 현상이 관측돼, 엔트로피 정규화와 추론 길이 상하한을 함께 걸었습니다.
Online RL은 GRPO 변형입니다. 각 태스크에 대해 현재 정책이 \(K\)개의 완전한 궤적 \(\{\tau_i\}_{i=1}^{K}\)를 샘플링하고, 검증기가 최종 환경 상태를 평가합니다.
\[r_i = v_x\left(s_{\text{final}}^{(i)}\right) \in \{0, 1\}, \quad \bar{r}_x = \frac{1}{K}\sum_{j=1}^{K} r_j, \quad \hat{A}_i = \frac{r_i - \bar{r}_x}{\mathrm{Std}(r_1, \dots, r_K) + \epsilon}\]
여기에 모델 적응형 커리큘럼을 얹었습니다. 그룹 상대 목적함수에서는 롤아웃이 전부 실패하거나 전부 성공하는 태스크가 보상 변동을 만들지 못해 학습 신호가 거의 없습니다. 그렇다고 어려운 태스크를 영구 제거하면 그것이 정책의 학습 경계로 들어오는 시점을 놓칩니다. 그래서 태스크 난이도를 정책의 현재 상태에 따라 변하는 성질로 보고, 중간 성공률 태스크는 활성 풀에 넣어 롤아웃 예산을 전부 주고, 아직 못 푸는 태스크는 감시 풀에 작은 예산으로 남깁니다. 감시 중이던 태스크가 성공 롤아웃을 내기 시작하면 활성 풀로 승격하고, 숙달된 태스크도 작은 예산으로 감시하다가 성능이 떨어지면 되살립니다.
온라인 RL용 태스크-검증기 쌍은 자동 합성으로 약 1만 개를 만들었습니다. 이 중 환경 상태 합성 단계가 눈여겨볼 만합니다. 코딩 에이전트가 각 샌드박스의 코드베이스를 분석해 재사용 가능한 데이터 주입 스킬을 뽑아내고, 그 스킬로 여러 앱에 걸쳐 일관된 초기 상태를 만듭니다. 논문이 든 예시는 논문 투고를 준비하는 전산학 박사과정생인데, 이 사람의 폰 안에 서로 아귀가 맞는 이메일과 사진과 파일과 캘린더 일정과 SNS 기록이 깔립니다. 벤치마크가 제공하는 상태에서 태스크를 만들면 합성이 그 상태에 갇히기 때문에, 상태부터 합성한다는 논리입니다.
결과
주력 모델은 27B입니다. 35B-A3B와 4B 변형도 있습니다.
모바일
모델 |
접근/크기 |
MobileWorld (%) |
MobileWorld-Real (%) |
AndroidDaily (%) |
|---|---|---|---|---|
Qwen-UI-Agent |
27B |
82.1 |
92.2 |
97.5 |
Qwen-UI-Agent |
35B-A3B |
65.0 |
87.4 |
93.9 |
Seed 2.1 Pro |
Closed |
73.2 |
88.7 |
95.2 |
GPT-5.6 Sol |
Closed |
70.1 |
85.4 |
92.6 |
Claude Opus 4.8 |
Closed |
67.5 |
84.7 |
93.0 |
Gemini 3.1 Pro |
Closed |
58.1 |
86.2 |
93.8 |
Qwen 3.7 Plus |
Closed |
62.3 |
72.7 |
79.8 |
Kimi K2.6 |
1T-A32B |
55.6 |
62.6 |
67.6 |
GUI-Owl-1.5-32B-Instruct |
32B |
43.9 |
32.4 |
60.9 |
MAI-UI-235B-A22B |
235B-A22B |
39.7 |
||
UI-Venus-1.5-30B-A3B |
30B-A3B |
17.1 |
33.0 |
61.7 |
MobileWorld는 GUI 전용 부분집합 117개 태스크, 50스텝 예산 기준입니다. 스텝 상한을 100으로 올리면 27B가 85.5%, 35B-A3B가 68.4%로 더 오릅니다.
세 열을 나란히 놓으면 이 논문의 논지가 표 하나로 보입니다. 프런티어 폐쇄형 모델들은 MobileWorld-Real에서 84~89%로 몰려 있고 Qwen-UI-Agent가 92.2%로 그 위에 있습니다. 반면 전작 MAI-UI-235B-A22B는 시뮬레이션 MobileWorld에서 39.7%에 그칩니다. 235B가 27B에게 42.4%p 뒤진다는 뜻인데, 파라미터가 아니라 학습 환경이 결정한다는 주장을 팀이 자기 이전 모델로 증명한 모양새입니다.
또 하나 눈에 띄는 것은 GUI 특화 모델들의 격차입니다. GUI-Owl-1.5-32B는 시뮬레이션 MobileWorld에서 43.9%인데 실기기 MobileWorld-Real에서는 32.4%로 떨어집니다. 반대로 GELab-Zero-4B-preview는 MobileWorld-Real 31.3%인데 AndroidDaily에서는 73.4%입니다. 벤치마크마다 재는 것이 다르다는 신호이므로, 단일 숫자로 순위를 말하기 어렵습니다.
컴퓨터
모델 |
접근/크기 |
OSWorld-Verified (%) |
|---|---|---|
Claude Opus 4.8 |
Closed |
83.4 |
Qwen-UI-Agent |
27B |
79.5 |
Seed 2.1 Pro |
Closed |
78.8 |
GPT-5.5 |
Closed |
78.7 |
Gemini 3.5 Flash |
Closed |
78.4 |
Gemini 3.1 Pro |
Closed |
76.2 |
MiniMax M3 |
428B-A23B |
75.2 |
Qwen 3.7 Plus |
Closed |
73.3 |
Kimi K2.6 |
1T-A32B |
73.1 |
GUI-Owl-1.5-32B-Instruct |
32B |
56.5 |
모델 |
OSWorld-v2 Partial (%) |
Binary (%) |
스텝/태스크 |
액션 모드 |
|---|---|---|---|---|
Claude Opus 4.8 |
54.8 |
20.6 |
103.0 |
Batched |
GPT-5.5 |
49.5 |
13.0 |
95.2 |
Batched |
Qwen-UI-Agent |
40.0 |
13.9 |
135.8 |
Batched |
MiniMax M3 |
22.3 |
4.6 |
326.7 |
Single |
Kimi K2.6 |
22.1 |
4.6 |
179.3 |
Single |
Qwen 3.7 Plus |
21.5 |
2.8 |
173.5 |
Single |
OSWorld-v2 표에서 액션 모드 열을 함께 봐야 합니다. Batched를 쓰는 세 모델이 스텝 수 95~136에 몰려 있고, Single을 쓰는 세 모델은 173~327입니다. Qwen-UI-Agent는 MiniMax M3 대비 partial을 17.7%p 올리면서 스텝은 58.4% 줄였습니다. 배치 액션이 성능과 효율 양쪽에 걸린 설계라는 주장의 근거입니다.
다만 정직하게 적어야 할 부분이 있습니다. OSWorld-v2에서 Qwen-UI-Agent는 GPT-5.5보다 binary는 0.9%p 앞서지만 partial은 9.5%p 뒤집니다. Opus 4.8과는 partial 14.8%p, binary 6.7%p 차이입니다. 초록이 "프런티어 모델과 경쟁적"이라고 쓴 것은 이 범위 안에서의 이야기입니다.
브라우저와 그라운딩
모델 |
접근/크기 |
WebArena (%) |
|---|---|---|
Human |
78.2 |
|
Qwen-UI-Agent |
27B |
73.6 |
Claude Opus 4.8 |
Closed |
71.9 |
GPT-5.5 |
Closed |
69.5 |
Qwen-UI-Agent |
35B-A3B |
69.2 |
Gemini 3.1 Pro |
Closed |
65.3 |
Qwen 3.7 Plus |
Closed |
59.0 |
Kimi K2.6 |
1T-A32B |
55.8 |
Qwen3.5-27B |
27B |
41.5 |
같은 27B 베이스인 Qwen3.5-27B가 41.5%인데 Qwen-UI-Agent가 73.6%입니다. 32.1%p 차이가 전부 이 파이프라인에서 나온 셈이라 베이스 대비 증분으로는 가장 깨끗한 숫자입니다. 인간 성능 78.2%까지 4.6%p 남았습니다.
WebArena 평가에 대해 팀이 밝힌 사항이 하나 있습니다. 초기 평가에서 공식 참조 정답과 평가 스크립트의 오류를 여러 건 발견해 수동으로 검증했고, 별표가 붙은 베이스라인은 팀이 같은 설정으로 직접 측정한 값입니다. 원 논문 보고치와 직접 비교할 때 이 점을 감안해야 합니다.
DeepSearch에서는 BrowseComp 64.1%, BrowseComp-ZH 75.0%로 UI-TARS-2를 앞섭니다. Qwen3.5-397B-A17B와는 엇갈립니다. BrowseComp-ZH(70.3%)에서는 앞서지만 BrowseComp(78.6%)에서는 뒤집니다. GPT-5.5는 BrowseComp 90.1%라 이 축에서는 격차가 큽니다. GUI 그라운딩은 ScreenSpot-Pro 81.5%(zoom-in), UI-Vision 70.0%, OSWorld-G-Refined 78.5%, MMBench-GUI L2 92.6%, ScreenSpot-V2 97.5%입니다.
액션 구성
성능 표보다 이 논문에서 더 새로운 것은 §4.2의 사용 통계입니다.
통계 |
수준 |
OSWorld-Verified |
OSWorld-v2 |
차이 (pp) |
|---|---|---|---|---|
CLI |
액션 |
40.7% |
55.1% |
+14.4 |
CLI |
태스크 |
92.0% |
98.2% |
+6.2 |
배치 |
액션 |
39.6% |
41.6% |
+2.0 |
배치 |
태스크 |
62.1% |
88.9% |
+26.8 |
GUI 전용 배치 |
75.8% |
64.7% |
-11.1 |
|
CLI 전용 배치 |
13.1% |
15.0% |
+1.9 |
|
GUI+CLI 혼합 배치 |
11.0% |
20.3% |
+9.3 |
|
배치당 평균 원자 액션 |
3.1 |
3.1 |
0.0 |
CLI가 액션의 40~55%를 차지하고 태스크의 92~98%에 등장합니다. GUI 에이전트라는 이름을 붙인 모델이 실제로는 절반 가까이를 셸로 처리한다는 뜻입니다. CLI를 예외적 우회로가 아니라 대등한 실행 채널로 설계했다는 주장이 여기서 확인됩니다.
배치는 평균 3.1개 원자 액션을 묶습니다. 관측-추론-실행 사이클이 그만큼 줄어듭니다. OSWorld-v2에서 태스크 단위 배치 사용률이 88.9%로 26.8%p 더 높은 것은, 이 벤치마크가 파일 병합이나 구조화 데이터 처리처럼 프로그래밍 실행에 유리한 워크플로를 더 많이 담고 있기 때문입니다.
배치를 언제 끊는지도 명시돼 있습니다. 다음 결정이 새 스크린샷이나 명령 출력, 대화상자, 오류에 의존할 때 배치를 종료합니다. 비슷한 액션을 기계적으로 반복하는 게 아니라 결과가 예측 가능한 국소 트랜잭션을 묶는다는 설계입니다. 논문이 든 사례 중에는 이메일을 채우고 첨부 파일 선택기까지 진행하는 21개 액션 시퀀스가 있는데, 다음 불확실한 대화상자에서 멈춥니다.
RL이 바꾼 것
Action RL의 효과를 다섯 개 오류 패턴별 테스트셋으로 잽니다.
오류 패턴 |
Action RL 전 (%) |
Action RL 후 (%) |
차이 (%p) |
|---|---|---|---|
혼동 요소 그라운딩 |
72.8 |
79.1 |
+6.3 |
정렬·순위 |
76.6 |
80.4 |
+3.8 |
다중 타깃 완결성 |
80.0 |
84.4 |
+4.4 |
조기 완료 |
81.0 |
86.2 |
+5.2 |
반복 액션 루프 |
72.9 |
82.4 |
+9.5 |
전체 태스크 성공률은 7% 넘게 오르는데, 함께 나온 두 숫자가 더 흥미롭습니다. 추론 토큰이 21.3% 줄고 평균 상호작용 스텝은 8.4% 늘었습니다. 정책이 덜 고민하고 더 자주 환경에 손을 대는 쪽으로 바뀌었다는 뜻입니다. 반복 액션 루프에서 +9.5%p로 개선 폭이 가장 큰 것도 같은 방향입니다. 최근 액션이 상태를 못 바꿨다는 걸 알아채고 다른 액션으로 갈아타는 능력입니다.
Online RL 이후에는 세 가지 행동이 나타납니다.
첫째, 가정된 성공에서 검증된 완료로. 검증 액션을 최소 한 번 포함하는 궤적 비율이 14.7% 늘고, 자칭 성공했지만 최종 검증기를 통과하지 못하는 false-stop 비율이 11.2% 줄었습니다.
둘째, 손은 Bash 눈은 GUI. 명시적인 모달리티 조율 목적함수가 없었는데도, 상태 변경은 Bash로 효율적으로 하고 그 효과는 GUI로 확인하는 패턴이 나타났습니다. 상태를 바꾸는 Bash 액션 뒤에 읽기 전용 GUI 검사가 따라오는 실행-검증 전이를 보이는 궤적이 40.2%에서 52.4%로 늘었습니다. GUI 액션 비중은 6% 늘고, GUI와 Bash를 함께 쓰는 궤적은 10.6% 늘었습니다.
셋째, 장기 제약 유지. 지시에 걸린 제약을 끝까지 지키는 태스크 비율이 OSWorld에서 8.6%, BrowseComp-ZH에서 7.5% 늘었습니다.
두 번째 항목이 특히 인상적입니다. 팀이 GUI와 CLI를 어떻게 나눠 쓰라고 가르친 게 아니라, 태스크 성공만 보상으로 주었더니 역할 분담이 창발했습니다. 사례로 든 궤적에서는 Bash만으로 처리하다 수입과 지출을 구분하지 못해 틀리던 정책이, RL 이후에는 Bash로 처리한 뒤 개별 영수증을 GUI로 열어 시각 확인하고 정답을 냅니다.
리포트에서 가장 재미있는 사례는 브라우저 공룡 점프 게임입니다. DevTools와 CDP 사용이 금지된 상태에서 100점 이상을 내라는 태스크인데, 점프마다 모델 액션을 하나씩 내보내는 방식은 스크린샷 획득과 추론 사이에 장애물이 계속 움직이기 때문에 성립하지 않습니다. 모델은 대신 CLI로 로컬 컨트롤러를 만들어 반복 개선합니다. 고정 시간 탭이 안 된다는 걸 실패에서 확인하고 명시적 액션 상태를 도입해 장애물이 지날 때까지 키를 누르는 방식으로 바꿉니다. 게임이 야간 모드로 전환되면서 명암이 반전돼 "장애물은 어두운 픽셀"이라는 초기 가정이 깨지자, 고정 색 임계값을 배경 상대 분할로 교체하고 장애물 기하로 지상 선인장과 공중 새를 구분합니다. 최종 컨트롤러는 60초를 버티며 50번 점프하고 156점을 냅니다.
GUI가 지각 증거와 실행 피드백을 대고, CLI가 그 증거를 매 스텝 모델 추론이 필요 없는 반복 가능한 지각·제어 절차로 바꿉니다. 하이브리드 액션 공간이 무엇을 위한 것인지를 이 사례 하나가 다 설명합니다.
회고
저자들이 §7에 적어 둔 한계가 네 가지입니다.
첫째, 실기기 궤적 평가에 결정적 검증기나 사람 검토가 아니라 AutoJudge를 씁니다. 서드파티 앱의 내부 상태에 접근할 수 없어 상태 기반 검증이 사실상 불가능하고, Qwen-UI-Agent와 열 개 베이스라인의 궤적을 사람이 판정하려면 막대한 노력과 주석자 편차가 따르기 때문입니다. AutoJudge는 다섯 개 독립 VLM 판정기가 같은 궤적을 보고 다수결로 pass, failed, env_error 중 하나를 냅니다. 전문가가 독립 검토한 666개 예제에서 정확 일치 정확도가 92.8%입니다.
이 92.8%를 어떻게 읽을지가 중요합니다. 92.2%라는 MobileWorld-Real 성공률과 판정기의 92.8% 정확도가 같은 자릿수라는 사실은 짚어 둘 만합니다. 모든 시스템에 같은 프로토콜을 적용했으므로 상대 비교는 유효하지만, 절대 수치에는 판정 오차가 섞여 있습니다. 게다가 환경 오류를 성공률 분모에서 빼는 설계라, 무엇을 환경 오류로 판정하느냐가 최종 숫자에 직접 영향을 줍니다. 팀이 이 사실을 숨기지 않고 명시한 점은 평가할 만합니다.
둘째, 35B-A3B 규모의 컴퓨터 사용과 DeepSearch 학습이 리포트 공개 시점에 아직 진행 중이라 해당 결과가 빠져 있습니다. arXiv 버전을 나중에 갱신하겠다고 밝혔습니다.
셋째, 실제 앱을 더 가깝게 재현하는 고충실도 합성 환경을 구축했지만 이번 모델 학습에는 반영하지 못했습니다.
넷째가 가장 솔직합니다. GUI 능력 개발을 완전 자동화하려 했지만 현재 파운데이션 모델은 전 과정을 안정적으로 관리하지 못한다는 것을 확인했다고 적었습니다. 그래서 파이프라인은 완전 자율이 아니라 에이전트 주도이며, 진행을 감시하고 오류를 고치는 데 여전히 상당한 사람의 감독과 개입이 필요합니다. "AutoResearch 방식"이라는 표현을 도입부에서 앞세워 놓고 마지막에 이 정도로 명확히 한계를 그은 건 드문 정직함입니다.
여기에 논문이 명시하지 않은 문제를 하나 더 붙이면, 재현성입니다. 100대 넘는 물리 단말, 150개 이상 앱, 1만 개 동시 샌드박스, 100턴 넘는 궤적의 온라인 RL. 이 인프라가 없는 팀에게 이 결과는 검증 가능한 주장이 아니라 참고 자료에 가깝습니다. 모델 가중치가 공개되더라도 학습 파이프라인은 재현할 수 없습니다. 논문이 제시하는 교훈이 "환경이 능력의 경계를 정한다"인데, 그 교훈을 실행에 옮길 수 있는 조직은 극히 적다는 것이 이 논문이 남기는 진짜 함의일지 모릅니다.
벤치마크 자체의 상한도 봐야 합니다. MobileWorld-Real은 409개 태스크에 104개 앱, 7개 도메인이고 절반 가까이가 hard로 분류됩니다. 중국 모바일 생태계 기준이라 슈퍼 앱과 조밀한 인터페이스, 잦은 팝업이 난이도의 큰 부분을 차지합니다. 이 조건이 다른 시장에서 그대로 성립하는지는 별개 문제입니다. 팀도 안정적 반복 평가를 위해 과거 주문 이력이나 장바구니 상태, 은행 카드처럼 재현할 수 없는 조건에 의존하는 태스크는 제외했다고 밝힙니다. 실기기 평가라도 재현성을 위해 걸러낸 영역이 있다는 뜻입니다.
정리
- 실기기 실패의 절반 이상(52.0%)이 UI 오독과 팝업 간섭, 물리 위젯 제어처럼 시뮬레이터가 설계상 배제하는 조건에서 발생합니다. 이 분해가 논문의 출발점이고, 100대 단말 런타임과 헬스 어웨어 스케줄러는 그 분석에서 역산된 설계입니다.
- GUI 에이전트라는 이름과 달리 컴퓨터 태스크 액션의 40.7~55.1%가 CLI로 나가고, 태스크의 92~98%에 CLI가 등장합니다. 배치는 평균 3.1개 액션을 묶어 스텝 수를 절반 아래로 줄입니다. 온라인 RL 이후에는 아무도 가르치지 않은 역할 분담(Bash는 손, GUI는 눈)이 창발합니다.
- 27B로 MobileWorld-Real 92.2%를 내며 프런티어 폐쇄형 모델들을 앞서지만, OSWorld-v2 partial은 Opus 4.8에 14.8%p 뒤지고 실기기 평가는 정확도 92.8%의 VLM 판정기에 의존합니다. 저자들 스스로 완전 자동 파이프라인은 아직 안 된다고 적었습니다.
- arXiv: 2607.28227
- 프로젝트: tongyi-mai.github.io/Qwen-UI-Agent