SemaPLC - A Project-Grounded, Verification-Gated Agent Harness for PLC Code Generation
Y. Tu, H. Wang, Z. Zhou, J. Zhou, et al., "SemaPLC: A Project-Grounded, Verification-Gated Agent Harness for PLC Code Generation," arXiv:2608.18565, 2026.
코딩 에이전트 벤치마크는 대부분 코드를 실행하지 않고 채점합니다. 컴파일이 되는지 보고, 테스트를 돌리고, 정적 규칙을 만족하는지 확인합니다. 이 논문은 산업용 제어 로직이라는 낯선 도메인에서 그 관행에 구멍이 있다는 것을 수치로 보여줍니다. 정적 점수로 보면 세 baseline이 4점 안에 몰려 있는데, 같은 프로그램을 실제 컨트롤러에 올려 실행 트레이스를 대조하면 22.4에서 31.4까지 벌어지고 제안 방법은 52.2로 올라섭니다.
저자
Midea AI Research Center(AIRC)와 KUKA가 함께 쓴 논문입니다. 상하이교통대학교와 저장대가 일부 저자로 참여했습니다.
가전 회사가 에이전트 하네스 논문을 낸다는 것이 어색해 보일 수 있지만, Midea는 2016년 약 50억 달러에 KUKA를 인수한 뒤 산업 자동화를 사업 축으로 삼은 회사입니다. 자사 공장 라인을 직접 굴리고, 로봇 팔을 팔고, 그 설비를 움직이는 컨트롤러를 프로그래밍합니다. 생성된 제어 로직이 실제로 도는지가 학술적 호기심이 아니라 출하 조건인 쪽입니다.
교신저자 세 명의 구성이 이 연구의 성격을 그대로 보여줍니다. 왕화찬과 쉬이는 Midea AIRC 소속이고, 장후이는 KUKA 그룹 CTO 겸 로보틱스 사업부 CTO입니다. 연구 조직과 로봇 사업부가 같은 문제를 함께 붙든 형태입니다.
왕화찬이 여기 있다는 점이 특히 중요합니다. 그는 2026년에 "Sema" 이름을 단 논문을 연달아 내고 있습니다. 3월의 SemaClaw는 범용 개인 에이전트를 하네스 엔지니어링으로 접근했고, 4월의 Sema Code는 코딩 에이전트의 코어 엔진을 클라이언트 계층에서 완전히 떼어내 npm 라이브러리로 배포했습니다. 세 편을 관통하는 주장은 일관됩니다. 모델을 바꾸는 대신 모델을 감싸는 하네스를 설계하고, 종료 조건을 모델 바깥으로 빼내야 운영에 쓸 수 있는 에이전트가 된다는 것입니다. SemaPLC는 그 노선을 가장 엄격하게 밀어붙인 형태입니다.
1저자 투옌룬은 검증 게이트 설계와 두 트랙의 평가 인프라 구축을 담당했습니다.
배경
PLC(Programmable Logic Controller)는 공장 라인과 발전소와 정수 시설을 움직이는 컨트롤러입니다. IEC 61131-3 표준이 규정하는 다섯 언어 중 텍스트 계열인 Structured Text(ST)로 주로 프로그래밍하고, ST는 Pascal 계열 문법이라 LLM이 다루기 좋은 편입니다.
일반 소프트웨어와 결정적으로 다른 점은 스캔 사이클입니다. PLC 프로그램은 한 번 실행되고 끝나지 않습니다. 입력 읽기, 로직 실행, 출력 쓰기를 밀리초 단위로 무한 반복합니다. 어떤 상태가 스캔 사이를 넘어 유지돼야 하고 어떤 값이 매 스캔 다시 계산돼야 하는지를 구분하지 못하면, 컴파일은 통과해도 설비가 잘못 움직입니다.
LLM으로 PLC 코드를 생성하는 연구는 이미 몇 세대를 거쳤습니다. LLM4PLC가 컴파일러와 SMV 피드백을 붙였고, AutoPLC가 벤더 IDE 안에서 사례 검색과 컴파일러 기반 디버깅을 붙였고, Agents4PLC가 5개 에이전트 폐루프와 PLCverif 검증에 117개 태스크 벤치마크를 붙였습니다. 실행 피드백을 쓴다는 발상 자체는 새롭지 않습니다.
저자들이 문제 삼는 것은 그 실행이 쓰이는 방식입니다. 논문의 표현으로 "Demonstrated, not measured", 즉 기존 시스템들은 생성된 코드가 돌아갈 수 있다는 것을 보여주려고 실행했지 얼마나 신뢰할 만하게 도는지를 재려고 실행하지 않았습니다. 벤치마크 단위는 여전히 독립 POU(Program Organization Unit)이고, 프로젝트 통합과 런타임 동작에 관한 보고는 대부분 제한된 테스트나 몇 개 사례에 기대고 있습니다.
실제 배포에는 두 가지 추가 요구가 붙습니다. 첫째는 프로젝트 그라운딩입니다. 생성된 로직은 이미 존재하는 프로젝트에 통합돼야 하고, 그 프로젝트의 모듈과 함수 블록을 재사용하고, 변수와 타입과 인터페이스를 존중하고, 빌드와 리셋과 초기화와 안전 관행을 지켜야 합니다. 둘째는 올바른 런타임 동작입니다. 통합된 프로그램이 컴파일되고 정적 검사를 통과해도, 타이머를 잘못 설정하거나 상태 전이를 틀리거나 리셋을 빠뜨리거나 인터록을 깨거나 출력 타이밍을 틀릴 수 있습니다.
통합 컴파일, 정적 판정, 동적 런타임 동작은 같은 프로그램의 서로 다른 세 가지 속성이라는 것이 이 논문의 출발점입니다.
어떻게 만들었나
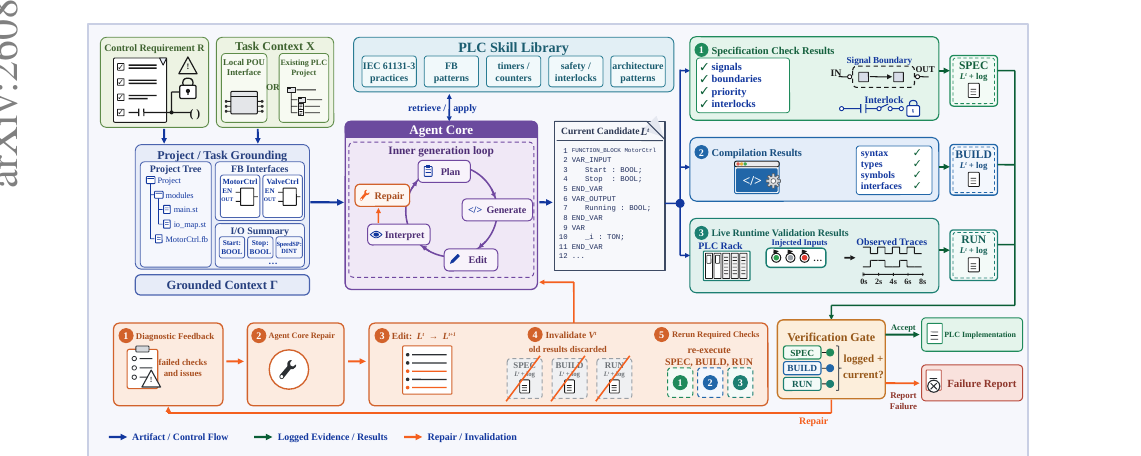
SemaPLC는 새 도구를 발명한 것이 아닙니다. 저자들이 명시적으로 "novelty is not the set of tools but the completion discipline governing them"이라고 적었습니다. 관습적인 도구를 모아놓고, 그 위에 엄격한 완료 규칙을 씌운 것이 기여입니다.
에이전트 코어는 PLC 지식이 전혀 없는 범용 이벤트 기반 도구 사용 루프이고, 표준 chat-completion 인터페이스로 접근합니다. 그 위에 다섯 구성요소가 올라갑니다. 프로젝트·태스크 그라운딩, PLC 스킬 라이브러리, 검증 프로세스, 그리고 완료를 결정하는 검증 게이트입니다. 모든 구성요소는 공유 PLC MCP 도구 계층을 통해 환경에 작용합니다. MCP stdio 서버와 동등한 CLI 두 표면을 노출하는 단일 도구 서버로, plc_compile, plc_buildAndRun, plc_forceVariables, plc_trace, plc_record 같은 16개 도구를 제공합니다.
세 갈래 검증
SemaPLC는 세 종류의 외부 결과를 동등하게 소비합니다.
명세 검사는 후보 코드를 자연어 요구사항에 대해 절 단위로 감사합니다. 요구사항에 언급된 모든 장치와 신호와 공표 변수, 임계값과 경계 조건, 인터록과 상호배제와 우선순위 불변식, 스캔 사이클 상태 의미론을 훑습니다. 컴파일러는 받아들이지만 요구사항이 금지하는 결함을 노립니다. 체크리스트 스킬 문서로 인코딩돼 있고 항목마다 통과 또는 구체적 수정안을 반환합니다.
컴파일 결과는 문법, 타입, 심볼, 인터페이스, 통합 빌드를 확인하고 소스 라인과 오류 분류와 진단을 돌려줍니다. 여기서 설계 선택이 하나 있습니다. 피드백은 첫 번째 진단 하나만 줍니다. 수리 범위를 국소적으로 묶어 연쇄 재작성을 막기 위해서입니다.
라이브 런타임 검증이 이 논문의 중심입니다. 구현을 빌드하고 배포하고 런타임을 초기화한 뒤, 시나리오 입력을 주입하고 외부 변수를 샘플링합니다. 관측된 동작을 요구사항에서 유도한 런타임 어서션과 비교하거나, 신뢰할 만한 녹화본이 있으면 골든 트레이스와 비교합니다. 타이머와 리셋 동작, 상태 전개, 인터록, 시간적 출력 동작을 노립니다.
실패 단계가 수리 대상을 지정한다는 대목이 실무적입니다. 트레이스가 평평하면 배선 문제, 변하지만 틀리면 블록 로직 문제, 전이가 늦으면 타이머나 에지 검출기 문제로 좁힙니다.
검증 게이트
Algorithm 1이 루프를 정확히 규정합니다. 게이트는 세 불변식으로 통제됩니다.
Bounded retries. 각 검사는 최대 \(r = 2\) 회의 수리 라운드를 허용합니다.
Edit invalidation. 어떤 수정이든 이전 판정을 전부 무효화하고 모든 검사를 다시 돌립니다. 판정이 정확한 바이트에 붙는다는 뜻입니다.
Earned claims. 각 결과는 기계 판독 가능한 sentinel이고 도구 호출 로그와 교차 검증됩니다. 로그가 없는 주장은 unchecked로 강등됩니다.
이 셋이 함께 delivery integrity를 보장합니다. 전달된 프로그램은 보고된 모든 통과를 획득한 바로 그 후보와 동일하고, 도구 로그 없이는 어떤 자기 보고 통과도 살아남지 못합니다.
부록의 delivery gate 조건이 이 원칙의 구체적 형태입니다. 런타임 검증은 주입용 테스트 사본에서 수행하고 전달 파일은 건드리지 않는데, 이 둘이 어긋나지 않도록 세 조건을 겁니다. 전달 파일에 located address 리터럴이 없을 것, 전달 바이트가 그 파일을 입력 목록에 포함한 마지막 성공 컴파일 내용과 해시 일치할 것, 세션 로그에 배포와 강제 입력 증거가 있을 것.
무엇으로 구성돼 있나
평가는 두 트랙으로 나뉩니다. 저자들은 이 둘이 한 태스크의 순차 단계가 아니라 상호 보완적인 평가 설정이라고 못 박습니다.
함수 트랙은 Agents4PLC 벤치마크의 117개 독립 POU 태스크입니다. 기존 벤치마크와 공정하게 비교하기 위한 축입니다. held-out 심판이 후보를 컴파일하고 요구사항에서 유도한 속성을 모델 체킹하며, 검증 만족 비율 \(V_f\)에 대해 다음이 주 지표입니다.
\[\text{VerifiedPass}(L_f) = \mathbb{1}[V_f \geq 0.80]\]
0.80 임계는 Agents4PLC를 따랐습니다. 모델 체크가 satisfied도 violated도 아닌 결과를 내면(미지원 구문, 번역 실패, 타임아웃) inconclusive로 보고 실패로 셉니다. 생성 실패도 분모에 남습니다. 엄격한 채점입니다.
여기서 저자들이 한 작업 하나를 짚어야 합니다. Agents4PLC가 공개한 오라클에 결함이 있었습니다. 검증 속성이 잘못돼 올바른 구현을 실패시키는 태스크들이 있었고, PLC 엔지니어들이 3라운드 감사로 이를 수리했습니다. 독립 병렬 리뷰로 후보 결함을 표시하고, 2라운드에서 불리언 로직은 완전 진리표로 상태 기계는 단계별 시뮬레이션으로 모든 표시를 처음부터 재유도하고, 블라인드 3라운드가 불일치를 판정했습니다. 최소 두 라운드가 확인한 결함만 수리했고, 근거 없는 속성은 임의 임계값을 지어내 대체하지 않고 삭제했습니다. 확인된 결함은 다섯 부류였습니다. 잘못된 상수나 극성, 항진 어서션, 설계와 모순되는 속성, 지어낸 임계값, 복사-붙여넣기 중복. 117개 중 43개 태스크에 결함이 있었고, 속성 수가 629개에서 607개로 줄었습니다. 모든 방법이 동일한 수리 데이터로 평가됩니다.
프로젝트 컨텍스트 트랙은 Spec2Control에서 유도한 65개 태스크입니다. 검토된 제어 서술을 가진 열 개 산업 플랜트를 IEC 61131-3 ST 프로젝트로 변환했습니다. 각 태스크는 한 플랜트 섹션을 겨냥하고, 섹션 서술과 함수 블록 인터페이스 카탈로그와 라이브러리와 빈 엔트리 하네스가 주어지면 생성된 로직이 전체 프로젝트 안에서 컴파일되고 배포돼야 합니다. 참조 구현과 런타임 트레이스와 원본 답안은 숨겨져 있고, 유출 감사에서 축자 복사는 발견되지 않았습니다.
통합 프로그램 \(P' = P \oplus L_p\)를 세 독립 지표로 채점합니다.
- 통합 컴파일 \(C(P') \in \{0, 1\}\)
- 정적 동작 \(S(P', R_p) \in [0, 100]\), 프로그램 텍스트에 대한 요구사항 유도 어서션
- 동적 동작 \(D(P', T) \in [0, 100]\), 라이브 런타임에 배포해 관측 트레이스를 숨겨진 참조와 대조하는 골든 트레이스 차분
셋 다 같은 65개 분모를 쓰고 따로 보고합니다.
정적 어서션은 65개 중 63개 태스크에서 코퍼스의 플랜트별 런타임 테스트로부터 자동 유도했습니다. 파서가 섹션에 속한 테스트 함수를 찾아 문자열과 수치 리터럴을 추출하고, 부분문자열 존재·부재, 필수 호출, 수치 상수, 구조 참조, any-of 집합 여섯 유형을 생성합니다. 숨겨진 참조 구현에도 나타나는 항목만 어서션이 되고, 생성된 오라클은 그 참조에서 만점을 받아야 채택됩니다. 태스크당 1개에서 20개, 중앙값 7개, 총 502개입니다.
동적 시나리오는 태스크당 최대 여섯 개입니다. 정상 운전 하나, 고·저 한계가 설정된 아날로그 입력마다 한계를 넘는 오프셋을 적용한 한계 위반 시나리오, 마지막으로 불리언 입력을 전부 반전시키는 이산 플립 시나리오입니다.
결과
함수 트랙
모델 |
LLM4PLC |
AutoPLC |
Agents4PLC |
SemaPLC (bare) |
SemaPLC (full) |
|---|---|---|---|---|---|
MiniMax-M2.7 |
22.2 |
49.6 |
53.8 |
39.3 |
69.2 |
MiniMax-M3 |
15.4 |
65.0 |
55.6 |
60.7 |
69.2 |
Qwen3.5-Plus |
13.7 |
67.5 |
67.5 |
62.4 |
75.2 |
DeepSeek-V4-Flash |
41.0 |
54.7 |
54.7 |
34.2 |
67.5 |
DeepSeek-V4-Pro |
43.6 |
61.5 |
62.4 |
55.6 |
69.2 |
GLM-5.2 |
30.8 |
59.0 |
74.4 |
63.2 |
76.1 |
GPT-5.5 |
44.4 |
79.5 |
78.6 |
71.8 |
82.1 |
평균 |
30.2 |
62.4 |
63.9 |
55.3 |
72.6 |
최저 |
13.7 |
49.6 |
53.8 |
34.2 |
67.5 |
엄격 검증 통과율(%), 분모 117. bare는 같은 백본에서 하네스(스킬과 도구)를 벗겨낸 구성입니다.
SemaPLC가 일곱 모델 전부에서 최고이고, 평균 72.6%는 최강 baseline인 Agents4PLC보다 8.8점 높습니다. 더 눈여겨볼 것은 안정성입니다. SemaPLC의 최악 모델(67.5%)이 모든 baseline의 평균을 넘습니다. 점수 폭도 14.6점인 데 반해 baseline들은 25에서 31점씩 흩어집니다.
bare 열이 하네스 자체의 기여를 분리합니다. 모든 모델이 8.5점에서 33.3점씩 개선되고, 약한 모델이 가장 많이 얻습니다(MiniMax-M2.7 +29.9, DeepSeek-V4-Flash +33.3). 모델 간 산포는 bare 37.6점에서 14.6점으로 줄고, 컴파일 통과율 평균은 85.5%에서 99.2%로 올라갑니다. 하네스가 특정 백본에 맞춘 프롬프트가 아니라 모델 무관 신뢰성 계층으로 작동한다는 뜻입니다.
프로젝트 트랙
통합 컴파일 |
MiniMax-M2.7 |
MiniMax-M3 |
Qwen3.5-Plus |
DS-V4-Flash |
DS-V4-Pro |
GLM-5.2 |
GPT-5.5 |
평균 |
|---|---|---|---|---|---|---|---|---|
LLM4PLC |
47.7 |
53.8 |
16.9 |
60.0 |
52.3 |
80.0 |
100.0 |
58.7 |
AutoPLC |
69.2 |
95.4 |
58.4 |
58.5 |
95.4 |
95.4 |
98.5 |
81.5 |
Agents4PLC |
47.7 |
69.2 |
40.0 |
75.4 |
78.5 |
89.2 |
98.5 |
71.2 |
SemaPLC |
81.5 |
95.4 |
80.0 |
84.6 |
89.2 |
95.4 |
100.0 |
89.4 |
정적 동작 |
MiniMax-M2.7 |
MiniMax-M3 |
Qwen3.5-Plus |
DS-V4-Flash |
DS-V4-Pro |
GLM-5.2 |
GPT-5.5 |
평균 |
|---|---|---|---|---|---|---|---|---|
LLM4PLC |
76.1 |
76.7 |
74.5 |
70.3 |
69.2 |
77.1 |
86.3 |
75.7 |
AutoPLC |
68.9 |
73.5 |
68.9 |
76.2 |
66.5 |
75.5 |
88.8 |
74.0 |
Agents4PLC |
63.4 |
73.5 |
77.6 |
71.4 |
64.5 |
62.8 |
88.6 |
71.7 |
SemaPLC |
74.9 |
84.9 |
79.9 |
78.0 |
81.2 |
88.0 |
84.1 |
81.6 |
동적 동작 |
MiniMax-M2.7 |
MiniMax-M3 |
Qwen3.5-Plus |
DS-V4-Flash |
DS-V4-Pro |
GLM-5.2 |
GPT-5.5 |
평균 |
|---|---|---|---|---|---|---|---|---|
LLM4PLC |
3.0 |
26.1 |
6.6 |
18.4 |
13.9 |
34.6 |
54.5 |
22.4 |
AutoPLC |
4.0 |
43.5 |
19.8 |
23.9 |
45.7 |
21.9 |
61.1 |
31.4 |
Agents4PLC |
4.5 |
30.8 |
11.4 |
28.3 |
28.8 |
44.6 |
63.6 |
30.3 |
SemaPLC |
31.3 |
52.1 |
43.1 |
54.1 |
57.4 |
61.9 |
65.4 |
52.2 |
0에서 100점, 분모 65. DS = DeepSeek.
세 표를 세로로 겹쳐 보면 이 논문의 핵심 주장이 그대로 드러납니다. 정적 동작에서 세 baseline은 71.7에서 75.7 사이, 즉 4.0점 안에 몰려 있습니다. 같은 방법들이 동적 동작에서는 22.4에서 31.4로 흩어지고, 최악 모델에서는 한 자릿수까지 떨어집니다. 정적 점수가 비슷하다고 동적 동작이 비슷하지 않습니다. 런타임 계층은 방법들을 갈라놓을 뿐 아니라 순서를 뒤집기도 합니다. 정적에서 LLM4PLC가 75.7로 Agents4PLC의 71.7보다 높은데, 동적에서는 22.4 대 30.3으로 뒤집힙니다.
SemaPLC는 정적에서 동적으로 떨어지는 폭도 가장 작습니다(29.4점, baseline은 41.4에서 53.3점). 다만 저자들은 두 점수가 서로 다른 속성을 재는 것이라 이 격차를 점수 대 점수의 신뢰성 손실로 읽으면 안 된다고 덧붙입니다.
계층 절제
DeepSeek-V4-Flash 한 모델로 검사 계층을 하나씩 누적한 결과입니다.
검증 계층 |
통합 컴파일 |
정적 |
동적 |
토큰 |
요청 |
|---|---|---|---|---|---|
없음 (생성만) |
64.6 |
71.5 |
23.1 |
34k |
8.9 |
|
70.8 |
74.0 |
30.3 |
60k |
14.6 |
|
83.1 |
77.8 |
43.7 |
74k |
25.5 |
|
84.6 |
78.0 |
54.1 |
129k |
47.8 |
각 계층이 동적 점수를 단조적으로 올립니다. 23.1에서 30.3, 43.7, 54.1입니다. 반면 정적 동작은 71.5에서 78.0으로 훨씬 덜 움직입니다. 컴파일 계층이 단일 최대 동적 이득(+13.4)을 주는데, 빌드되지 않는 프로그램은 런타임에서 0점이기 때문입니다. 컴파일이 포화한 뒤에는 런타임 계층이 다음(+10.4)입니다.
3,590개 개별 시나리오·포트 값 검사로 분해하면 무슨 일이 일어나는지가 더 선명합니다.
결과 |
없음 |
+명세 |
+컴파일 |
+런타임 |
|---|---|---|---|---|
검사 실패 |
76.9 |
69.7 |
56.3 |
45.9 |
ㄴ 빌드·실행 안 됨 |
33.4 |
24.5 |
19.7 |
3.3 |
ㄴ 포트 없음 |
41.3 |
35.7 |
20.0 |
18.2 |
ㄴ 값 틀림 (정상) |
0.9 |
3.0 |
4.9 |
7.1 |
ㄴ 값 틀림 (한계 위반) |
1.2 |
6.5 |
11.7 |
17.3 |
정답 |
23.1 |
30.3 |
43.7 |
54.1 |
구조적 실패(빌드 안 됨 또는 포트 없음)가 74.7%에서 21.5%로 떨어지고, 전체 하네스는 검사의 3.3%만 미빌드로 남깁니다. 이 53점의 이동이 두 갈래로 갈립니다. 새로 정답이 된 검사(23.1%에서 54.1%)와, 새로 측정 가능해진 오답(2.1%에서 24.4%)입니다.
오답 비율이 오르는 것은 저자들의 지적대로 성능 저하가 아니라 커버리지 확장의 부산물입니다. 검사는 실행돼야 틀릴 수 있고, 관측된 오답이야말로 런타임 피드백이 수리하는 대상입니다. 남은 오답은 한계 위반 시나리오에 몰립니다(17.3% 대 정상 운전 7.1%).
형식 검증이 닿지 않는 곳
함수 트랙에서 held-out 평가 파이프라인(PLCverif, nuXmv)이 어디까지 결론을 내는지 보면, 런타임 검증이 왜 필요한지가 나옵니다.
프로그램 그룹 |
프로그램 |
속성 |
결론 도달 (%) |
미결 (%) |
|---|---|---|---|---|
REAL·타이머 없음 |
916 |
4,653 |
75.7 |
24.3 |
REAL 포함 |
345 |
1,845 |
87.0 |
13.0 |
타이머(TON) 포함 |
32 |
174 |
0.0 |
100.0 |
타이머가 경계선입니다. 타이머를 가진 32개 프로그램의 174개 속성 중 결론에 도달한 것이 하나도 없습니다. 미지원 패턴과 번역 실패가 대부분입니다. 타이머가 원리적으로 검증 불가능한 것은 아니지만, 이 파이프라인에서는 스캔 사이클을 가로지르는 상태 보유 타이밍 구문이 결론 커버리지 밖으로 나갑니다. 그리고 런타임 검증이 직접 건드리는 것이 정확히 그 부분입니다.
사례
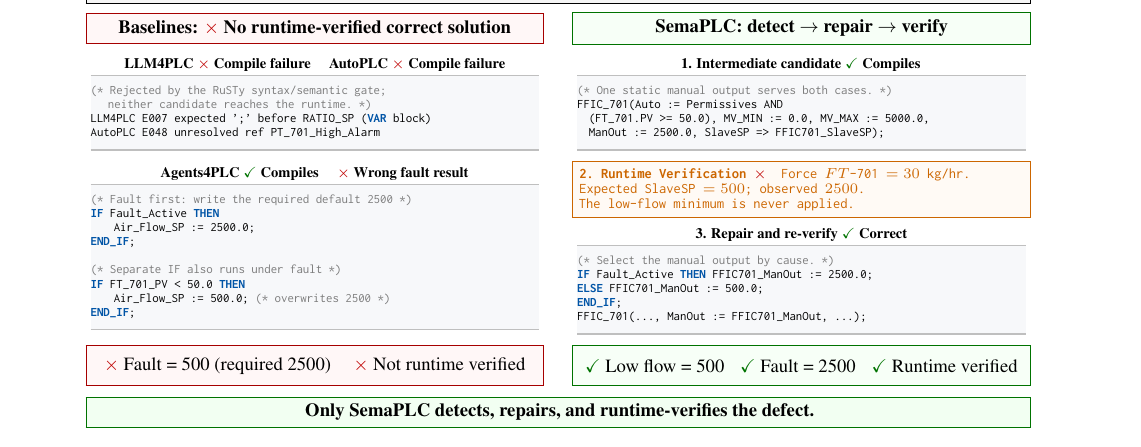
코킹 정유 플랜트의 "Section 8" 태스크입니다. 요구사항이 하나의 설정값을 두 경쟁 조건에 묶습니다. 저유량(\(FT\text{-}701 < 50\) kg/hr)이면 SlaveSP는 500, 트랜스미터 고장이면 SlaveSP는 2500입니다.
LLM4PLC와 AutoPLC는 컴파일에 실패해 런타임에 닿지도 못합니다. Agents4PLC는 컴파일되지만 고장 처리를 틀립니다. 고장 시 2500을 쓴 다음, 별개의 IF문이 고장 상태에서도 실행되면서 저유량 조건이 500으로 덮어씁니다.
흥미로운 것은 SemaPLC의 중간 후보도 같은 부류로 틀렸다는 점입니다. 정적 수동 출력 하나로 두 경우를 모두 처리하려 했고, 이것도 깨끗하게 빌드됩니다. 결함이 문법이나 인터페이스가 아니라 경쟁 조건에서의 출력 선택에 있기 때문입니다. 런타임 검증이 이것을 관측 가능하게 만듭니다. \(FT\text{-}701 = 30\) kg/hr를 강제하니 기대값 500에 관측값 2500이 나오고, 실패 단계가 수리 대상을 "원인별로 출력 선택"으로 좁히고, 재검증이 두 이상 케이스를 모두 확인합니다.
비용
방법 |
태스크당 요청 |
태스크당 시간(초) |
|---|---|---|
함수 트랙 |
||
Agents4PLC |
6.3 (4.4~7.2) |
454 (241~688) |
SemaPLC |
6.5 (5.5~7.6) |
71 (41~156) |
프로젝트 트랙 |
||
Agents4PLC |
6.9 (6.8~7.0) |
344 (47~917) |
SemaPLC |
34.1 (16.4~60.4) |
347 (25~1380) |
함수 트랙에서는 요청 수가 비슷하고(6.5 대 6.3) 벽시계 시간은 오히려 훨씬 짧습니다(71초 대 454초). Agents4PLC가 매 반복마다 PLCverif와 nuXmv 모델 체킹을 호출하는 것이 시간을 잡아먹기 때문입니다.
프로젝트 트랙에서는 이야기가 다릅니다. 벽시계는 비슷한데(347초 대 344초) 요청은 34.1 대 6.9로 다섯 배 가까이 많습니다. 동적 성능의 우위를 모델 상호작용으로 지불하고 있습니다. 이 차이는 구조적입니다. Agents4PLC의 고정 멀티에이전트 워크플로는 반복 횟수가 묶여 있어 요청 수가 모델과 무관하게 거의 일정합니다(6.8에서 7.0). SemaPLC의 열린 루프에서는 각 도구 호출이 모델의 결정이고 게이트가 검사를 통과할 때까지 계속 상호작용시키므로, 요청이 백본에 따라 16.4에서 60.4까지 변동합니다.
회고
저자들이 결론에서 스스로 두 한계를 적었습니다.
동적 채점이 유한한 시나리오 집합만 훑습니다. 숨겨진 참조에서 유도한 한정된 시나리오로 채점하므로, 보지 못한 조건에서의 동작은 측정되지 않은 채 남습니다. 부록 E가 이 문제를 더 정직하게 풉니다. 에이전트가 반복하며 참고하는 런타임 피드백은 태스크 명세에서 스스로 유도한 시나리오에서 나오고, 채점 시나리오는 숨겨진 참조에서 따로 유도됩니다. 두 집합은 채점 산출물에 대한 접근이 아니라 공유된 요구사항을 통해 겹칠 수 있습니다. 그래서 동적 점수는 벤치마크 시나리오에서의 동작을 재는 것이지 미지 운전 조건으로의 일반화를 재는 것이 아닙니다.
우위가 강한 모델에서 좁아집니다. GPT-5.5에서 SemaPLC는 Agents4PLC를 동적 1.8점 차로만 앞서고(65.4 대 63.6), 정적 동작에서는 오히려 뒤집니다(84.1 대 최대 88.8). 저자들의 해석은 동적 이득이 모델 단독으로는 모자란 자리에 공급되는 신뢰성이지, 프런티어에서도 유지되는 고정 마진이 아니라는 것입니다. 이 서술은 정직하지만, 뒤집으면 프런티어 모델이 계속 강해질 경우 이 하네스의 가치가 어디로 수렴하는지에 대한 답은 논문에 없습니다.
세 번째 한계는 저자들이 명시하지 않았지만 표에서 읽힙니다. 최고 방법의 동적 점수조차 정적 점수보다 한참 낮습니다. 81.6 대 52.2입니다. 저자들도 "runtime PLC generation is far from solved"라고 한 문장 적었는데, 절반 가까운 시나리오·포트 검사가 여전히 참조와 다르게 동작한다는 뜻입니다. 이 논문은 문제를 푼 것이 아니라 문제가 보이게 만든 쪽에 가깝습니다.
계층 절제가 단일 모델(DeepSeek-V4-Flash)에서만 수행됐다는 점도 저자들이 밝혀둡니다. 계층별 기여의 크기가 백본에 따라 어떻게 달라지는지는 열려 있습니다.
측정 방식 자체에도 전제가 하나 깔려 있습니다. 트레이스는 매 스캔 사이클이 아니라 샘플링됩니다. 저자들은 순간 이벤트를 지속 어서션으로 확인한다고 적었지만, 샘플링 간격보다 짧게 나타났다 사라지는 동작은 원리적으로 이 방식의 사각지대입니다. 알람·고장 패턴에 해당하는 포트는 보고만 하고 채점하지 않는다는 것도 채점 범위를 좁히는 선택입니다.
정리
정적 채점은 코딩 에이전트를 구분하지 못합니다. 세 baseline이 정적 동작에서 4.0점 안에 몰려 있다가 실제 런타임에서 22.4에서 31.4로 갈라지고, 순서까지 뒤집힙니다. 실행하지 않고 멈추는 평가는 신뢰할 만한 방법과 아닌 방법을 나눌 수 없습니다. PLC라는 도메인이 이것을 극단적으로 보여줄 뿐, 논지 자체는 코딩 에이전트 벤치마크 일반에 걸립니다.
완료 판정을 모델에게서 빼앗는 것이 도구를 늘리는 것보다 큽니다. SemaPLC가 쓰는 도구는 관습적입니다. 기여는 종료 규율입니다. 로그된 외부 검증만 종료를 허용하고, 수정은 이전 판정을 전부 무효화하고, 로그 없는 주장은 강등됩니다. 이 규율이 하네스를 벗긴 같은 백본 대비 평균 17.3점을 만들고, 약한 모델일수록 더 크게 얻습니다.
형식 검증이 닿지 않는 자리가 정확히 런타임 검증이 필요한 자리입니다. 타이머를 가진 32개 프로그램의 174개 속성 중 형식 검증이 결론을 낸 것은 하나도 없습니다. 스캔 사이클을 가로지르는 상태 보유 구문이 모델 체커의 사각지대이고, 실제 컨트롤러에 올려 트레이스를 보는 것 말고는 확인할 방법이 없습니다.