From RLVR to RLSVR - Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement
Q. Wang, J. Shi, H. Wang, K. Wan, Y. Wu, B. Liu, Q. Wu, H. H. Li, Y. Chen, H. Zhao, and W. Zhao, "From RLVR to RLSVR: Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement," arXiv:2607.23802, 2026.
저자
듀크대, 어도비, 오리건주립대, 펜실베이니아주립대, 싱가포르국립대, 아마존 여섯 곳이 섞인 열한 명입니다. COLM 2026 채택 논문입니다.
1저자 왕친쓰는 듀크대 CEI 랩 박사과정으로 원래 LLM 가속과 압축을 하던 사람입니다. Dobi-SVD(ICLR 2025), CoreInfer처럼 추론 비용을 깎는 쪽 작업이 대표작입니다. 효율화 연구자가 자기개선 RL 논문의 1저자로 나온 것이 처음에는 어긋나 보이지만, 이 논문의 실질적 이득 하나가 외부 검증자 호출 비용을 없애는 것이라는 점에서 이어집니다. 논문이 GPT-4o 루브릭 평가에 약 \(900, Qwen3.5-27B 루브릭에 약\)200이 들었다고 비용을 명시하는 대목이 그 관심의 흔적입니다.
지도교수는 천이란과 Hai Helen Li입니다. 둘 다 듀크대에서 메모리와 뉴로모픽 컴퓨팅을 해 온 하드웨어 쪽 사람들입니다.
공동 지도(co-advisor)로 자오한둥(어도비)과 Wentian Zhao(아마존, 작업은 어도비에서 수행)가 붙었습니다. 세 평가 도메인 중 하나가 창작 글쓰기인 배경에는 어도비의 크리에이티브 응용 축이 있습니다.
우칭윈과 Yiran Wu가 펜스테이트에서 합류한 것도 우연이 아닙니다. 우칭윈은 AutoGen의 공동 제작자이자 AG2의 공동창업자로, 여러 에이전트가 대화하며 과제를 푸는 구조를 만들어 온 사람입니다. 이 논문이 열린 과제를 다중 에이전트 사회추리게임으로 변환한다는 발상을 낸 자리가 어디인지 짐작하게 하는 조합입니다.
배경
RLVR은 추론 모델 학습을 확장 가능하게 만들었습니다. 검증자 \(V(x, y) \in \{0, 1\}\)가 있으면 목표는 단순합니다.
\[\max_\theta \; \mathbb{E}_{x \sim \mathcal{D}, \, y \sim \pi_\theta(\cdot \mid x, \tau)} \left[V(x, y)\right]\]
\(V\)가 편향 없고 무제한이며 사실상 공짜인 지도 신호를 주기 때문에 확장이 됩니다. 문제는 이게 정답을 결정론적으로 확인할 수 있는 영역, 즉 수학과 코딩에 갇혀 있다는 점입니다.
요약이나 창작 글쓰기에서는 진짜 목표가 잠재 품질 함수 \(Q(x, y)\)인데 여기에 대응하는 검증자가 없습니다. 기존 연구는 \(V\)를 근사 평가자 \(\hat{V}\)로 갈아 끼웠습니다. 학습된 보상 모델, LLM 심판, 루브릭 채점이 여기 속합니다. 그런데 이 대체는 세 가지를 되불러옵니다. 평가 편향이 들어오고, 정책 성능이 평가자의 능력 상한에 묶이고, 롤아웃마다 추론 비용이 붙습니다.
논문이 지목하는 근본 원인은 이 방법들이 검증 불가능한 목표 \(Q\)를 직접 근사하려 든다는 것입니다.
여기서 자기지도학습을 끌어옵니다. 자기지도학습은 없는 라벨을 근사하는 대신 과제를 프리텍스트 목표로 변환합니다. 마스킹된 토큰을 복원하거나 관련 뷰를 무관한 샘플과 구별하는 식입니다. 프리텍스트 목표는 최종 다운스트림 과제와 다르지만 전이 가능한 표현과 능력을 유도합니다.
RLSVR은 이 발상을 라벨에서 보상으로 옮깁니다. 원래 과제를 프록시 환경으로 변환해서, 보상 검증 가능성이 그 환경의 내부 규칙이나 상호작용 결과에서 나오게 만듭니다.
어떻게 만들었나
과제 변환
변환 \(\Phi\)는 원래 과제 \((\mathcal{D}, \tau)\)를 프록시 환경 \(\mathcal{E}\)로 보냅니다. 환경은 입력 \(x \sim \mathcal{D}\)와 함께 잠재 변수 \(z\)를 샘플링해 그 에피소드의 정답으로 기록합니다. \(z\)는 여러 형태를 취할 수 있습니다. 여러 입력 중 어느 것이 교란됐는지, \(x\)의 어느 부분이 감춰졌는지, 각 출력이 어떤 조건 아래 생성됐는지. 중요한 것은 \(z\)의 실현값이 정책에게 직접 공개되지 않는다는 점입니다.
즉 검증 가능성이 과제의 본질적 속성이 아니라 설계로 만들어지는 것이라는 게 이 논문의 주장입니다.
SpyRL
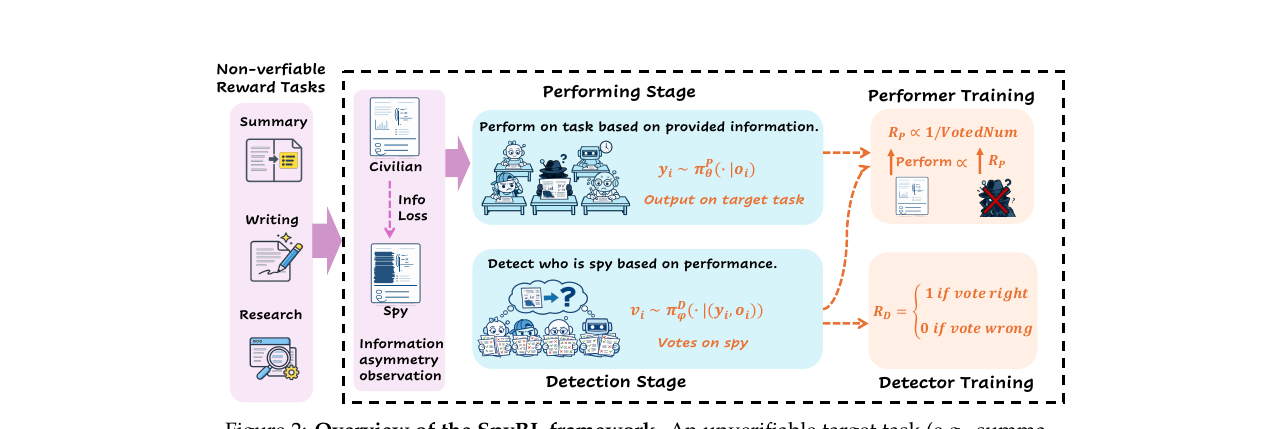
구현체는 사회추리게임 "누가 스파이인가"를 본떴습니다. 한 에폭이 수행(Performing) 단계와 탐지(Detection) 단계를 번갈아 돕니다.
정보 비대칭 배분. 매 에폭 인스턴스 \(x \sim \mathcal{D}\)를 뽑고 스파이 인덱스 \(u \sim \text{Unif}(\{1, \dots, n\})\)를 균등하게 뽑습니다. 플레이어 \(i\)의 사적 관측은
\[o_i = \begin{cases} x, & i \neq u \\ g(x), & i = u \end{cases}\]
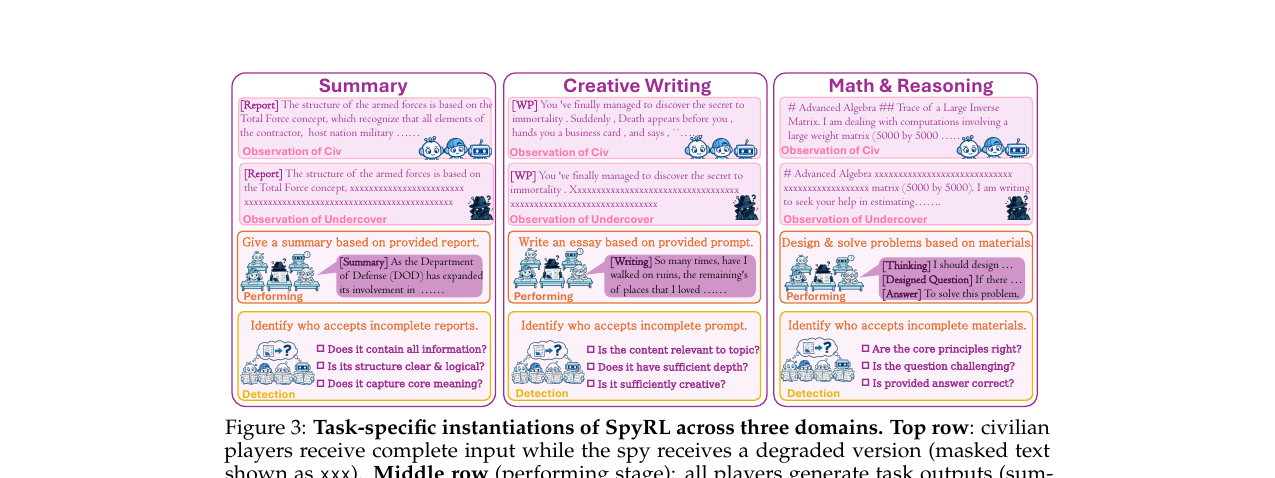
\(g(\cdot)\)는 정보 열화 연산자입니다. 논문의 구현은 연속 스팬 마스킹입니다. 중요한 것은 \(g\)가 과제 수행에 필요한 핵심 정보만 가리고 문체·길이·주제 일관성은 보존한다는 점입니다. 그러지 않으면 탐지자가 표면적 지름길로 스파이를 잡아냅니다.
수행 단계. 모든 플레이어가 자기 관측으로 같은 목표 과제를 수행합니다. 요약을 쓰거나, 이야기를 짓거나, 수학 문제를 만들고 풉니다. 출력은 전부 공개됩니다. 스파이로 지목당하지 않으려면 최선을 다해야 하므로, 수학에서는 더 명료하고 엄밀한 유도를, 창작에서는 더 자연스럽고 참신한 내용을 내놓게 됩니다. 여기서 "더 잘함"의 기준이 절대 품질 점수가 아니라 같은 그룹 안 동료 대비 상대 우위라는 점이 핵심입니다.
탐지 단계. 각 플레이어는 공개 출력 집합 \(Y = \{y_1, \dots, y_n\}\)과 자기 관측으로 상태 \(s_i = (o_i, Y)\)를 구성하고 스파이를 투표합니다. 스파이 신원 \(u\)는 환경이 정했으므로 탐지 보상은 \(r_i^D = \mathbb{1}[v_i = u]\)로 즉시 계산됩니다. 여기가 검증 가능성이 들어오는 지점입니다.
보상 설계
탐지 어드밴티지는 GRPO 방식 그룹 상대 정규화를 씁니다.
\[\mu_D = \frac{1}{n}\sum_{i=1}^{n} r_i^D, \quad \sigma_D = \sqrt{\frac{1}{n}\sum_{i=1}^{n}\left(r_i^D - \mu_D\right)^2}, \quad A_i^D = \frac{r_i^D - \mu_D}{\sigma_D + \epsilon}\]
그룹 안 상대 성능만으로 최적화 신호가 정해지므로 별도 크리틱 네트워크가 필요 없습니다. 그리고 탐지가 집단적이라 탐지자 한 명의 오판이 전체 궤적을 좌우하지 않습니다.
수행 단계 보상은 영합으로 설계합니다. 스파이가 받은 표 수를 \(m_u\), \(j\)번째 시민이 받은 표 수를 \(m_{c_j}\), 시민 평균을 \(\bar{m}_c\)라 두면
\[r_u^P = -\beta\left(m_u - \bar{m}_c\right), \qquad r_{c_j}^P = \frac{\beta}{n_c}\left(m_u - \bar{m}_c\right) - \lambda\left(m_{c_j} - \bar{m}_c\right)\]
\(\beta > 0\)은 스파이와 시민 사이 경쟁 신호의 강도, \(\lambda > 0\)은 시민 그룹 안 일관성 페널티를 조절합니다. 설계 결과 두 가지 성질이 따라옵니다. 첫째 \(r_u^P + \sum_{j=1}^{n_c} r_{c_j}^P = 0\)이라 스파이와 시민이 경쟁을 통해 계속 공진화합니다. 둘째 특정 시민이 다른 시민보다 표를 훨씬 많이 받으면 더 큰 페널티를 받으므로, 학습 신호가 근본적으로 상대적입니다.
Role-Advantage Estimation. 스파이와 시민은 구조적으로 다른 난이도를 마주하므로 원시 보상 분포가 불균형합니다. 그대로 쓰면 역할별 어드밴티지 추정에 체계적 편향이 생깁니다. RAE는 역할별 베이스라인을 빼서 이걸 보정합니다.
교대 최적화. 수행 정책 \(\pi_\theta^P\)와 탐지 정책 \(\pi_\phi^D\)를 따로 갱신합니다. 둘 다 GRPO 방식 클리핑 목적함수에 참조 정책 대비 KL 정규화를 붙입니다.
\[\mathcal{L}^P(\theta) = -\mathbb{E}\left[\frac{1}{n}\sum_{k \in \{u\} \cup \mathcal{C}}\sum_t \min\left(\rho^P_{k,t} A^P_k, \; \text{clip}(\rho^P_{k,t}, 1-\epsilon, 1+\epsilon) A^P_k\right)\right] + \beta_P \, \text{KL}(\pi_\theta^P \Vert \pi_{\text{ref}}^P)\]
한 단계를 갱신하는 동안 다른 쪽은 고정합니다. 탐지자가 스파이를 쉽게 잡게 되면 탐지를 더 강화해봐야 얻는 게 적으므로 수행 쪽으로 최적화를 옮기고, 반대로 수행 쪽 분포가 식별을 크게 어렵게 만들어 탐지 성능이 떨어지면 다시 탐지로 돌아옵니다.
설정
세 도메인입니다. 요약은 GovReport로 입력의 20%를 마스킹합니다. 창작은 WritingPrompts로 역시 20%입니다. 수학 추론은 Nemotron-CC-Math-v1으로 40%를 마스킹하는데, 수학 텍스트가 중복성과 구조적 규칙성이 크기 때문입니다.
배치 크기 1024로 100 에폭, 최대 생성 길이 2048 토큰, 기본 그룹 크기 \(n = 5\)입니다. 백본은 Qwen3-4B와 Qwen3-8B입니다. 베이스라인은 제안자-해결자 방식 자기플레이 프레임워크 R-Zero와 Absolute Zero입니다.
결과
검증 불가능한 과제
방법 |
GovReport |
Multi_News |
QmSum |
VcSum |
SamSum |
|---|---|---|---|---|---|
Qwen3-4B |
30.2 |
23.1 |
21.3 |
15.1 |
43.2 |
|
32.1 |
22.4 |
21.5 |
15.6 |
42.8 |
|
33.2 |
25.2 |
22.7 |
18.3 |
46.1 |
|
36.7 |
26.4 |
25.3 |
19.1 |
48.2 |
Qwen3-8B |
29.0 |
23.1 |
19.2 |
14.9 |
44.3 |
|
29.4 |
22.2 |
18.8 |
14.9 |
44.8 |
|
32.5 |
23.2 |
19.1 |
15.8 |
46.2 |
|
34.1 |
25.8 |
23.2 |
19.1 |
48.5 |
요약 ROUGE-L입니다. SpyRL이 두 백본 모든 벤치에서 최고입니다. GPT-4o 쌍대 A/B에서는 30개 칸 전부에서 과반을 이깁니다.
R-Zero가 Multi_News·SamSum에서 백본보다 오히려 떨어지는 것이 눈에 띕니다. 논문은 이 베이스라인들이 검증 가능한 해결자 피드백에 의존해 난이도를 조절하기 때문에 열린 과제에서 얻는 게 적다고 설명합니다.
창작 글쓰기는 GPT-4o 쌍대 승률로 보고합니다. Qwen3-4B 기준 SpyRL은 WritingPrompt 전체에서 백본 대비 81.3%, R-Zero 대비 78.9%, Absolute Zero 대비 75.6%를 기록합니다. 격차가 가장 큰 축은 참신성과 감정입니다. 표면 유창성이나 구조적 규칙성이 아니라 더 주관적인 축까지 개선됐다는 뜻입니다.
박사과정생 10명이 400개 프롬프트를 익명 평가한 결과도 같은 방향입니다. WritingPrompts에서 SpyRL이 Qwen3-4B 대비 80.0%, R-Zero 대비 78.5%, Absolute Zero 대비 74.0%로 앞섭니다.
검증 가능한 과제
방법 |
GSM8K |
Math500 |
AIME 24 |
AIME 25 |
Minerva |
MMLU-Pro |
GPQA-D |
|---|---|---|---|---|---|---|---|
Qwen3-4B |
84.5 |
68.2 |
10.3 |
6.7 |
42.3 |
51.6 |
26.3 |
|
88.7 |
72.8 |
10.3 |
6.7 |
47.1 |
52.8 |
27.8 |
|
89.3 |
76.2 |
12.2 |
13.4 |
41.9 |
52.6 |
35.3 |
|
93.4 |
79.5 |
13.3 |
20.0 |
47.8 |
57.4 |
41.3 |
Qwen3-8B |
91.8 |
74.2 |
15.3 |
12.1 |
49.3 |
58.1 |
33.3 |
|
92.1 |
78.4 |
15.3 |
14.2 |
52.5 |
61.7 |
34.3 |
|
92.0 |
76.6 |
18.4 |
18.2 |
52.9 |
62.5 |
36.8 |
|
93.5 |
81.2 |
20.0 |
23.3 |
56.3 |
63.1 |
39.8 |
이미 검증자가 있는 영역에서도 SpyRL이 전부 최고입니다. 7개 벤치 평균으로 Qwen3-4B는 41.4에서 50.4로, Qwen3-8B는 47.7에서 53.9로 올랐습니다. 초록의 "8.97%와 6.16%"는 이 평균의 절대 차이이지 상대 개선률이 아닙니다.
Absolute Zero가 GPQA-Diamond에서 백본보다 크게 오르는(26.3 → 35.3) 반면 Minerva에서는 떨어지는(42.3 → 41.9) 것처럼 들쭉날쭉한 데 비해, SpyRL은 14개 칸 전부에서 백본 이상입니다.
보상이 실제로 품질과 붙어 있는가
이 논문에서 가장 중요한 검증입니다. 투표가 품질과 무관하면 전체 설계가 무너집니다.
요약과 창작 각각 100 게임을 돌려 각 플레이어가 받은 의심 표 수를 기록하고, 동시에 GPT-4o에게 다섯 플레이어의 출력을 품질 순으로 매기게 했습니다(1이 최고). 표를 많이 받은 플레이어일수록 평균 순위 숫자가 큽니다. WritingPrompts에서 0표를 받은 플레이어가 평균 2.53위, 8표를 받은 플레이어가 4.80위입니다. GovReport도 2.50위에서 5.00위로 같은 방향입니다.
일반화
훈련 코퍼스를 정부 보고서에서 PubMed 과학 논문으로 바꾸고 게임 구성과 하이퍼파라미터를 그대로 둔 실험에서, ROUGE-L이 arXiv 28.1 → 32.5, PubMed 30.3 → 35.1, BillSum 41.3 → 46.8로 평균 4.9점 올랐습니다. A/B 승률은 각각 72.1%, 68.9%, 69.5%입니다.
교차 전이는 방향에 따라 갈립니다.
학습 도메인 |
요약 평가 |
창작 평가 |
|---|---|---|
창작 글쓰기 |
51.8~56.1% (양의 전이) |
- |
요약 |
- |
53.2~64.2% (양의 전이) |
수학 추론 |
41.7~45.6% (음의 전이) |
38.5~42.5% (음의 전이) |
요약과 창작은 내용 조직·완결성·담화 일관성·장거리 일관성을 공유하므로 양방향으로 전이됩니다. 수학 추론 모델은 두 글쓰기 과제 모두에서 미학습 백본보다 못합니다.
절제
설정 |
Epoch 0 |
20 |
40 |
60 |
80 |
100 |
|---|---|---|---|---|---|---|
Only Performing |
68.2 |
70.1 |
71.8 |
72.2 |
71.9 |
72.3 |
Only Detection |
68.2 |
69.0 |
69.4 |
69.0 |
69.2 |
69.2 |
Without spy |
68.2 |
69.6 |
71.1 |
69.8 |
70.5 |
71.6 |
SpyRL |
68.2 |
73.3 |
78.2 |
78.8 |
79.3 |
79.5 |
Math500 정확도입니다. 수행 단계만 학습하면 초반에는 오르다가 40 에폭 근처에서 정체합니다. 탐지 모듈이 고정돼 있으면 모델 능력이 자라면서 점점 정교해지는 응답들 사이의 품질 차이를 못 가려내고 보상이 왜곡되기 때문입니다. 탐지만 학습하면 목표 과제 개선이 거의 없습니다. 스파이 메커니즘을 빼도 비슷하게 정체합니다.
RAE 절제 결과는 더 극적입니다. 역할별 베이스라인 감산을 빼면 7개 벤치 평균이 50.4에서 37.5로 떨어지는데, 이건 백본의 41.4보다도 낮습니다. GSM8K, Math500, Minerva, MMLU-Pro, GPQA-Diamond 전부 백본보다 나빠집니다. 논문의 설명은 명확합니다. 역할 인지 보정이 없으면 옵티마이저가 스파이의 정보 열세를 정책 품질 저하로 착각하고, 그래디언트가 학습을 늦추는 정도가 아니라 모델을 적극적으로 망칩니다.
그룹 크기는 3에서 5로 갈 때 평균 이득이 5.5에서 9.3으로 가장 크게 뛰고, 6과 8에서는 한계수익이 줄어듭니다.
\(g(\cdot)\) 민감도는 낮습니다. 마스킹 비율 20%와 40%가 다섯 벤치에서 거의 구별되지 않고 어느 쪽도 일관되게 낫지 않습니다. RAE가 각 역할의 자기 기준으로 보상을 재중심화하기 때문에, 연산자가 게임을 얼마나 어렵게 만들든 플레이어는 자기 역할 기대치를 넘으면 양의 신호를 받습니다.
회고
논문에 별도 Limitations 절이 없어서 결과 안에 흩어진 제약을 모아야 합니다.
가장 큰 것은 루브릭 기반 강한 베이스라인과의 비교입니다. SpyRL은 Qwen3.5-27B-RaR을 전 차원에서 이기지만(전체 승률 59.3%, 56.2%), GPT-4o-RaR 상대로는 WritingPrompt 전체 48.9%, WritingBench 전체 48.2%로 오히려 밀립니다. 일관성(44.5%, 43.7%)과 응집성(45.8%, 45.0%)에서 특히 뒤집니다. 앞서는 차원은 참신성과 감정뿐입니다. 논문 스스로 "경쟁력 있다(competitive)"고만 쓰고 이긴다고는 하지 않습니다. 검증자를 없앤 대가가 없지는 않고, 대신 $900의 검증자 비용을 아꼈다는 것이 세일즈 포인트입니다.
수학 추론 모델의 음의 전이도 그대로 남습니다. 요약 41.7~45.6%, 창작 38.5~42.5%로 미학습 백본보다 못합니다. 논문은 수학이 기호 조작과 다단 추론을 강화하는데 이게 글쓰기의 문체·담화 요구와 겹치지 않는다고 설명하지만, 자기플레이 학습이 다른 능력을 실제로 깎을 수 있다는 관찰 자체는 그대로입니다.
보상이 상대적이라는 설계도 양날입니다. 그룹 안 동료보다 잘하면 양의 신호가 나옵니다. 이건 절대 품질의 상한을 어디에도 고정하지 않는다는 뜻이기도 합니다. 논문은 100 에폭 안에서 정체 없이 오르는 것을 보여주지만, 더 길게 돌렸을 때 성능이 어디에 수렴하는지는 다루지 않습니다.
\(g(\cdot)\)가 유일한 과제별 수동 설계 부품이라는 점도 남습니다. 민감도가 낮다는 절제 실험이 있지만, 그건 스팬 마스킹이라는 한 가지 형태 안에서 비율만 바꾼 비교입니다. 마스킹이 통하지 않는 도메인에서 무엇을 열화시킬지는 여전히 사람이 정해야 합니다.
정리
검증 가능성이 과제의 본질적 속성이 아니라 설계로 만들 수 있는 것이라는 주장이 이 논문의 전부입니다. 열린 과제를 프록시 환경으로 옮기고, 환경이 미리 정한 잠재 변수를 정답으로 삼으면 보상이 구성상 검증 가능해집니다.
SpyRL은 그 구현으로 출력 품질 평가를 신원 식별 문제로 바꿉니다. 표를 많이 받은 플레이어가 실제로 낮은 품질을 냈다는 상관관계 실험이 이 대체가 성립함을 보여주고, 수행·탐지 교대 최적화와 역할별 어드밴티지 보정이 없으면 학습이 정체하거나 역행합니다.
다만 GPT-4o 루브릭이라는 가장 비싼 베이스라인은 아직 넘지 못했습니다. 이 논문의 실제 위치는 "검증자를 없애도 비슷한 수준까지 간다"이지 "검증자보다 낫다"가 아닙니다.