UrbanGround - From Local Perception to Spatial Agency in a Real-Scale City
T. Ju, Z. Wu, Y. Sun, Y. Cui, et al., "UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City," arXiv:2608.27456, 2026.
멀티모달 모델에게 거리 사진을 보여주고 "앞에 보이는 건물이 무슨 방향에 있나요"라고 물으면 대체로 맞힙니다. 그런데 그 모델을 실제로 걷게 하면 이야기가 달라집니다. 모퉁이를 한 번 돌면 방금 판단의 근거가 된 랜드마크가 시야에서 사라지고, 모델은 그 사라진 근거를 자기 위치 추정으로 옮겨 담아야 합니다.
이 논문은 그 옮겨 담기가 되는지를 묻습니다. 저자들은 이것을 공간 주체성(spatial agency)이라고 부르고, 인식 능력과 분리해서 측정할 수 있는 환경을 만들었습니다.
저자
저자 18명에 상하이교통대, 싱가포르국립대, 메이투안, 홍콩중문대, 상하이대, 옥스퍼드가 붙어 있습니다. 기관이 여섯 개나 되는 구성은 보통 컨소시엄처럼 보이지만, 여기서는 한 사람의 이동 경로에서 자연스럽게 나온 조합에 가깝습니다.
1저자 Tianjie Ju는 상하이교통대 박사과정으로 Gongshen Liu 교수와 Zhuosheng Zhang 부교수의 지도를 받고 있고, 2024년 10월부터 1년간 싱가포르국립대 CTIC에 방문 학생으로 있었습니다. 그때 지도를 맡은 Mong-Li Lee 교수와 Wynne Hsu 교수가 저자 목록에 함께 있습니다. 교신저자는 Hao Fei(옥스퍼드), Qi Gu(메이투안), 류궁선, 장줘성 네 명이고 프로젝트 리드는 장줘성입니다.
합류 동기는 직전 작업에서 읽힙니다. 같은 팀이 2026년에 MineExplorer: Evaluating Open-World Exploration of MLLM Agents in Minecraft를 냈습니다. 마인크래프트에서 개방형 탐색을 평가한 연구입니다. 게임 샌드박스로 한 번 해보고 나면 남는 불만이 하나 있습니다. 게임 안에서 잘한다는 것이 실제 공간에서 잘한다는 뜻인지 알 수 없다는 것입니다. 게임의 공간 구조는 게임이 정의하기 때문입니다. UrbanGround는 그 불만에 대한 답이고, 그래서 도시를 새로 만들지 않고 이미 존재하는 도시를 그대로 가져왔습니다.
장줘성이 프로젝트 리드를 맡은 것도 이 맥락에서 읽힙니다. 그는 You Only Look at Screens에서 접근성 트리 없이 화면 픽셀만 보고 GUI를 조작하는 에이전트를 다뤘습니다. 화면을 읽는 능력과 그 읽기를 행동으로 옮기는 능력을 분리해서 보는 시각이 그때부터 있었고, UrbanGround는 화면 자리에 도시를 놓은 셈입니다.
배경
이 문제를 다루려는 시도는 크게 세 갈래로 있었고, 저자들은 각 갈래가 무엇을 놓치는지부터 정리합니다.
첫째는 게임 환경입니다. MineDojo나 GROOT 계열은 긴 궤적과 반복 상호작용을 지원하고, 시간이 지나면서 결정이 어떻게 전개되는지 보여줍니다. 다만 성공이 게임 고유의 메커닉에 좌우됩니다. 게임 안에서 진전을 냈다고 해서 에이전트가 자기 관측을 게임 바깥에서도 유효한 공간 좌표계에 고정했다는 뜻은 아닙니다.
둘째는 실내 체화 환경입니다. 장면 기하 안에 인식과 행동을 넣어 질의응답과 내비게이션을 봅니다. 물리적 공간에 행동을 고정한다는 점은 맞지만, 공간의 범위가 한정돼 있어서 국소 관측을 얼마나 큰 공간 프레임과 연결해야 하는지가 잘 드러나지 않습니다.
셋째는 도시 규모 연구입니다. 스트리트뷰 이미지나 항공 파노라마로 도시 규모의 내비게이션을 평가합니다. 실제 지리 맥락은 보존되지만 상호작용이 시각적 뷰를 통해 매개됩니다. 에이전트가 같은 도시 기하 위를 연속적으로 물리 이동해서 시점이 바뀌는 것이 아니라, 샘플링된 시점 사이를 건너뛰는 것입니다. 인터랙티브 도시 시뮬레이터는 행동과 관측의 닫힌 루프를 되살리지만, 그 환경이 생성되거나 조립된 것이라 실존하는 대도시의 복잡한 지리 구조를 온전히 보존하지 못합니다.
남는 빈자리가 명확합니다. 모든 관측과 모든 이동이 하나의 실규모 세계와 일관되게 유지되어야 하는 조건에서, 강한 국소 멀티모달 능력이 공간 주체성으로 합성되는지를 아무도 확인하지 못했습니다.
어떻게 만들었나
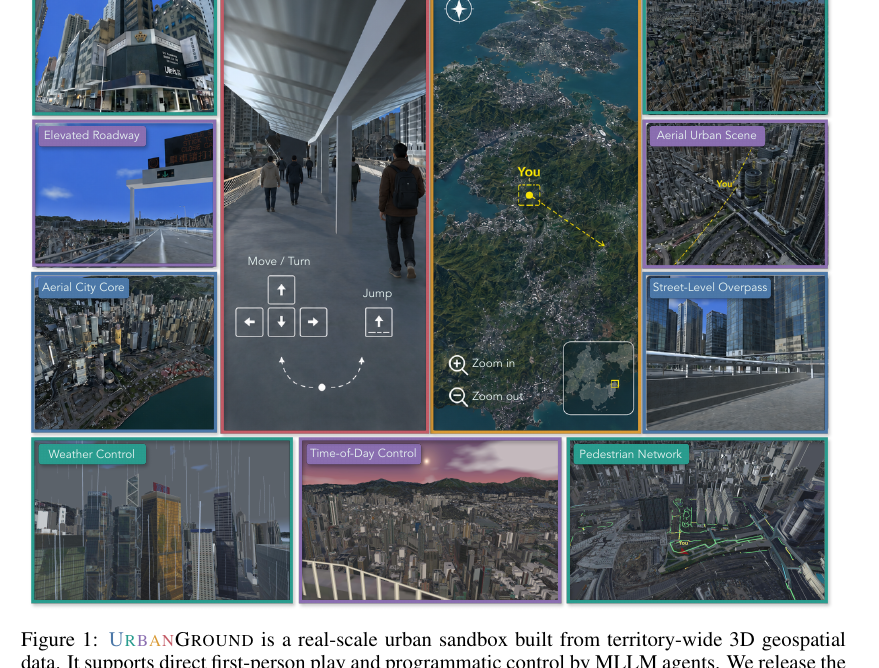
UrbanGround는 Unity 기반이고 세 개 층으로 나뉩니다. 이 분리 덕분에 평가 대상 모델이 바뀌어도 지리 세계와 체화 방식은 고정됩니다.
지리 층. 홍콩 지정처(Lands Department)가 공개한 3D 디지털 맵 두 종을 씁니다. 3D Visualisation Map은 경사 항공 촬영으로 재구성한 타일 기반 텍스처 메시로 홍콩 전역을 덮고, WGS84 좌표계의 Cesium 3D Tiles로 공개 API를 통해 배포됩니다. 3D Pedestrian Network는 보행 관련 도로 기록에서 파생된 지리 참조 3D 선 형상으로, 보행 공간이 어떻게 연결돼 있는지를 담습니다. 전자가 도시의 겉모습이고 후자가 도시의 연결 구조입니다.
UrbanGround는 이 타일 계층을 런타임에 Unity로 불러오면서 각 타일의 지리 좌표를 공유 시뮬레이션 프레임으로 변환합니다. 타일은 현재 시야 스케일에 따라 스트리밍되고, 렌더링되는 도시 표면과 캐릭터 컨트롤러가 쓰는 충돌 기하를 같은 타일이 공급합니다.
여기서 설계상 중요한 결정이 하나 있습니다. 보행자 네트워크는 같은 좌표계에 연결 그래프로 들어오지만, 에이전트를 그 그래프의 엣지 위로 강제하지 않습니다. 에이전트는 연속 공간에서 자유롭게 움직이고, 그 궤적을 나중에 등록된 네트워크와 대조합니다. 그래서 "길을 벗어났는가"가 실패가 아니라 측정 대상이 됩니다.
시뮬레이션 층. 등록된 도시를 계속 변하는 환경으로 만드는 층입니다. 에이전트는 1인칭 캐릭터로 인스턴스화되고 이동은 도시 메시에서 파생된 충돌 기하에 대해 연속적으로 해결됩니다. 건물과 벽과 고도 변화가 궤적을 실제로 제약하며, 좌표를 갱신하는 것만으로 보이는 구조물을 통과할 수 없습니다.
시계는 하늘, 태양 위치, 주변 조도, 그림자를 제어합니다. 같은 장소가 낮에서 황혼과 밤으로 바뀌고, 어두워지면 인공 조명이 켜져 주간과 다른 가시성의 관측을 만듭니다. 날씨는 비와 안개를 지원하는데, 비는 장면과 상호작용하는 입자를 만들어 에이전트가 현재 위치에서 비에 노출되는지를 시뮬레이터가 판정할 수 있게 합니다. 이 노출 신호가 실행된 궤적에서 지붕 덮인 길과 열린 거리를 구분합니다.
보행자는 오픈소스 Microsoft Rocketbox 아바타 라이브러리에서 가져와 인도에 배치합니다. 등록된 네트워크 위에 생성되고 엣지를 따라 배정된 경로를 걸으며, 위치와 충돌이 매 스텝 기록됩니다. 그래서 내비게이션 성공을 궤적의 안전성과 함께 볼 수 있습니다.
에이전트 층. 외부 멀티모달 모델을 실행 중인 Unity 환경에 붙입니다. 시뮬레이터와 모델은 별도 프로세스로 돌고 클라이언트-서버 인터페이스로 통신하기 때문에, Unity 구현을 고치지 않고도 다른 모델과 에이전트 프레임워크가 같은 체화를 제어할 수 있습니다.
닫힌 루프는 이렇게 정의됩니다. 턴 \(t\)의 은닉 상호작용 상태를 \(s_t\), 과제 목표를 \(g\), 상호작용 맥락에 실려 있는 작업용 공간 상태를 \(m_t\), 시뮬레이터가 실행하는 구조화된 행동을 \(a_t\)로 두면
\[\begin{aligned} o_t &= \mathcal{O}(s_t), \\ m_0 &= \mathcal{U}_0(o_0, g), \\ m_t &= \mathcal{U}(m_{t-1}, o_t, a_{t-1}, g), \quad t \geq 1, \\ a_t &= \pi(m_t, g), \\ s_{t+1} &= \mathcal{T}(s_t, a_t, \xi_t). \end{aligned}\]
평가 대상 모델은 \(s_t\)를 직접 읽지 못하고 관측 번들 \(o_t\)만 봅니다. 모델을 향한 인터페이스는 남은 거리나 최단 경로나 경로 API 같은 특권 정보를 일절 노출하지 않습니다. \(\xi_t\)가 실행 도중 바뀔 수 있는 외부 조건이고, 도로 폐쇄 사건이나 보행자 움직임이 여기에 들어갑니다.
\(m_t\)가 이 정의의 핵심입니다. 저자들은 이것을 명시적 메모리 모듈로 가정하지 않고 평가자가 관측하지도 않습니다. 모델의 상호작용 맥락 안에 유도된 공간 정보를 분석적으로 기술한 것일 뿐입니다. 즉 이 벤치마크는 "메모리를 붙였는가"를 묻지 않고 "무엇을 붙였든 그 상태가 행동을 목표 쪽으로 계속 이끄는가"를 묻습니다.
행동 공간은 매 턴 정확히 하나를 고르게 돼 있습니다.
\[\mathcal{A} = \mathcal{A}_{\text{fp}} \cup \mathcal{A}_{\text{map}} \cup \{\texttt{terminate}\}\]
\[\mathcal{A}_{\text{fp}} = \{\texttt{move}, \texttt{sprint}, \texttt{look}, \texttt{jump}, \texttt{open\_map}\}\]
\[\mathcal{A}_{\text{map}} = \{\texttt{map\_select}, \texttt{map\_pan}, \texttt{map\_zoom}, \texttt{map\_orbit}, \texttt{close\_map}\}\]
move와 sprint는 네 방향 중 하나와 지속 시간을 지정하고, 같은 행동 안에서 시야를 돌리도록 yaw_rate와 pitch_rate를 함께 넣을 수 있습니다. 방향 필드가 이미 측면 이동을 표현하므로 strafe는 별도 행동이 아닙니다. 지도는 지리 참조된 조감뷰와 현재 위치를 표시하지만 계산된 경로나 강조된 경로를 노출하지 않습니다.
무엇으로 구성돼 있나
과제는 다섯 단계 사다리로 조직됩니다. 인터페이스는 고정한 채, 성공에 필요한 공간 상태의 양만 올라갑니다.
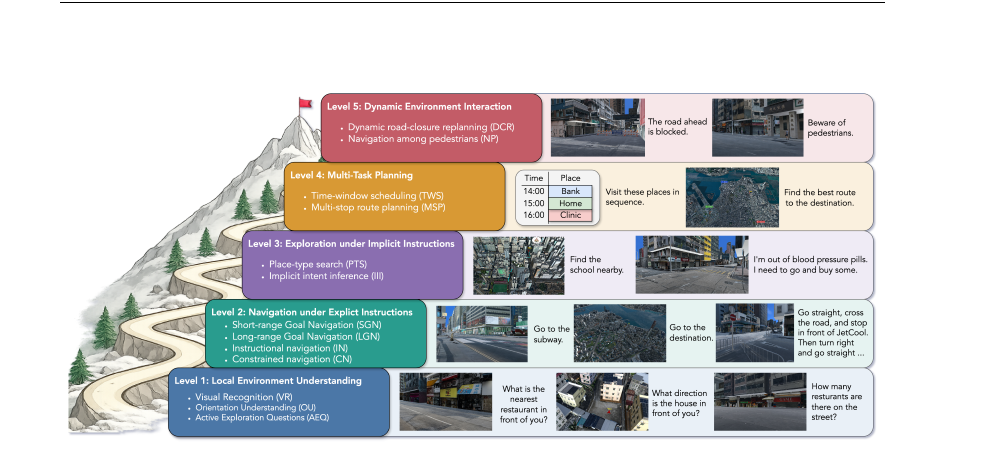
레벨 1은 국소 환경 이해입니다. 시각 인식과 방위 이해가 현재 자세 주변에서 무엇을 고정할 수 있는지 시험하고, 능동 탐색 질의는 초기 시야 밖의 근거를 짧게 찾아오게 합니다. RQ1의 주 과제입니다.
레벨 2는 명시적 지시 하의 내비게이션입니다. 단거리와 장거리 목표 내비게이션이 같은 지점 대 지점 과제를 서로 다른 경로 스케일에서 평가하고, 지시 내비게이션은 언어 지시 시퀀스를, 제약 내비게이션은 사용 가능한 경로 제한을 실행 중에 유지하는지 봅니다.
레벨 3은 암묵적 지시 하의 탐색으로, 장소 유형 검색과 의도 추론이 목적지를 먼저 추론하게 합니다. 레벨 4는 다중 과제 계획으로, 시간창 스케줄링과 다중 경유지 경로 계획이 여러 목표에 걸친 계획을 유지하고 실행하게 합니다. 레벨 2에서 4까지가 RQ2의 과제입니다.
레벨 5는 동적 환경 상호작용입니다. 일회성 시스템 공지가 이미 시작된 경로를 무효화하는 도로 폐쇄를 알리고, 사용 불가 구간은 지도에 표시된 채로 남습니다. 움직이는 보행자는 보이는 장애물을 피해 이동을 조정하게 합니다. 여기에 레벨 1과 레벨 2 단거리 과제에 적용되는 시간·날씨 변형이 더해져 RQ3의 과제가 됩니다.
인스턴스는 사람이 직접 검증한 810개이고, 레벨별로 220, 240, 120, 120, 110개입니다. 합이 초록에 적힌 810과 일치합니다. 모든 인스턴스는 멀티모달 에이전트와 동일한 100스텝 제한 아래에서 사람 테스터가 완료했습니다. 이동 행동 하나가 최대 2초이므로 이 예산은 최대 200초의 명령된 이동을 허용하고, 따라서 모델 실패를 "평가 지평 안에서 애초에 불가능한 과제였다"로 돌릴 수 없습니다. 벤치마크 설계에서 자주 빠지는 방어인데 여기서는 챙겨져 있습니다.
평가 모델은 GPT-5.5, GPT-5.4, GPT-5.2, Claude-Opus-5, Claude-Opus-4.6, Gemini-3.6-Flash, Gemini-3.1-Pro, Doubao-Seed-2.0-Pro, GLM-5V-Turbo, Kimi-K3입니다.
결과
지표를 먼저 짚습니다. Acc는 정답 일치율이고, PNA(pedestrian-network adherence)는 전체 행동 시간 중 행동 이후 상태가 등록된 보행자 네트워크 위에 있는 비율입니다. 단일 목적지 내비게이션은 최종 위치가 목적지에서 15미터 이내이고 평가자가 강제한 제약을 만족할 때 성공입니다.
국소 근거는 잡힙니다
모델 |
시각 인식 (%) |
방위 이해 (%) |
능동 탐색 (%) |
종합 Acc (%) |
종합 PNA (%) |
|---|---|---|---|---|---|
GPT-5.5 |
82.5 |
40.0 |
62.5 |
63.6 |
76.8 |
GPT-5.4 |
75.0 |
31.7 |
57.5 |
56.8 |
77.7 |
GPT-5.2 |
77.5 |
33.3 |
48.8 |
55.0 |
78.2 |
Claude-Opus-5 |
91.3 |
58.3 |
82.5 |
79.1 |
80.2 |
Claude-Opus-4.6 |
85.0 |
46.7 |
73.8 |
70.5 |
79.5 |
Gemini-3.6-Flash |
93.8 |
56.7 |
77.5 |
77.7 |
79.0 |
Gemini-3.1-Pro |
82.5 |
23.3 |
46.3 |
53.2 |
73.6 |
Doubao-Seed-2.0-Pro |
85.0 |
36.7 |
63.8 |
64.1 |
76.4 |
GLM-5V-Turbo |
80.0 |
36.7 |
52.5 |
58.2 |
76.8 |
Kimi-K3 |
92.5 |
55.0 |
76.3 |
76.4 |
75.5 |
시각 인식은 대부분 80% 위입니다. 지시와 근거가 모두 명시적일 때 모델들은 주변 시각 환경을 정확히 이해합니다. 능동 탐색으로 넘어가 짧은 행동 시퀀스로 빠진 근거를 찾아와야 할 때도 정확도가 완만하게만 떨어집니다.
문제는 방위입니다. 시각 인식 대비 낙폭이 큽니다. GPT-5.5는 82.5에서 40.0으로, Gemini-3.1-Pro는 82.5에서 23.3으로 떨어집니다. 4지선다에서 무작위 추측 기준선이 25%인데 몇몇 시스템이 거기에 근접합니다. 보이는 랜드마크를 식별하는 것과 그 랜드마크의 방향을 현재 진행 방향 기준으로 안정되게 표상하는 것이 별개라는 뜻입니다.
세대 차이가 어디서 벌어지는지도 이 표에서 보입니다. GPT-5.2와 Gemini-3.1-Pro는 시각 인식에서는 최신 모델과 가깝지만 방위 이해와 능동 탐색에서 크게 뒤처집니다. 최근의 개선이 주로 방향 정보를 보존하는 능력에 집중돼 왔다는 해석이 가능합니다.
PNA는 다른 종류의 이야기를 합니다. 국소 과제에서도 완전한 준수에 한참 못 미칩니다. 에이전트들은 사용자에게 빨리 답하려고 필요한 근거까지의 지름길을 택하며 도로 준수를 희생하는 경향을 보입니다. 실제 이동 제약이 빠른 과제 완료와 경쟁할 때 공간 추론의 지속적인 일부로 유지되지 않는다는 뜻입니다.
논문의 Figure 6이 이 장면을 하나 보여줍니다. GPT-5.5에게 베이징 통렌탕 옆 은행이 무엇인지 묻자, 에이전트는 약국을 제대로 찾아 옆 가게로 접근해 Bank of East Asia라고 정확히 답합니다. 그런데 빨리 끝내려고 도로를 직접 가로질러 등록된 보행 연결을 벗어납니다. 답은 맞고 행동은 틀린 경우입니다.
몇 블록만 넘어가면 무너집니다
모델 |
SN |
LN |
IN |
CN |
PS |
II |
TW |
MS |
종합 |
|---|---|---|---|---|---|---|---|---|---|
GPT-5.5 |
75.0 |
0.0 |
20.0 |
0.0 |
35.0 |
11.7 |
3.3 |
0.0 |
20.8 |
GPT-5.4 |
15.0 |
1.3 |
20.0 |
0.0 |
15.0 |
11.7 |
1.7 |
0.0 |
8.3 |
GPT-5.2 |
25.0 |
0.0 |
28.0 |
0.0 |
8.3 |
15.0 |
1.7 |
3.3 |
10.6 |
Claude-Opus-5 |
48.8 |
2.5 |
30.0 |
3.3 |
30.0 |
11.7 |
3.3 |
3.3 |
17.9 |
Claude-Opus-4.6 |
75.0 |
1.3 |
28.0 |
6.7 |
36.7 |
15.0 |
1.7 |
1.7 |
22.9 |
Gemini-3.6-Flash |
23.8 |
0.0 |
6.0 |
0.0 |
23.3 |
3.3 |
0.0 |
1.7 |
8.1 |
Gemini-3.1-Pro |
31.3 |
0.0 |
8.0 |
0.0 |
18.3 |
6.7 |
0.0 |
0.0 |
9.2 |
Doubao-Seed-2.0-Pro |
26.3 |
1.3 |
6.0 |
0.0 |
15.0 |
10.0 |
0.0 |
0.0 |
8.3 |
GLM-5V-Turbo |
50.0 |
0.0 |
18.0 |
0.0 |
25.0 |
15.0 |
0.0 |
0.0 |
15.2 |
Kimi-K3 |
67.5 |
3.8 |
42.0 |
6.7 |
31.7 |
15.0 |
0.0 |
0.0 |
22.5 |
SN은 단거리, LN은 장거리, IN은 지시, CN은 제약, PS는 장소 검색, II는 의도 추론, TW는 시간창, MS는 다중 경유지 내비게이션입니다. 종합은 여덟 하위 과제의 인스턴스 수 가중 평균입니다.
읽는 방식은 SN 열과 LN 열을 나란히 놓는 것입니다. 같은 지점 대 지점 과제를 경로 스케일만 늘려서 평가한 것인데, GPT-5.5는 75.0에서 0.0으로, Claude-Opus-4.6은 75.0에서 1.3으로 갑니다. 최고치가 Kimi-K3의 3.8입니다.
이 낙폭이 왜 이상한지가 논문의 핵심 논증입니다. 겉보기에 추가된 난이도는 이동 거리뿐이고, 긴 경로는 짧은 목표들의 연쇄로 분해할 수 있습니다. 중간 목표들을 유지할 수만 있다면 하나씩 풀어서 결국 도착해야 합니다. 그런데 그렇게 되지 않습니다. 저자들의 결론은 현재 모델이 단거리 원자 능력을 장거리 탐색으로 합성하지 못한다는 것이고, 이유는 실행 중에 오차가 누적되는데 효과적인 교정이 없기 때문입니다.
거리 자체가 원인이 아니라는 증거도 있습니다. 지시 내비게이션은 경로 길이가 단거리와 비슷한데도 성능이 크게 떨어집니다. 에이전트가 사용자의 요청을 안정된 목표로 변환하고 관측이 바뀌는 동안 그 목표를 계속 따라가야 하는데, 그 유지가 안 되는 것입니다.
저자들은 ShortNav과 InstructionNav 에피소드를 초기 직선 거리 기준 4분위로 나눠 다시 봤습니다. 두 과제군 모두에서 성공이 짧은 거리 구간에 몰려 있고 지평이 늘수록 단조롭게 떨어집니다. 단거리와 장거리 사이에 불연속적인 절벽이 있는 것이 아니라, 명목상 국소인 과제 안에서도 상호작용 지평이 길어지면 닫힌 루프 실행이 체계적으로 약해집니다.
한 가지 더 흥미로운 관찰이 있습니다. 국소 질의응답에서는 모델 간 격차가 크지 않은데 내비게이션에서는 크게 벌어집니다. 같은 GPT 계열 안에서도 GPT-5.5(75.0)와 GPT-5.4(15.0)가 단거리에서 갈립니다. 모든 행동이 다음 관측과 결정 맥락을 바꾸기 때문에, 공간 복구 능력의 작은 차이가 에피소드 전체에서 복리로 불어납니다. 고립된 질의응답이 드러내지 못하는 층입니다.
도시가 바뀌면 계획이 안 바뀝니다
시간과 날씨를 바꿨을 때의 국소 질의응답 정확도입니다.
모델 |
맑음 |
황혼 |
밤 |
흐림 |
비 |
|---|---|---|---|---|---|
GPT-5.5 |
63.6 |
59.1 |
61.4 |
62.7 |
61.4 |
GPT-5.4 |
56.8 |
44.6 |
48.6 |
58.2 |
53.6 |
GPT-5.2 |
55.0 |
44.1 |
48.6 |
55.9 |
53.6 |
Claude-Opus-5 |
79.1 |
66.4 |
69.6 |
75.5 |
70.5 |
Claude-Opus-4.6 |
70.5 |
55.5 |
63.2 |
69.1 |
67.7 |
Gemini-3.6-Flash |
77.7 |
68.6 |
72.7 |
71.4 |
73.4 |
Gemini-3.1-Pro |
53.2 |
42.3 |
37.3 |
46.8 |
45.5 |
Doubao-Seed-2.0-Pro |
64.1 |
57.7 |
60.9 |
66.8 |
64.1 |
GLM-5V-Turbo |
58.2 |
46.4 |
47.8 |
56.8 |
55.0 |
Kimi-K3 |
76.4 |
65.0 |
62.7 |
75.9 |
72.3 |
낙폭이 모델마다 다릅니다. GPT-5.5와 Gemini-3.6-Flash는 조건이 바뀌어도 비교적 안정적인데, GPT-5.4와 Gemini-3.1-Pro는 크게 흔들립니다. 기본 조건에서 잘한다는 것이 조도가 바뀌었을 때도 안정적이라는 보장은 아니라는 뜻입니다.
반직관적인 관찰이 하나 있습니다. 가시성은 밤이 더 낮은데 에이전트들은 대체로 황혼에서 더 못합니다. 저자들은 황혼 시점의 조명 조건이 간섭을 일으키는 것으로 추정합니다.
그리고 이 조건 변화가 단거리 내비게이션에는 일관되게 영향을 주지 않습니다. 질의응답 정확도를 떨어뜨리는 조건이 내비게이션 성공을 꼭 떨어뜨리지는 않고, 조건 간 순서도 모델마다 달라집니다. 겉모습 변화만으로는 내비게이션 실패를 설명할 수 없고, 경로 상태 유지와 행동 실행이 따로 걸려 있다는 뜻입니다.
세계 자체를 바꿨을 때가 더 결정적입니다.
모델 |
폐쇄 SR (%) |
폐쇄 PNA (%) |
폐쇄 SPR (%) |
보행자 SR (%) |
보행자 PCR (%) |
|---|---|---|---|---|---|
GPT-5.5 |
0.0 |
94.7 |
13.3 |
0.0 |
83.8 |
GPT-5.4 |
0.0 |
96.4 |
16.7 |
0.0 |
80.0 |
GPT-5.2 |
0.0 |
94.2 |
16.7 |
1.3 |
78.8 |
Claude-Opus-5 |
0.0 |
93.6 |
46.7 |
2.5 |
87.5 |
Claude-Opus-4.6 |
3.3 |
93.0 |
26.7 |
3.8 |
80.0 |
Gemini-3.6-Flash |
0.0 |
95.4 |
16.7 |
0.0 |
90.0 |
Gemini-3.1-Pro |
0.0 |
93.4 |
16.7 |
0.0 |
88.8 |
Doubao-Seed-2.0-Pro |
0.0 |
93.5 |
10.0 |
0.0 |
76.3 |
GLM-5V-Turbo |
0.0 |
93.3 |
20.0 |
0.0 |
82.5 |
Kimi-K3 |
3.3 |
95.1 |
40.0 |
2.5 |
78.8 |
SR은 목표 도달률, SPR은 안전 진행률로 도로 폐쇄를 존중한 에피소드의 비율, PCR은 보행자 충돌률입니다. PCR은 낮을수록 좋습니다.
이 표의 요점은 PNA 열과 SPR 열의 대비입니다. PNA는 전부 93% 위인데 SPR은 대부분 20% 아래입니다. 경로가 무효화된 뒤에도 에이전트는 여전히 국소적으로 규칙에 맞는 이동을 계속 생산합니다. 보행자 네트워크 위를 잘 걷고 있는데, 그 걸음이 목표를 향한 안전한 진전으로 회복되지 않습니다. 그럴듯하게 계속 움직이는 것과 계획을 고치는 것이 완전히 다른 일이라는 게 여기서 드러납니다.
보행자 충돌률은 모든 모델에서 76% 이상입니다. 네트워크 위에 남아 있다는 것이 충돌을 인지한 제어를 뜻하지 않습니다.
같은 분리가 모든 공간 스케일에서 반복됩니다. 모델은 국소 근거를 인식하는 것보다 그것을 방위 지우는 것을 덜 안정적으로 하고, 유용한 국소 이동을 실행하는 것보다 경로를 완주하는 것을 덜 안정적으로 하며, 규칙에 맞는 이동을 유지하는 것보다 도시가 바뀐 뒤 계획을 갱신하는 것을 덜 안정적으로 합니다. 근거로 잡힌 공간 상태가 행동을 목표로 이끄는 일을 멈추는 시점이, 에이전트가 그럴듯한 국소 이동을 멈추는 시점보다 훨씬 앞섭니다.
회고
저자들이 부록에서 자기 결과를 다시 의심한 부분이 이 논문에서 가장 값어치 있는 대목입니다.
장거리 내비게이션 성공률이 0에 수렴한다는 것은 두 가지로 읽힐 수 있습니다. 하나는 에이전트가 애초에 목표 쪽으로 나아가지도 못했다는 것이고, 다른 하나는 나아갔다가 되돌아왔다는 것입니다. 저자들은 GPT-5.5의 동일한 LongNav 에피소드를 대상으로, 행동은 하나도 바꾸지 않고 최종 상태 대신 가장 목표에 가까웠던 체크포인트로 재채점하는 오라클을 돌렸습니다.
GPT-5.5 |
성공률 (%) |
시작보다 가까워짐 (%) |
20% 이상 단축 (%) |
평균 잔여 비율 (%) |
|---|---|---|---|---|
관측된 최종 상태 |
0.0 |
57.5 |
34.6 |
98.9 |
오라클 체크포인트 |
0.0 |
98.7 |
67.9 |
67.3 |
읽으면 그림이 뒤집힙니다. 최종 상태만 보면 57.5%의 에피소드만 시작보다 목표에 가깝고 평균 잔여 거리 비율이 98.9%입니다. 거의 제자리로 돌아온 것처럼 보입니다. 그런데 중간 어느 시점을 보면 98.7%가 시작보다 가까웠고 평균 잔여 비율이 67.3%였습니다. 에이전트는 거의 항상 목표 쪽으로 실제로 나아갔고, 그다음에 그 진전을 잃었습니다.
다만 저자들은 여기서 멈추지 않고 한계도 같이 적습니다. 오라클로 재채점해도 성공률은 여전히 0.0%입니다. 후반부 퇴행이 LongNav 실패에 기여하기는 하지만 전부를 설명하지는 않습니다.
실패 유형 분류도 같은 이야기를 합니다. GPT-5.5의 LongNav 실행을 네 갈래로 나눈 결과입니다.
실행 종료 패턴 |
비율 (%) |
|---|---|
실질적 진전을 냈다가 나중에 잃음 |
31.25 |
실질적 진전을 한 번도 못 냄 |
27.50 |
도착 반경 밖에서 스스로 종료 |
22.50 |
진전은 유지했으나 예산 소진 |
18.75 |
가장 큰 몫이 "냈다가 잃음"입니다. 유용한 이동을 시작하지 못하는 문제가 아니라 불안정한 진전이 문제라는 뜻이고, 일관된 전역 방위 유지와 공간 상태 보존과 잘못된 회전 이후의 복구에 약점이 있다는 것을 가리킵니다. 도착 반경 밖에서 스스로 종료하는 22.5%는 자기 위치 추정이나 도착 판정의 보정이 나쁘다는 별개의 신호입니다.
지적하고 넘어갈 지점도 있습니다. 이 부록 분석은 전부 GPT-5.5 한 모델에 대해서만 수행됐습니다. Table 2에서 종합 최고는 Claude-Opus-4.6이고 LongNav 최고는 Kimi-K3인데, 이들의 실패가 같은 모양인지는 이 논문으로 알 수 없습니다. "냈다가 잃음"이 모든 모델의 공통 실패 양식인지 GPT-5.5의 특성인지가 열려 있습니다.
숫자 정합성은 확인했습니다. 초록의 810개 인스턴스가 레벨별 220 + 240 + 120 + 120 + 110과 정확히 맞습니다. 사람 테스터가 동일한 100스텝 예산 안에서 전 인스턴스를 완료했다는 조건도 명시돼 있어, 실패를 과제 난이도로 돌리는 해석을 미리 막아뒀습니다.
정리
국소 인식은 이미 됩니다. 그 인식을 이동 중에 붙들고 있는 것이 안 됩니다. 시각 인식은 80~90%대인데 같은 과제를 몇 블록 늘리면 성공률이 0에 수렴합니다. 긴 경로가 짧은 목표의 연쇄로 분해된다는 점을 감안하면, 이 낙폭은 능력의 부재가 아니라 상태 유지와 오차 교정의 부재를 가리킵니다.
부록의 오라클 재채점이 실패의 모양을 바꿔 놓습니다. 최종 상태만 보면 에이전트가 헤맨 것처럼 보이지만, 중간 체크포인트로 보면 98.7%가 목표에 실제로 접근했습니다. 문제는 나아가지 못하는 것이 아니라 나아간 것을 잃는 것입니다. 다만 재채점해도 도착률은 0이므로, 후반 퇴행이 유일한 원인은 아닙니다.
계속 그럴듯하게 움직이는 능력이 계획을 고치는 능력을 가립니다. 도로가 폐쇄된 뒤에도 보행자 네트워크 준수율은 93% 위로 유지되는데 안전 진행률은 20% 아래입니다. 규칙에 맞는 이동을 계속 생산하는 것이 상황 변화에 적응했다는 신호가 아니라는 뜻이고, 에이전트 평가에서 준수 지표만 보면 이 구분이 안 보입니다. World Action Models 계열이 행동 모델을 키우는 쪽이라면, UrbanGround는 그 모델이 어디서 무너지는지 재는 쪽입니다.