WorldClaw - Agentic 3D Open-World Generation at Scale
C. Guo, J. Li, Y. Li, and Z. Huang, "WorldClaw: Agentic 3D Open-World Generation at Scale," arXiv:2608.05248, 2026.
문장 하나로 걸어 다닐 수 있는 3D 세계를 만드는 일은 오래된 목표입니다. 그런데 이 목표에는 서로 잘 안 맞는 요구가 세 개 동시에 들어 있습니다. 세계 전체가 공간적으로 앞뒤가 맞아야 하고, 가까이 가서 봐도 볼 것이 있어야 하고, 나중에 게임 엔진에 넣어 오브젝트 하나를 집어 옮길 수 있어야 합니다.
지금까지는 이 셋을 한 모델이 한 번에 풀려는 시도가 많았습니다. Tencent Hunyuan의 WorldClaw는 반대로 갑니다. 세 요구를 단계별로 쪼개서 서로 다른 에이전트에게 맡기고, 각 단계가 남긴 중간 산출물을 다음 단계의 제약으로 넘깁니다.
저자
기여자 명단이 네 명입니다. 대형 모델 논문치고 이례적으로 작습니다.
프로젝트 리더는 궈춘차오와 리양입니다. 궈춘차오는 Hunyuan 3D 팀을 이끌면서 3D-DiT 계열 생성 모델과 HunyuanWorld를 내놓은 사람입니다. 이 논문이 Hunyuan3D를 오브젝트 복원 백본으로, 개념적으로는 HunyuanWorld의 다음 걸음으로 놓여 있는 이유가 여기 있습니다.
황쯔룽은 시맨틱 세그멘테이션과 픽셀 단위 예측을 오래 한 연구자입니다. WorldClaw에서 지역 합성 이미지를 SAM3로 인스턴스 단위로 뜯어내는 부분이 이 배경과 맞닿아 있습니다. 씬을 통째로 복원하지 않고 인스턴스를 먼저 분리하겠다는 선택은 세그멘테이션 쪽 사람이 아니면 잘 안 나오는 발상입니다.
리진펑은 지역 씬 생성 갈래의 첫 이름으로 올라 있습니다. 지형 위에 오브젝트를 실제로 앉히는 좌표 복원 부분이 이 갈래입니다.
배경
논문은 기존 연구를 네 갈래로 정리합니다.
절차적 생성은 규칙과 프로그램으로 지형과 식생과 건물을 만듭니다. Infinigen이 대표적입니다. 통제 가능하고 규모를 키우기 쉽지만, 표현력이 규칙의 표현력을 못 넘습니다. 이미지·비디오 리프팅은 생성 모델로 관측을 만들고 깊이 추정이나 다중 뷰 복원으로 3D에 올립니다. Marble이 여기 있습니다. 내용은 풍부한데 전역 일관성과 기하 정확도가 약하고, 집 한 채를 만들려고 집 주위를 도는 긴 영상을 뽑아야 해서 계산이 비쌉니다. 영상이 안 훑은 시점으로 카메라를 옮기면 흐려집니다.
네이티브 3D 디퓨전은 복셀이나 거리장이나 가우시안 위에서 씬 분포를 직접 학습합니다. 기하 정확도와 뷰 간 일관성이 좋지만 대규모 3D 씬 데이터가 없어서 다양성이 막힙니다. 마지막이 멀티모달 LLM 에이전트입니다. 의도 이해, 공간 계획, 툴 오케스트레이션에서 강합니다. 대신 정밀한 3D 공간 제어가 안 됩니다. 논문이 든 예가 구체적입니다. 오브젝트 하나 위치를 조정하라고 하면 공간 스케일 감각이 부족해서 과보정합니다.
WorldClaw의 출발점은 이 네 번째 갈래의 약점을 인정하는 데 있습니다. 에이전트에게 좌표를 직접 다루게 하지 않습니다. 대신 좌표는 기하학으로 풀고, 에이전트는 계획하고 렌더 결과를 보고 판정하는 자리에만 둡니다.
어떻게 만들었나
설계를 한 문장으로 요약하면 이렇습니다. 전역적으로 일관된 세계를 만들자고 해서 모든 곳을 한꺼번에 생성할 필요는 없습니다.
씬 의미론, 공간 조직, 지형 기반처럼 공유되는 제약을 먼저 전역에서 세우고, 지역을 구분 짓는 오브젝트와 국소 관계는 필요한 곳에서만 점진적으로 실현합니다. 파이프라인은 세 단계입니다.
\[P = F_{\text{plan}}(q), \quad T = F_{\text{terrain}}(P), \quad O = F_{\text{region}}(P, T)\]
\(q\)는 사용자 프롬프트, \(P\)는 구조화된 씬 명세, \(T\)는 전역 지형 표현, \(O\)는 배치된 지역 오브젝트 집합입니다. 최종 세계는 \(S = \text{Compose}(T, O)\)로 합성됩니다.

의도 분석과 계획
첫 단계가 흥미로운 이유는 역할을 둘로 쪼갰기 때문입니다.
의도 분석 에이전트는 프롬프트에 명시적으로 적힌 제약만 뽑아 정규화합니다. 씬 타입, 테마와 시각 스타일, 주요 지역과 오브젝트, 공간 관계, 사용자 선호입니다. 이 단계는 새 내용을 만들지 않고 빠진 속성을 채우지도 않습니다. 그 다음 씬 계획 에이전트가 모호한 서술을 해소하고 빠진 정보를 스키마에 맞춰 채웁니다.
명시적 제약 추출과 결측 정보 보완을 분리한 이유는 사용자 의도를 보존하기 위해서입니다. 한 에이전트가 둘을 같이 하면 "중세 마을"이라는 말에서 자기가 상상한 중세 마을로 흘러가면서 사용자가 실제로 요구한 것이 뭐였는지 흐려집니다.
결과는 \(P = (R, C_{\text{terrain}}, C_{\text{object}})\)로 조직됩니다. \(R\)은 주요 지역과 속성과 공간 관계, \(C_{\text{terrain}}\)은 지형 타입과 지형 특성과 표면 외관, \(C_{\text{object}}\)는 오브젝트 카테고리와 외관 속성과 대략적 밀도입니다.
전역 지형 생성
많은 씬 생성 파이프라인이 지면을 평면이나 약한 기복으로 단순화하고 그 위에 오브젝트를 놓는 식으로 씬을 조직합니다. WorldClaw는 이 가정을 걷어냅니다. 지형이 기하학적 기반일 뿐 아니라 지역 의미론과 공간 위계를 조직하는 전역 구조라고 봅니다.
지형 계획 에이전트가 구조화된 지형 명세를 만듭니다.
\[P_{\text{terrain}} = (p_{\text{layout}}, p_{\text{asset}}, p_{\text{material}}, \theta_{\text{terrain}})\]
\(\theta_{\text{terrain}}\)에 들어가는 것이 월드 스케일, 지역별 기준 고도, 노이즈 주파수와 진폭, 지형 연산자와 가중치, 경계 블렌딩 폭입니다. 이 수치들이 명세 안에 명시적으로 박혀 있다는 점이 중요합니다. 나중에 렌더를 보고 고칠 때 에이전트가 손댈 대상이 바로 이 값들입니다.
지형 에셋 생성 단계는 시맨틱 레이아웃 맵 \(I_{\text{layout}}\)을 만듭니다. 실내 씬 생성이 쓰는 평면도나 방 구조 표현은 벽이 반듯하고 영역이 대체로 평평한 경우를 전제하므로 곡선 경계와 불규칙한 형태를 가진 자연 지형에는 안 맞습니다. 그래서 지형 카테고리를 서로 다른 색으로 인코딩한 2D 공간 분할 지도를 씁니다. 이 한 장이 이후 지역 마스크 추출, 높이장 생성, 재질 할당, 에셋 산포에 전부 쓰입니다.
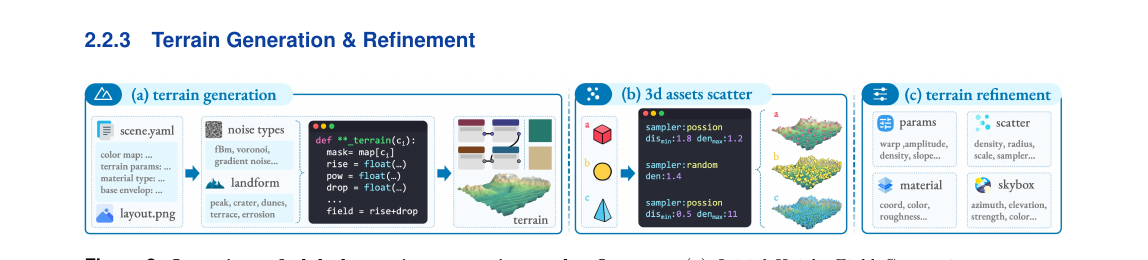
전역 높이장은 다음과 같이 구성됩니다.
\[H(x) = \sum_r \tilde{m}_r(x) \left[ h_r + \sum_k w_{r,k} N_{r,k}(x) + \sum_j \alpha_{r,j} G_{r,j}(x) \right]\]
\(x\)는 지형 도메인의 2D 위치, \(h_r\)은 지역 \(r\)의 기준 고도, \(N_{r,k}\)는 특정 공간 주파수의 노이즈 성분, \(G_{r,j}\)는 봉우리·사구·계단·침식 같은 지형 연산자입니다. \(\tilde{m}_r\)은 경계 평활화로 얻은 정규화된 소프트 가중치입니다.
이 식이 region-aware height field가 전역 일관성의 앵커가 되는 이유를 그대로 보여줍니다. 지역마다 다른 지형이 만들어지는데, 그것이 각각 별도로 생성된 조각이 아니라 하나의 높이장 위에서 소프트 가중치로 섞인 결과입니다. 경계에서 튀지 않습니다. 그리고 같은 가중치 \(\tilde{m}_r\)이 재질 할당과 에셋 산포에도 재사용되므로, 지형과 표면 외관과 식생 분포가 같은 공간 분할을 공유합니다. 스케일 파라미터만 바꾸면 같은 구성 논리로 다른 크기의 세계를 만들 수 있습니다.
지형 정제 단계는 BlenderMCP로 정해진 시점에서 씬을 다시 렌더하고, 기하와 재질과 산포 결과와 렌더 설정을 점검한 뒤 국소적으로 고칩니다. 고칠 수 있는 변수가 지역별 지형 파라미터, 경계 블렌딩, 재질 텍스처 스케일, 에셋 밀도와 변환, 필요하면 환경 조명과 렌더 설정입니다. 문제가 안 잡히거나 반복 예산이 소진될 때까지 돕니다.
지역 오브젝트 생성과 배치
전역 지형이 서면, 인스턴스 단위 내용이 필요한 지역만 골라 채웁니다. 이 부분이 이 논문에서 가장 촘촘한 곳입니다.
각 지역에 대해 먼저 기존 지형을 렌더하고 카메라 파라미터 \(\kappa_r = (K_t, E_t)\)를 기록해 지형 이미지 \(I^{\text{terrain}}_r\)를 얻습니다. 그 다음 이 렌더를 조건으로 지역 합성 이미지를 만듭니다.
\[I^{\text{comp}}_r = G_{\text{image}}\left(I^{\text{terrain}}_r, P_r, I_{\text{concept}}\right)\]
고립된 지역 이미지를 바로 합성하지 않고 지형 렌더를 조건으로 쓴 이유는 국소 지세와 재질 외관과 시선 방향과 주변 공간 맥락을 보존하기 위해서입니다. 합성 이미지는 최종 3D 기하로 취급되지 않습니다. 오브젝트 외관과 공간 조직을 동시에 구속하는 명시적 2D 레이아웃 사전으로만 씁니다.
이미지에서 인스턴스를 떼어내는 데는 텍스트 유도 SAM3를 씁니다. 전체 이미지 추론에 더해 겹치는 슬라이딩 윈도우 추론으로 다양한 크기의 오브젝트 재현율을 올리고, 국소 예측을 합성 이미지 좌표계로 되돌린 뒤 의미 레이블과 공간 중첩으로 중복 제거하고 병합합니다. 씬 전체를 하나의 3D로 복원하면 인스턴스 단위 품질, 오브젝트 경계 분리, 정확한 배치 복원이 전부 어려워지기 때문입니다.
여기서 좌표 처리가 세심합니다. 인스턴스마다 잘라 확대한 오브젝트 중심 이미지를 만들고, 합성 이미지 좌표에서 오브젝트 중심 이미지 좌표로 가는 어파인 변환 \(A_i\)를 기록합니다. 크롭 후 등가 내부 파라미터는 \(\hat{K}_i = A_i K_t\)입니다. 크롭과 리사이즈는 이미지 좌표계만 바꾸므로 외부 파라미터는 \(E_t\) 그대로입니다. \(A_i\)와 \(\hat{K}_i\)를 기록해 두면 작은 오브젝트를 확대해도 원래 이미지 위치와 지형 카메라에 대한 기하 관계가 보존됩니다.
단일 뷰 복원은 스케일이 틀어지므로 이미지 공간에서 보정합니다. \(B(I)\)를 전경 바운딩 박스 면적과 이미지 면적의 비라 하고 \(b^{\text{ref}}_i = B(I_i)\)라 할 때, 스케일 인자 \(\lambda_i\)를 다음이 만족될 때까지 반복 조정합니다.
\[-\epsilon^-_i \leq B\left(\Pi(K^o_i, \lambda_i M^c_i)\right) - b^{\text{ref}}_i \leq \epsilon^+_i\]
허용 오차를 비대칭으로 둔 것이 실무적입니다. 과대 복원을 더 강하게 억제하고, 세그멘테이션 경계와 단일 뷰 모호성 때문에 생기는 약간의 미달은 허용합니다.
배치는 광선 두 개로 풉니다. 오브젝트 복원 카메라에서 오브젝트 중심 픽셀로 광선을 쏴 카메라 공간 메시와 교차시켜 기준점 \(P_o\)와 깊이 \(Z_o\)를 얻습니다. 초점 이미지 중심을 \(A_i^{-1}\)로 합성 이미지에 되돌리고, 지형 카메라에서 그 픽셀로 두 번째 광선을 쏴 지형 메시와의 가장 가까운 양의 교점에서 앵커 \(P_t\)와 깊이 \(Z_t\)를 얻습니다. 초기 스케일은 다음과 같습니다.
\[s_i = \frac{Z_t f^o_i}{Z_o \hat{f}_i}\]
최종 배치 변환은 \(P_o\)를 정확히 \(P_t\)로 옮깁니다.
\[T^i_{\text{place}} = \begin{bmatrix} s_i R_i & P_t - s_i R_i P_o \\ \mathbf{0}^T & 1 \end{bmatrix} T^i_{\text{l2c}}\]
메시 이산화와 단일 뷰 깊이 오차 때문에 생기는 미세한 부유를 줄이려고, 2D 투영을 보존한 채 지형 카메라 광선을 따라 앵커 깊이와 등방 스케일을 함께 탐색합니다. 오브젝트 바닥 복셀과 지형의 접촉 비율이 임계값에 도달하면 종료하고, 아니면 접촉 비율이 가장 높은 후보를 남깁니다.
여기가 이 논문이 앞서 지적한 LLM 에이전트의 약점을 우회한 지점입니다. 오브젝트를 어디에 놓을지 에이전트에게 좌표로 물어보지 않습니다. 카메라 기하가 답을 내고, 에이전트는 그 답이 이상해 보이는지만 판정합니다.
렌더 기반 정제 루프
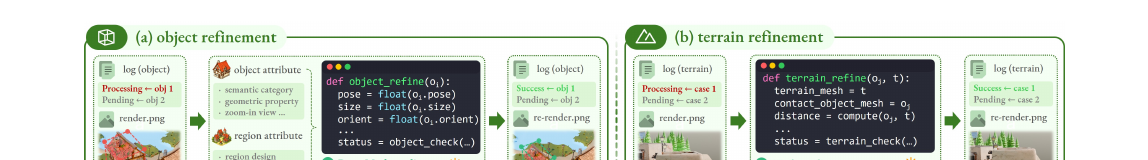
씬 정제 에이전트는 MCP 같은 실행 인터페이스로 Blender에 붙습니다. 진단 렌더와 상태 리포트로 이뤄진 작업 큐를 유지하면서 오브젝트 정제를 먼저, 그다음 지형 정제를 합니다.
오브젝트 정제는 각 오브젝트의 포즈와 메시 품질과 스케일을 의미 카테고리, 기하 속성, 주변 지역의 설계와 오브젝트 구성에 비춰 평가합니다. 스케일이 안 맞거나 방향이 이상하면 배치 변환을 갱신해 고칩니다. SAM3D 복원이 기하나 외관 품질이 부족하면 스케일 보정된 거친 메시와 오브젝트 중심 이미지를 함께 조건으로 Hunyuan3D를 돌립니다. 거친 메시가 구조 제약을 주고 이미지가 형상과 외관 단서를 주므로, 오브젝트 정체성과 전체 형상을 크게 바꾸지 않으면서 표면 기하와 텍스처를 개선합니다. 정제된 에셋은 기존 \(T^i_{\text{place}}\)를 그대로 상속하므로 배치를 다시 할 필요가 없습니다.
지형 정제는 부유, 과도한 관통, 불안정한 지지를 봅니다. 결함이 잡히면 국소 지지 영역 안에서 오브젝트와 지형을 함께 변형합니다. 오브젝트를 수직으로 옮기거나 부분적으로 파묻고, 지지하는 지형은 국소적으로 눌리거나 평탄화되거나 매끄러워져 오브젝트 발자국에 맞춥니다. 모든 수정은 지지 영역으로 제한해 전역 지형과 인접 구조를 보존합니다.
이 루프가 기존 피드포워드 씬 생성과 다른 지점은 세 가지입니다. 첫째, 정제 대상이 픽셀이나 잠재 벡터가 아니라 명시적으로 파라미터화된 변수입니다. 지형 파라미터, 배치 변환, 재질 스케일처럼 이름이 붙은 값을 고칩니다. 둘째, 판정 근거가 렌더된 이미지입니다. 모델이 자기 출력의 확률을 보는 게 아니라 결과물을 눈으로 보고 판단합니다. 셋째, 종료 조건이 있습니다. 검사를 통과하거나 반복 예산이 소진될 때까지만 돕니다.
결과
이 논문은 정량 벤치마크 표를 내지 않습니다. 전부 정성 비교입니다. 이 점은 뒤에서 다시 짚겠습니다.
구현은 Claude Opus 4.8을 에이전트 모델로 씁니다. 사전학습 파운데이션 모델로 GPT-Image-2, SAM3, SAM3D, Hunyuan3D를 태스크별 에이전트 스킬로 붙였습니다. 오브젝트 품질 정제에서 큰 오브젝트에는 2048×2048, 작은 오브젝트에는 1024×1024 PBR 텍스처 맵을 씁니다. 실험은 NVIDIA H20 4장이 달린 서버 한 대에서 돌았고 렌더링과 씬 구성은 Blender 5.1.1입니다. H20 4장이라는 규모는 눈여겨볼 만합니다. 생성 자체를 학습하는 논문이 아니라 기존 모델을 조립하는 논문이라 가능한 숫자입니다.
정성 비교 대상은 다섯 개입니다. 같은 중세 마을 테마 프롬프트로 맞췄습니다.
방법 |
지형·지역 조직 |
인스턴스 편집 |
주된 약점 |
|---|---|---|---|
SynCity |
블록 단위 3D 잠재로 씬 규모 합성 |
없음 (씬 수준 표현) |
장거리 조직이 약하고 지형 타입 전이가 불분명 |
Marble |
지역 수준 조직 없음 |
없음 (씬 수준 표현) |
카메라가 멀어지면 기하가 무너지고 가까이서 가우시안 프리미티브가 드러남 |
MajutsuCity |
도시 지향이라 지면이 비교적 규칙적 |
있음 |
대규모 지형 구성보다 인스턴스 배치에 치우침 |
WorldGen |
일관되고 통행 가능하나 평탄·균질 |
있음 (명시적 텍스처 메시) |
표시된 뷰 사이 내용 변화가 제한적 |
GPT-5.6 Sol |
단순한 기하 형태로 실현, 전이가 거침 |
있음 |
단순·반복 기하와 기본 재질로 블록아웃 같은 외관 |
WorldClaw |
시맨틱 레이아웃 맵 기반 연속 전역 지형 |
있음 |
아래 §회고 참조 |
표를 읽는 법은 이렇습니다. 오른쪽 두 열이 사실상 이 논문의 주장입니다. 씬 수준 표현만 내놓는 방법(SynCity, Marble)은 시각적으로 좋아 보여도 게임 엔진 워크플로에 넣을 수 없습니다. 인스턴스를 내놓는 방법(MajutsuCity, WorldGen, GPT-5.6 Sol)은 넣을 수 있는데 지형이 평평하거나 규칙적이거나 거칩니다. WorldClaw는 명시적 전역 지형과 독립적으로 복원·배치된 오브젝트 메시를 결합해 두 열을 동시에 채웠다고 주장합니다.
가장 가까운 베이스라인으로 논문이 지목한 것은 WorldGen입니다. 명시적 텍스처 메시를 만들고 통행 가능한 뷰에서 국소 구조가 안정적이라 다운스트림 활용도 면에서 가장 근접하다고 적었습니다. 경쟁자를 스스로 지목한 서술이라 신뢰할 만합니다.
정성 결과는 열대 해적 섬, 부족 정착지가 있는 강 협곡, 사막 전장, 미래 시설이 있는 설산 계곡 네 가지 프롬프트로 보여줍니다. 부록에는 중세 마을, 눈 덮인 강변 마을, 용이 있는 사막 캠프, 일본풍 마을이 있는 섬, 화산 마굴, 보석 채굴장, 호빗풍 마을 계곡이 더 있습니다. 각 예시는 전역 뷰, 지역 뷰, 걷기 뷰에 더해 인스턴스·깊이·노멀 렌더가 붙습니다. 인스턴스 렌더를 같이 낸 것은 오브젝트가 실제로 분리돼 있다는 증거를 제시하는 방식입니다.
회고
저자들이 한계를 셋으로 정리했습니다. 자기 방법의 구조적 취약점을 정확히 짚었습니다.
첫째, 기반 모델 의존이 높습니다. 세계 구성을 여러 단계로 쪼개 이종 모델에게 나눠 맡긴 대가입니다. 실험에서 현재 오픈소스 언어 모델은 실행 가능하면서 사용자 요구와 일치하는 절차적 지형과 재질을 생성하는 데 자주 실패했고, 오픈소스 이미지 생성 모델은 쓸 만한 시맨틱 레이아웃 맵을 못 만들거나 오브젝트 생성·추출 과정에서 외관과 포즈를 보존하지 못하는 일이 잦았습니다. 최종 씬의 시각 품질은 3D 생성 백본의 상한에 그대로 묶입니다. 결국 현 시점에서 이 분해된 파이프라인을 온전히 검증하려면 Claude Opus 4.8, GPT-Image-2, Hunyuan3D 급 모델이 필요하다고 적었습니다. 재현성 관점에서는 무거운 고백입니다.
둘째, 코드 생성 안정성입니다. 지형 구성, 절차적 재질 생성, 에셋 배치, 국소 정제 여러 단계가 LLM이 생성한 프로그램에 의존합니다. 스케일 추정, 수치 파라미터, 노드 연결에서 난 오류가 그대로 3D 씬의 어긋난 지형, 부정확한 재질 효과, 의도에서 벗어난 배치로 나타나고, 렌더·검사·정제를 여러 번 돌아야 합니다. Blender처럼 API와 노드 기반 워크플로가 복잡한 전문 3D 소프트웨어에서 특히 두드러진다고 적었습니다. 아티스트가 정교한 노드 그래프로 만드는 재질 효과가 생성된 프로그램에서는 단순한 근사로 축소되는 일이 잦습니다.
셋째, 효율 오버헤드입니다. 인스턴스 단위 편집 가능성을 얻으려고 오브젝트를 각각 생성·복원하고 지형·에셋·접촉 관계에 걸쳐 여러 라운드의 에이전트 정제를 돕니다. 이 롱호라이즌 파이프라인은 상당한 추론 지연과 계산 비용을 내고, 오브젝트 수와 정제 반복이 늘수록 같이 늘어납니다. 저자들도 단순한 씬에는 이 파이프라인이 불필요하게 길고 비효율적이라고 인정합니다.
여기에 독자가 더 짚을 것이 하나 있습니다. 정량 평가가 없습니다. 비교는 전부 정성 서술이고 그림입니다. 3D 씬 생성 분야에 합의된 정량 지표가 마땅치 않다는 사정은 있지만, 프롬프트 정합도나 기하 안정성이나 인스턴스 분리 정확도 같은 것은 측정할 수 있는 대상입니다. "우리 것이 더 낫다"는 판정을 그림 여덟 장에 맡긴 셈이라, 이 논문의 주장은 재현 실험 전까지는 검증되지 않은 상태로 남습니다. 저자들이 한계 섹션에 이 점은 적지 않았습니다.
결론 섹션은 다음 방향으로 코드 네이티브 3D 모델링을 제시합니다. 생성 3D 모델은 기하와 외관 다양성은 주지만 명시적 부품 위계, 파라메트릭 구조, 관절 정의, 상호작용 논리를 일관되게 복원하지 못합니다. WorldClaw는 이미 지형 재질에서 이 방향을 실험했습니다. 에이전트가 Blender 재질 노드 그래프와 셰이더 스크립트 같은 실행 가능한 절차로 재질을 구성했고, 결과가 명시적으로 파라미터화되고 편집하기 쉬웠습니다. 실행 가능한 프로그램이 오브젝트 기하뿐 아니라 복잡한 씬 외관도 표현할 수 있다는 신호로 읽습니다.
정리
이 논문에서 가져갈 것은 세 가지입니다.
첫째, 전역 일관성을 지키는 방법으로 지형 높이장을 앵커로 쓴 설계입니다. 지역마다 다른 지형을 만들되 하나의 높이장 위에서 소프트 가중치로 섞고, 같은 가중치를 재질과 에셋 산포에 재사용합니다. 별도 조각을 이어붙인 게 아니라 처음부터 하나였던 구조라 경계에서 안 튑니다.
둘째, LLM 에이전트에게 3D 좌표를 직접 시키지 않은 선택입니다. 논문 스스로 지적한 에이전트의 공간 스케일 감각 부족을, 카메라 기하로 배치를 풀고 에이전트는 렌더를 보고 판정만 하게 만들어 우회했습니다. 에이전트를 어디에 쓰고 어디에 안 쓸지 나눈 기준으로 참고할 만합니다.
셋째, 이 결과가 프런티어 모델 조합에 묶여 있다는 사실입니다. 저자들이 직접 밝혔듯 오픈소스 모델로는 파이프라인이 서지 않았습니다. 에이전트 파이프라인 논문을 읽을 때 방법이 얼마나 일반적인지와 특정 모델 조합에 얼마나 의존하는지를 나눠서 봐야 하는 이유입니다.