Demystifying Agent Skills - Why They Work Until They Don't
Z. Jiang, F. Huang, H. Xing, X. Wu, Y. Gao, R. Cao, M. Wang, S. Liu, and Y. Li, "Demystifying Agent Skills: Why They Work-Until They Don't," arXiv:2608.14036, 2026.
에이전트에게 스킬을 붙이면 성능이 오른다는 것은 이미 여러 번 측정되었습니다. 그런데 왜 오르는지는 아무도 제대로 답한 적이 없습니다. 지금까지의 평가는 전부 총합 성공률 하나였습니다. 스킬을 붙인 에이전트가 과제를 더 많이 풀면 그 스킬은 유용한 것으로 처리됩니다. 이 방식은 스킬이 중요하다는 사실은 확인해 주지만, 스킬이 로드된 전과 후에 에이전트의 행동에서 정확히 무엇이 달라졌는지, 왜 같은 스킬이 어떤 과제는 돕고 어떤 과제는 망치는지는 하나도 설명하지 못합니다.
이 논문은 그 질문을 정면으로 잡습니다. 언제 돕는가, 왜 작동하는가, 어디서 실패하는가.
저자
공동 1저자는 Zhiyuan Jiang, Fangrui Huang, Hanwen Xing, Xander Wu, Yipeng Gao입니다. 장즈위안은 프린스턴 대학교 인턴십 기간에 이 작업을 수행했습니다. 교신저자는 Mengdi Wang, Shilong Liu, Yijiang Li 세 명이고, 소속은 프린스턴, UC 샌디에이고, 스탠퍼드, 서던캘리포니아, 존스홉킨스 다섯 곳에 걸쳐 있습니다.
세 교신저자의 조합이 이 논문의 성격을 설명합니다. 왕멍디는 강화학습 이론에서 출발해 LLM 에이전트 학습으로 넘어온 연구자로, "에이전트 추론에서 RL이 실제로 무엇을 하는가"를 분해한 이전 작업들이 이번 논문의 문제의식과 같은 형태입니다. 총합 지표 대신 메커니즘을 보자는 것입니다. 류스룽은 Grounding DINO의 저자로, 사람이 준 자연어 설명을 모델이 어디까지 일반화해 쓰는지를 오래 다뤄왔습니다. 스킬 문서 역시 사람이 쓴 절차 설명이라는 점에서 같은 질문의 다른 판입니다. 리이장은 멀티에이전트 시스템 설계와 에이전트 평가 쪽에서 왔습니다.
배경
에이전트가 매번 맨땅에서 시작하지 않고 경험으로 나아지기를 바라는 흐름은 이제 기본값에 가깝습니다. 그래서 최근 에이전트 시스템들은 이전 실행의 흔적을 저장하고 재사용합니다. 환경 셋업 순서, 도구 사용 패턴, 디버깅 루틴, 검증 단계 같은 것들입니다. 도구를 쓰는 에이전트에서 특히 매력적인데, 반복되는 실패가 고차원 추론의 부족이 아니라 같은 절차적 세부 사항을 계속 다시 발견하는 데서 오는 경우가 많기 때문입니다.
여러 메모리 형태 중에서 스킬이 두드러진 이유는 그것이 단순한 실행 기록이 아니기 때문입니다. 스킬은 무엇을 할지, 무엇을 확인할지, 어떤 함정을 피할지를 압축해 적은 문서입니다. 원시 궤적이나 워크플로 메모리를 그대로 저장하는 것에 비해 세 가지를 약속합니다. 노이즈가 섞인 경험을 짧은 컨텍스트로 압축하고, 절차적 지식을 안정된 형식으로 표준화하고, 그 지식을 관련 과제로 옮길 수 있다는 것입니다.
문제는 이 약속들이 검증된 적이 없다는 점입니다. 스킬은 대체로 휴리스틱한 반복, 프롬프트 튜닝, 벤치마크별 시행착오로 쓰이고 고쳐집니다. 무엇이 스킬을 진짜 값어치 있게 만드는지에 대한 원리적 이해가 없는 상태입니다.
어떻게 만들었나
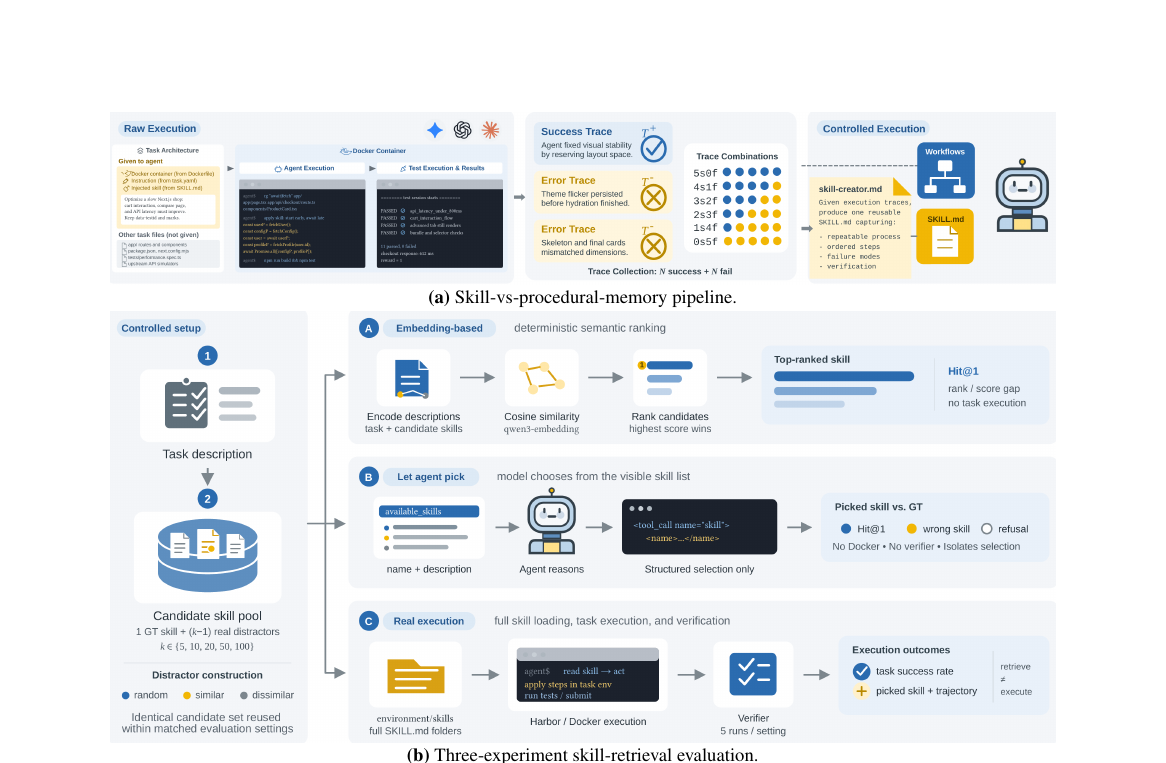
핵심 설계는 대조입니다. 같은 과제를 세 갈래로 실행하고 짝지어 비교합니다.
- Raw: 이전 경험을 전혀 주지 않은 기준선
- Workflow Memory: 이전 실행에서 정제한 절차 궤적을 그대로 주입
- Skill: 같은 워크플로를 표준화된
SKILL.md하나로 증류해 주입
여기서 중요한 것은 Workflow Memory와 Skill이 동일한 원본 궤적에서 만들어진다는 점입니다. 경험의 양을 고정하고 표현 형식만 바꿉니다. 그래서 차이가 나면 그 차이는 "더 많은 경험을 줬기 때문"이 아니라 "그 경험을 어떻게 포장했는가" 때문입니다.
원본 궤적 풀도 통제합니다. 성공 궤적 5개에서 실패 궤적 5개까지 여섯 단계로 구성비를 바꿉니다(5s0f, 4s1f, 3s2f, 2s3f, 1s4f, 0s5f). 이렇게 하면 밑재료의 품질이 나빠질 때 스킬과 워크플로 메모리 중 어느 쪽이 먼저 무너지는지가 보입니다.
평가는 Codex + GPT-5.3-Codex, Gemini CLI + Gemini-3.1-Pro-Preview 두 쌍으로 돌렸습니다. 벤치마크는 Terminal-Bench 2.0(89개 과제), Terminal-Bench Pro(400개 중 공개 200개), SkillsBench(11개 도메인 86개 과제)입니다. 과제당 \(n = 5\)회 시행에 병렬도 20으로, Harbor 표준 평가 워크플로를 따랐습니다. 스킬은 초기 컨텍스트에 통째로 인라인하지 않고 실행 환경에 재사용 가능한 리소스로 배치했습니다. 실제 에이전트 스킬 사용 방식과 맞추기 위해서입니다.
대조 궤적 분류 체계
여기가 이 논문의 방법론적 기여입니다. 총합 성공률만 보면 무엇이 바뀌었는지 알 수 없으므로, 궤적 자체를 라벨링합니다.
이질적인 벤치마크 출력을 8,135건의 시행 기록으로 정규화했습니다(이 중 7,837건에 에이전트 트랜스크립트가 있습니다). 240개 궤적에 개방 코딩을 수행해 238개의 유효 고유 라벨을 얻고, 이를 12개 모드의 정규 분류 체계로 병합했습니다. 12개 모드는 다시 세 개의 상위 범주(SC)로 묶입니다.
- SC1 절차적 앵커링 성공: 에이전트가 자율적으로 성공했거나 이전 경험이 유용한 안내를 제공한 경우
- SC2 실행 계층·검증 실패: 환경 셋업, 출력 형식, 서비스 관리, 셸 실행, 알고리즘 구현, 런타임 검증
- SC3 호출·적용 범위·경계 실패: 안내가 있는데도 오용, 과잉 적용, 무시되거나 외부 한계에 걸린 경우
LLM 판정만 믿지 않고 사람이 검증했습니다. 238개 원시 라벨 각각에 대해 세 개의 근거 궤적을 사람이 확인해 총 714건의 궤적-라벨 검사를 수행했고, 모든 라벨이 실제 에이전트 행동에 근거함을 확인했습니다. 그 다음 같은 사람이 정의만 보고 238개 라벨을 12개 정규 모드에 독립적으로 매핑했습니다. LLM 배정과의 정확 일치율은 95.8%, Cohen's \(\kappa = 0.952\)입니다.
분석 단위는 짝지은 삼중항입니다. 같은 과제와 설정을 세 갈래로 비교한 528개 삼중항을 만들었고(SkillsBench 144, Terminal-Bench 2.0 186, Terminal-Bench Pro 198), 갈래 단위 모드 배정은 1,584건이 됩니다.
결과
지식 주입이 아니라 절차적 앵커
먼저 총합입니다. 스킬 갈래의 oracle-status 성공률이 61.9%로 가장 높고, Raw가 59.1%, Workflow Memory가 55.9%입니다.
주목할 것은 스킬이 Raw를 이겼다는 사실이 아니라 Workflow Memory를 이겼다는 사실입니다. 두 조건은 같은 원본 궤적에서 만들어졌기 때문입니다. 짝지은 비교에서 스킬은 워크플로 메모리 대비 6.06%p 앞서고, 95% 부트스트랩 신뢰구간은 \([+0.76, +11.36]\)입니다.
그리고 메커니즘 라벨이 이 차이의 정체를 말해 줍니다.
메커니즘 |
스킬 갈래 비중 |
|---|---|
procedural_anchor (절차적 앵커) |
65.7% |
knowledge_injection (지식 주입) |
4.5% |
스킬은 없는 사실을 채워 주는 방식으로 작동하지 않습니다. 행동을 안정시키는 방식으로 작동합니다. 어떤 셋업 단계를 밟을지, 어떤 도구 순서를 따를지, 중간에 무엇을 확인할지, 어떤 함정이 반복되는지를 고정합니다.
이 결과는 스킬 문서를 백과사전처럼 두껍게 쓰는 관행이 잘못 겨눴을 가능성을 시사합니다. 값어치는 "무엇을 아는가"가 아니라 "어떤 순서로 하는가"에서 나옵니다.
압축이 그냥 짧아서 좋은 것이 아니라는 점도 확인했습니다. Terminal-Bench 2.0의 26개 과제에서 가벼운 대조군 둘을 붙여 봤습니다.
조건 |
출처 |
성공 |
성공률 |
|---|---|---|---|
Skill |
Workflow |
103 / 130 |
79.2% |
Workflow Memory |
Workflow |
81 / 130 |
62.3% |
Test-first 템플릿 |
Workflow |
77 / 130 |
59.2% |
Raw |
없음 |
65 / 130 |
50.0% |
Short plan |
과제 지시문 |
62 / 130 |
47.7% |
과제 지시문에서 뽑은 짧은 계획은 오히려 Raw보다 낮습니다. 워크플로에서 뽑은 test-first 검증 템플릿은 Raw보다는 낫지만 Workflow Memory에 미치지 못합니다. 짧고 절차적인 힌트를 아무거나 주는 것으로는 스킬의 효과가 재현되지 않습니다.
무엇이 고쳐지고 무엇이 안 고쳐지는가
SC2(실행 계층·검증 실패)는 Raw 갈래 라벨의 37.3%, 워크플로 갈래의 33.3%를 차지하는데 스킬 갈래에서는 23.5%로 떨어집니다. 모드별로 보면 어디가 고쳐졌는지가 선명합니다.
실패 모드 |
Raw |
Workflow |
Skill |
|---|---|---|---|
environment_infrastructure_failure |
5.3% |
1.7% |
0.2% |
output_format_schema_mismatch |
7.4% |
- |
3.2% |
background_service_lifecycle_failure |
2.7% |
- |
0.8% |
algorithmic_logic_error |
8.3% |
11.0% |
7.4% |
static_verification_without_runtime |
12.5% |
12.5% |
11.7% |
위쪽 세 줄과 아래쪽 두 줄이 갈립니다. 환경과 툴링 문제는 극도로 스킬화가 잘 됩니다. 믿을 만한 셋업 순서, 의존성 우회법, 경로 관례가 한 번 발견되면 그대로 재사용 가능한 절차로 인코딩됩니다. environment_infrastructure_failure가 5.3%에서 0.2%로 사실상 사라지는 것이 그 증거입니다.
반면 알고리즘 논리 오류와 런타임 검증 없는 정적 확인은 세 갈래에서 거의 그대로입니다. 스킬은 틀린 알고리즘을 고쳐 주지 않고, 정답에 맞춘 검증을 강제하지도 않습니다. 실행의 견고함은 올려 주지만 문제를 다시 정의해야 하는 종류의 실패에는 손을 못 댑니다.
스킬이 새로 만드는 실패
압축이 만든 이점이 그대로 새로운 실패면을 만듭니다. 스킬은 스스로 실행되지 않습니다. 에이전트가 이게 적용되는 상황인지, 어느 부분을 따를지, 어떻게 각색할지, 언제 버릴지를 판단해야 합니다.
모드 |
Raw |
Workflow |
Skill |
|---|---|---|---|
skill_guidance_misapplied_or_ignored |
0.8% |
0.4% |
10.0% |
timeout_budget_exhaustion |
1.7% |
10.6% |
4.4% |
두 실패가 대칭을 이룹니다. 스킬 갈래의 오적용은 10.0%로 다른 두 갈래보다 한 자릿수 이상 높습니다. 스킬이 없거나 무관해서가 아닙니다. 대개는 스킬에 그럴듯한 안내가 들어 있는데, 에이전트가 기계적으로 적용하거나 조건 하나를 놓치거나 더 이상 성립하지 않는 전제를 그대로 가져오는 경우입니다.
워크플로 메모리는 다르게 실패합니다. 타임아웃·예산 소진이 10.6%로, Raw의 1.7%나 스킬의 4.4%보다 훨씬 높습니다. 원시 궤적이 긴 탐색, 실패한 시도, 저수준 디버깅 경로 같은 절차적 잔여물로 에이전트를 짓누르는 것입니다. 증류가 이 부담은 줄여 주지만, 적용 판단의 필요를 없애 주지는 않습니다.
상위 범주로 정리하면 이렇습니다. 스킬 갈래는 SC1을 528건 중 326건으로 워크플로(294건)보다 늘리고, SC2를 124건으로 Raw(197건)와 워크플로(176건)보다 줄이는 대신, SC3를 78건으로 Raw(19건)보다 크게 늘립니다.
검색과 사용은 같은 축이 아니다
RQ4는 이 논문에서 가장 반직관적인 결과가 나오는 부분입니다.
SkillsBench의 과제-스킬 정답 주석을 이용해, 각 과제마다 정답 스킬과 방해 스킬들로 후보 풀을 만듭니다. 풀 크기 \(k\)는 5부터 100까지, 방해 스킬은 무작위·의미적으로 유사·비유사 세 종류입니다. 그리고 세 갈래를 독립적으로 측정합니다. Arm 1은 임베딩 검색(Qwen3-Embedding-0.6B로 과제 설명과 스킬 설명의 유사도 랭킹), Arm 2는 실행 없이 에이전트에게 명시적으로 고르게 하기, Arm 3은 풀 전체를 열어 준 채 실제 실행하고 접근한 스킬을 파싱하기입니다. 앞 갈래의 출력이 뒤 갈래로 넘어가지 않습니다.
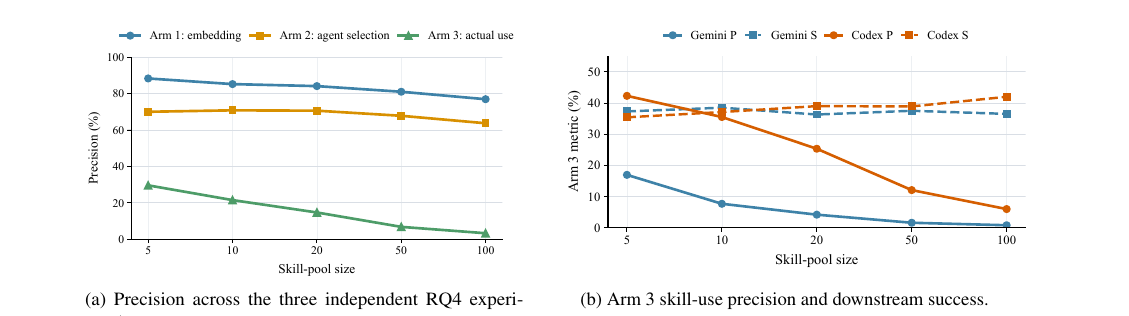
왼쪽 그림에서 오프라인 진단 둘은 완만하게 떨어집니다. 임베딩 top-1 정밀도는 풀 5에서 88.3%, 풀 100에서 76.9%입니다. 명시적 에이전트 선택은 70.0%에서 63.7%입니다. 그런데 실제 사용 정밀도(Arm 3)는 29.6%에서 3.3%로 무너집니다.
오른쪽 그림이 핵심입니다. 실선이 실제 사용 정밀도, 점선이 과제 성공률입니다.
지표 |
\(k = 5\) |
\(k = 100\) |
|---|---|---|
Gemini 실제 사용 정밀도 |
16.9% |
0.7% |
Gemini 과제 성공률 |
약 36% |
약 39% |
Codex 실제 사용 정밀도 |
42.3% |
5.9% |
Codex 과제 성공률 |
35.4% |
42.0% |
정밀도가 40%p 넘게 붕괴하는 동안 성공률은 오히려 올라갑니다. Codex는 35.4%에서 42.0%가 됩니다. 두 쌍 평균으로도 성공률은 36.4%에서 39.3%로 움직일 뿐입니다.
Arm 3의 재현율이 \(k = 100\)에서도 54.3~73.6%를 유지한다는 점이 이 현상을 설명합니다. 에이전트는 여러 후보를 들여다보고 호출합니다. 다만 사용을 정답 스킬로 한정하지 못할 뿐입니다. 저자들의 결론은 명확합니다. 정답 스킬을 정확히 호출하는 것은 성공의 충분조건도 필요조건도 아닙니다. 관련 있는 비정답 스킬도 부분적인 절차적 지지를 제공할 수 있기 때문입니다.
무엇이 검색을 어렵게 만드는지도 갈립니다. Arm 1에서 유사 방해 풀의 top-1 정밀도는 \(k=5\)의 70.5%에서 \(k=100\)의 53.4%로 떨어지는데, 무작위 풀은 97.7%에서 84.1%, 비유사 풀은 96.6%에서 93.2%입니다. 풀 크기보다 의미적 혼동 가능성이 더 센 스트레서입니다. 다만 Arm 3의 정밀도는 세 종류 풀 모두에서 똑같이 무너집니다.
성공·실패 라벨의 역할
RQ2는 짧지만 실무적으로 쓸모 있는 결과입니다. 같은 궤적 풀에서 스킬을 만들되, 어느 궤적이 성공이고 어느 것이 실패인지를 스킬 작성자에게 보여 준 경우와 숨긴 경우를 비교했습니다.
성공 궤적만 들어 있는 풀에서는 라벨을 숨겨도 별 차이가 없습니다. 그런데 실패 궤적이 섞이기 시작하면 격차가 급격히 벌어집니다. Gemini의 Terminal-Bench 2.0 3s2f 조건에서 정상 설정은 0.7462, 힌트 없는 설정은 0.4000입니다. 실패한 궤적을 재료로 쓸 때는 그것이 실패였다는 표시가 반드시 함께 가야 한다는 뜻입니다. 표시 없이 던지면 실패 패턴이 그대로 절차로 굳습니다.
비용
83개 과제 교집합에서 토큰 비용을 맞춰 비교했습니다.
표현 |
성공률 |
입력(K) |
출력(K) |
합계(K) |
Raw 대비 |
|---|---|---|---|---|---|
Raw 궤적 |
64.1% |
541.5 |
14.2 |
555.7 |
- |
Workflow Memory |
64.8% |
417.9 |
8.3 |
426.2 |
+0.7%p |
Skill |
69.6% |
511.7 |
9.8 |
521.5 |
+5.5%p |
효과와 효율이 갈립니다. Workflow Memory는 토큰을 가장 적게 쓰면서 성공률은 Raw와 거의 같습니다. Skill은 Raw보다 성공률이 5.5%p 높으면서 토큰도 3.42만 개 적게 쓰지만, Workflow Memory보다는 9.53만 개를 더 씁니다. 스킬은 추가 컨텍스트를 더 강한 실행 성능과 맞바꾸는 선택입니다.
회고
저자들이 직접 적은 한계가 세 가지입니다.
평가가 터미널·도구 사용 벤치마크에 집중돼 있습니다. 다단계 실행, 디버깅, 검증을 강조하는 설정이라 긴 호흡의 웹 상호작용이나 열린 협업 같은 에이전트 행동 전반을 다루지는 못합니다.
에이전트-모델 조합이 제한적입니다. 다른 스캐폴드, 다른 모델 계열, 다른 버전에서 결과가 일반화되지 않을 수 있습니다.
메커니즘 분류 체계가 정규화된 기록의 약 3%를 층화 표집해 개방 코딩한 결과라 전수 라벨링이 아닙니다. 드물게 나타나는 행동 모드는 과소 대표될 수 있습니다.
여기에 읽는 쪽에서 붙일 것이 하나 더 있습니다. RQ4의 Codex 쌍은 GPT-5.3-Codex를 더 이상 같은 조건으로 쓸 수 없어 GPT-5.4로 바꿔 진행했습니다. 저자들도 이 점을 명시하고 RQ4를 쌍 내부 비교로만 해석하라고 못 박습니다. 따라서 RQ4의 절대 수치를 RQ1~RQ3의 숫자와 나란히 놓고 읽으면 안 됩니다.
한 가지 긴장도 남습니다. "정답 스킬 호출이 성공의 필요조건도 충분조건도 아니다"라는 주장과 "검색 정밀도가 무너진다"는 관찰은 방향이 어긋나 보입니다. 저자들의 해석은 두 지표가 순차적 단계가 아니라 스킬 사용의 서로 다른 측면을 재는 독립 측정이라는 것입니다. 이 해석이 성립하려면 비정답 스킬이 제공하는 부분적 절차 지지가 실제로 얼마나 되는지가 따로 측정되어야 하는데, 그 부분은 궤적 사례로만 뒷받침됩니다. 스킬 풀을 키우는 것이 안전한지 여부는 이 지점에 달려 있어서, 후속 연구가 붙어야 할 자리로 보입니다.
정리
- 스킬이 작동하는 이유의 65.7%는 절차적 앵커링이고 지식 주입은 4.5%입니다. 스킬 문서는 백과사전이 아니라 체크리스트에 가깝게 써야 합니다.
- 스킬은 환경 셋업·출력 형식·서비스 관리 같은 실행 계층 실패를 크게 줄이지만(환경 실패 5.3% → 0.2%), 알고리즘 오류나 런타임 검증 부재는 거의 손대지 못합니다. 대신 안내를 잘못 적용하는 새 실패를 10.0% 만들어 냅니다.
- 스킬 풀이 5개에서 100개로 늘면 실제 사용 정밀도는 29.6%에서 3.3%로 무너지는데 과제 성공률은 36.4%에서 39.3%로 오히려 소폭 오릅니다. 검색 정확도와 과제 성공은 같은 축이 아닙니다.