VoiceMem - Streaming Dual-Brain Memory for Real-Time Interaction
Z. Xie, J. Lang, Z. An, Y. Zhao, D. Yang, K. Li, Z. Ma, M. Lin, C. Miao, and S. Yan, "VoiceMem: Streaming Dual-Brain Memory for Real-Time Interaction," arXiv:2608.26005, 2026.
음성 에이전트에 장기 기억을 붙이는 일은 오래된 숙제였습니다. 그런데 이 논문이 겨눈 곳은 기억의 정확도가 아니라 기억을 꺼내는 데 걸리는 시간입니다. 텍스트 에이전트에서 잘 돌아가는 기억 시스템이 음성 대화에 들어오면 무너지는 이유가 정확히 두 가지인데, 둘 다 성능 문제가 아니라 예산 문제입니다.
저자
1저자는 셰즈페이입니다. Mini-Omni 계열로 "듣는 동시에 말하는" 오디오 언어 모델을 연이어 내놓은 난양공과대학교 연구자입니다. 그의 이전 작업들은 모두 실시간 음성 상호작용의 지연을 어떻게 줄이느냐에 걸려 있었고, 이번 논문은 그 제약을 기억 시스템 쪽으로 그대로 옮겨 왔습니다. 기억을 붙이면 지연이 늘어난다는 사실이 그에게는 새 연구 주제가 아니라 자기 모델을 막고 있던 벽이었습니다.
공동 1저자 Jiaqi Lang을 비롯한 싱가포르국립대(NUS) 쪽 인력이 시스템 구현을 맡았고, 홍콩중문대학교의 양둥차오가 합류했습니다. 음성·음향·음악·노래를 하나의 LLM으로 통합 생성하는 UniAudio의 1저자로, 오디오를 텍스트로 옮기지 않고 그대로 다루는 쪽의 전문가입니다. 이 논문에서 카페에서 들린 노래를 기억한다는 종류의 기능이 가능해진 배경입니다.
마쯔양의 합류 동기가 특히 분명합니다. emotion2vec으로 음성에서 감정 표현을 자기지도로 뽑아내는 작업을 해 온 상하이교통대학교 X-LANCE 랩 연구자인데, 이 논문의 우뇌가 하는 일이 정확히 그것입니다. 텍스트로 옮긴 뒤 단어 선택에서 감정을 추측하는 대신 음성 신호에서 직접 정서를 읽습니다.
교신저자는 세 명입니다. 모델 압축과 프루닝으로 저지연 시스템을 다뤄 온 린밍바오, NTU 컴퓨팅·데이터과학대 학장이자 Human-Centered AI를 연구 철학으로 삼아 온 먀오춘옌, 그리고 옌수이청입니다. 압축 전문가와 인간 중심 AI 연구자가 같은 논문에 교신저자로 붙은 조합이 이 논문의 두 축을 그대로 보여줍니다. 하나는 예산 안에 밀어 넣는 일이고 다른 하나는 사람을 이해하는 일입니다.
배경
기존 기억 시스템은 텍스트 에이전트를 상정하고 만들어졌습니다. 논문은 그 전제가 음성 대화에서 깨지는 지점을 두 개로 정리합니다.
첫째는 지연입니다. 통상적인 기억 파이프라인은 검색과 처리에 2~3초를 씁니다. 실시간 대화가 자연스러운 턴 교대를 유지하려면 추가로 허용되는 지연이 100~200ms뿐입니다. 한 자릿수 배가 아니라 열 배 이상 차이가 납니다.
둘째는 컨텍스트 예산입니다. 텍스트 에이전트 기억에서 흔한 top-100 검색은 커버리지를 높이지만, 음성 언어 모델이 받을 수 있는 양을 넘어섭니다. 그렇다고 top-5로 줄이면 관련 기억을 놓칩니다.
여기서 논문의 핵심 관찰이 나옵니다. 검색 예산이 작을 때 성능을 결정하는 것은 랭킹 기법의 정교함이 아니라 후보 공간의 의미적 밀도입니다. 같은 엔티티를 가리키지만 무관한 맥락에 붙은 기억 항목 여럿이 상위 \(K\)개를 차지해 버리면, 랭커를 아무리 개선해도 소용이 없습니다. 그래서 랭킹을 잘하는 대신 후보 풀 자체를 좁고 조밀하게 만드는 쪽을 택합니다.
세 번째 문제는 조금 결이 다릅니다. 정보 지능과 정서 지능은 유지 방식이 다릅니다. 하나는 대규모로 축적하고, 다른 하나는 축적한 뒤 귀인해야 합니다. 기존 감정 인식 검색 연구들은 정서를 검색 점수의 가중치로 섞는 데 그쳤습니다. 식으로 쓰면 이렇습니다.
\[R^{\text{aff}}_t = \text{TopK}_{m_i \in \mathcal{M}_t} \left[ \lambda \, \text{sim}\!\left(f_\theta(q_t), f_\theta(m_i)\right) + (1-\lambda)\,\kappa(a_t, a_i) \right]\]
정서가 어디까지나 정보 검색을 재가중하는 항으로만 들어갑니다. 사실 관계와 사람을 향한 귀인이 각각 독립적으로 진화하는 상태로 유지되지는 않습니다.
어떻게 만들었나
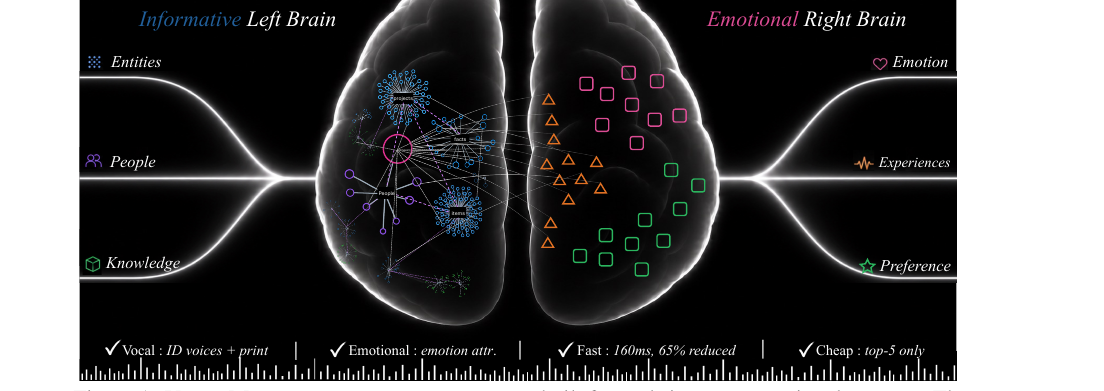
VoiceMem은 기억을 두 그래프로 나눕니다. 사실을 담는 좌뇌 \(G^L_t\), 정서 귀인을 담는 우뇌 \(G^R_t\), 그리고 둘을 잇는 교차 연결 \(E^{LR}_t\)입니다.
\[\mathcal{B}_t = \left( G^L_t,\ G^R_t,\ E^{LR}_t \right)\]
발화 \(u_t\)가 들어올 때마다 두 뇌가 각각 새 셀을 활성화하고 증분 갱신합니다. 응답은 둘을 함께 조회해서 만듭니다.
좌뇌
좌뇌는 클러스터-엔티티-기억항목 3단 색인입니다. 백엔드에 저장된 실제 기억 항목과 그 위에 얹은 가벼운 의미 색인을 분리한 것이 요점입니다. 색인은 스키마와 엔티티 두 층으로 구성됩니다.
\[G^L = (S, V, E), \qquad v = (d_v, N^{\text{micro}}_v, I_v), \qquad s = (d_s, N^{\text{macro}}_s, V_s)\]
엔티티 \(v\)는 정확히 하나의 스키마 \(s\)에 속합니다. 스키마-엔티티 간선을 따로 두지 않고 소속을 직접 인코딩했는데, 재귀적 순회를 피해 검색을 짧게 끝내기 위한 선택입니다.
검색은 사용자가 말하는 도중에 부분 전사에서 스키마와 엔티티를 매칭한 뒤, 강한 연결과 약한 연결로 1홉 확장합니다.
\[Z_t = V_t \cup V_{S_t} \cup N^{\text{strong}}_1(V_t \cup V_{S_t}) \cup N^{\text{weak}}_1(V_t \cup V_{S_t})\]
백엔드는 전체 기억 \(\mathcal{M}\)이 아니라 \(Z_t\)에 걸린 항목들만 뒤집니다.
여기에 클러스터 창발 메커니즘이 붙습니다. 클러스터가 커지면 정보 밀도가 떨어지는데, 규칙 기반으로 쪼개면 관련 기억이 흩어집니다. 그래서 실제 검색 패턴에서 하위 클러스터가 저절로 떠오르게 합니다. 세션 안에서 관찰된 질의 집합 \(Q\), 질의 \(q\)가 활성화한 엔티티 \(A_q\), 현재 클러스터의 연결된 부분집합 \(H\)에 대해 질의 일관성을 이렇게 잽니다.
\[\rho(H) = \frac{1}{|Q|} \sum_{q \in Q} \frac{|A_q \cap H|}{|A_q \cup H|}\]
값이 높다는 것은 \(H\) 안의 엔티티들이 반복해서 함께 검색된다는 뜻입니다. 임계값 \(\alpha\)를 넘는 가장 큰 부분그래프가 있으면 LLM 판정자가 관련성·중요도·완결성을 한 번 더 검사한 뒤 새 클러스터로 승격합니다.
우뇌
우뇌는 페르소나 노드를 두 종류로 나눕니다. 독립 노드 \(v^I\)는 사용자 고유의 지속적 성향과 행동 규칙성을 담고, 교차 엔티티 노드 \(v^C_e\)는 좌뇌의 특정 엔티티 \(e\)에 묶인 맥락 의존적 정서를 담습니다.
\[G^R = \left( V^I, V^C \right), \qquad v^I = (d^I_v, I^I_v), \qquad v^C_e = (d^C_{v,e}, I^C_{v,e}, \rho_{v,e})\]
이 구분이 논문에서 가장 설득력 있는 설계 논거입니다. 둘을 합치면 상황적 반응을 안정적 기질로 착각하거나, 반대로 정서에 의미를 부여하는 현실의 원인을 지워 버립니다. "회의를 싫어한다"와 "회의에서 밥과 부딪힌 뒤로 그 회의를 싫어한다"는 다른 정보이고, 후자를 잃으면 대화가 엉뚱해집니다.
귀인은 두 시계열로 이뤄집니다. 단기 귀인은 입력 \(x_t\)마다 정서 추정기가 \(e_t = \phi(x_t)\)를 뽑고 그 쌍으로 페르소나 노드를 추가·수정·병합합니다. 장기 귀인은 세션이 끝난 뒤 전체 시퀀스를 함께 분석해 반복되는 증거만 안정적인 독립 노드로 통합합니다.
\[V^I \leftarrow \text{Consolidate}\left(V^I;\ (x_1, e_1), (x_2, e_2), \ldots, (x_T, e_T)\right)\]
지나가는 상태를 전부 쌓지 않고 지속되는 패턴만 남긴다는 점이 핵심입니다.
침묵 안에 검색을 숨기기
이 논문에서 가장 실용적인 부분입니다. 검색을 빠르게 만든 것이 아니라, 검색이 일어날 자리를 옮겼습니다.
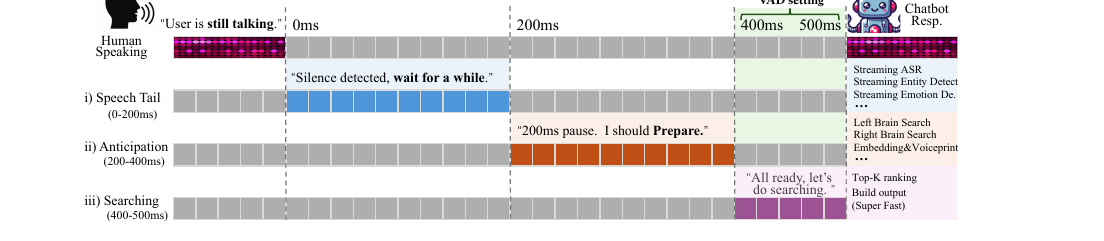
VAD 임계값은 보통 500ms로 잡힙니다. 사람이 말을 멈추고 500ms가 지나야 시스템이 발화 종료로 판정합니다. 그 500ms는 지금까지 그냥 기다리는 시간이었습니다. VoiceMem은 그 창을 네 단계로 쪼개 씁니다.
사용자가 말하는 동안과 발화 꼬리 구간(0~200ms)에는 스트리밍 ASR로 부분 전사 \(x_{\leq t}\)를 얻고, 양쪽 뇌의 스키마·엔티티 매칭과 화자 식별을 실시간으로 돌립니다. 예측 구간(200~400ms)에서는 침묵이 200ms에 도달한 시점에 응답이 올 것이라 가정하고, 질의 임베딩을 뽑아 두 그래프의 상위 층을 미리 확장해 둡니다. 검색 구간(400~500ms)에는 백엔드 검색만 남아 있어서 양쪽 뇌를 뒤져 병합하면 끝납니다.
밀집 이중 뇌 검색 자체가 134ms이므로 400ms 창 안에 여유를 두고 들어갑니다. 지연을 줄인 것이 아니라 이미 있던 대기 시간에 계산을 밀어 넣은 셈입니다.
무엇으로 구성돼 있나
논문은 아키텍처 위에 학습·평가·배포 파이프라인을 얹었습니다.
모델 학습은 블랙박스 온폴리시 증류입니다. Qwen2.5-Omni, Qwen3-Omni, Step-Audio2-Mini처럼 음성 입력에 텍스트 출력을 하도록 설계된 모델들을 기억 접근이 가능한 음성 언어 모델로 바꿉니다. 파괴적 망각을 피하려고 작은 규모로 학습하고, 폐쇄형 모델을 교사로 삼아 온라인 교정과 사후 검증을 도는 방식입니다. 네 단계로 나뉩니다. 합성 사용자마다 페르소나에서 시작해 배경, 사건, 메시지, 기억으로 내려가며 일관된 장기 기억 세계를 만들고, 그 위에서 기억 의존 대화를 반복 생성하며, 사람이 다시 다듬고, 마지막에 검증합니다. 이 루프에서 나온 데이터가 학습용 ChatMem-400K와 평가용 ChatMem-Bench입니다.
배포는 상위 라우팅과 하위 엔진을 분리한 2층 구조입니다. 기억 알고리즘이 빠르게 바뀌고 있으므로 특정 백엔드에 묶이면 새 방법을 못 받는다는 판단입니다. VoiceMem의 알고리즘은 상위 층에서 관리·라우팅·스트리밍만 하고, 하위 층은 완전히 독립적입니다. 현재 구현은 Mem0을 하위 층으로 씁니다.
평가 벤치마크는 세 계열입니다. 정보 기억은 LoCoMo, LongMemEval, Memora. 페르소나 기억은 ES-MemEval, PersonaMem, PersonaLens. 음성 기반 기억은 자체 제작한 ChatMem-Bench로, 53시간 분량 오디오의 15,314턴에서 뽑은 316개 질문을 정보·페르소나·정서 귀인·준언어 및 환경 네 축 14개 세부 범주로 나눴습니다.
비교 대상은 열 개 시스템입니다. 전체 컨텍스트를 참조선으로 두고, 기억 엔진(Mem0, Zep, LangMem), 에이전트 기억(A-MEM, MemoryOS, MemOS), 개인 기억(MemoryBank, EverMemOS, Emotional RAG)으로 묶었습니다. 모든 베이스라인은 GPT-4o-mini를 백본으로, text-embedding-3-small을 임베딩 모델로 씁니다.
결과
세 벤치마크 계열의 평균 점수를 한 표로 모으면 이렇습니다.
시스템 |
정보 (%) |
페르소나 (%) |
음성 (%) |
|---|---|---|---|
Full-Context (참조) |
60.49 |
46.24 |
45.96 |
Mem0 |
52.27 |
65.56 |
48.64 |
Zep |
48.78 |
51.94 |
39.17 |
LangMem |
48.15 |
41.68 |
48.49 |
A-MEM |
48.58 |
66.01 |
42.89 |
MemoryOS |
40.59 |
47.82 |
47.37 |
MemOS |
65.83 |
72.27 |
53.95 |
MemoryBank |
22.39 |
48.80 |
34.67 |
EverMemOS |
65.75 |
54.67 |
48.45 |
Emotional RAG |
38.99 |
64.35 |
43.36 |
VoiceMem |
76.39 |
74.16 |
68.73 |
VoiceMem‡ |
75.65 |
76.56 |
66.96 |
정보는 LoCoMo·LongMemEval·Memora 평균, 페르소나는 ES-MemEval·PersonaMem·PersonaLens 평균, 음성은 ChatMem-Bench 평균입니다. ‡는 응답 모델로 자체 파인튜닝한 Qwen3.6을 쓴 경우이고 나머지 행은 모두 GPT-4o-mini입니다.
눈에 띄는 것은 자기 백엔드와의 격차입니다. VoiceMem은 하위 층으로 쓰는 Mem0을 정보에서 24.12점 앞섭니다. 같은 저장소를 쓰는데 위에 얹은 색인만으로 이만큼 벌어집니다. 전체 히스토리를 다 보는 Full-Context보다도 15.90점 높습니다.
정보 쪽 세부를 보면 격차가 벌어지는 자리가 분명합니다. 여러 기억이 함께 도착해야 답이 되는 시간 추론에서 가장 크게 앞서고(+54.9), 최신 기억 하나로 답이 되는 갱신 추적에서 가장 작습니다(+7.4). 밀도를 올린 효과가 어디에서 나오는지 그대로 드러납니다.
페르소나에서는 참조선이 뒤집힙니다. ES-MemEval의 충돌 탐지에서 Full-Context가 12.10, 사용자 모델링에서 21.70인데 VoiceMem은 각각 69.10과 74.00입니다. 증거가 입력 안에 다 있는데도 귀인을 못 한다는 뜻입니다.
음성 쪽은 준언어·환경 범주에서 차이가 가장 큽니다. 전사만으로는 증거가 아예 없는 영역이라, 모든 텍스트 시스템이 세 개 음향 범주에서 3.23에서 26.92 사이에 머무는 동안 VoiceMem은 45.16에서 53.84를 냅니다. 반대로 정서 귀인은 텍스트 베이스라인도 버팁니다. 단어 선택이 이미 정서 신호를 상당 부분 담고 있기 때문입니다.
예산과 지연
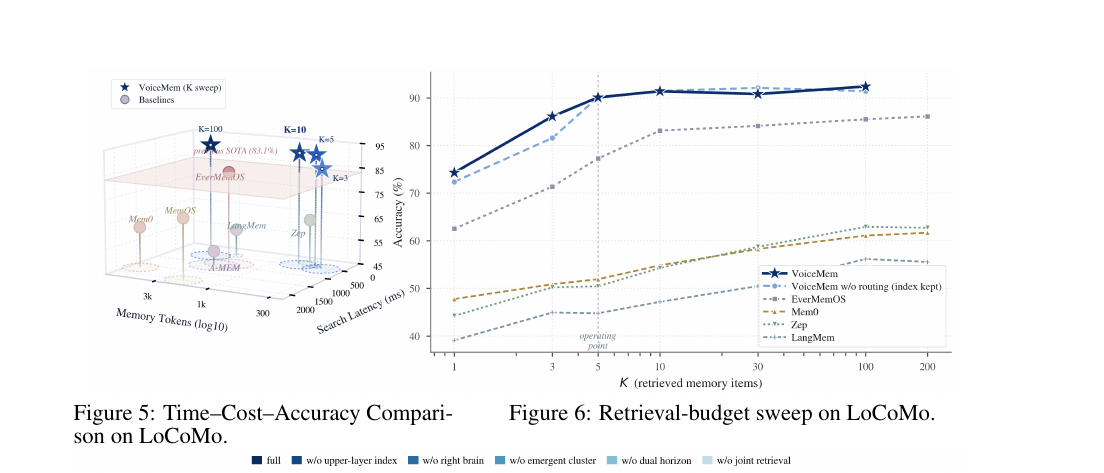
\(K=5\)에서 VoiceMem은 LoCoMo 91.2점을 기억 토큰 430개와 검색 134ms로 냅니다. 가장 강한 베이스라인 EverMemOS는 83.13점에 1,899토큰을 씁니다. 8.1점을 더 내면서 토큰은 \(4.4\times\) 적게 씁니다. 베이스라인 전체가 541에서 6,956토큰 사이에 있으니 특정 비교에만 해당하는 절약이 아닙니다.
지연이 \(K\)에 대해 평평하다는 점이 구조를 설명합니다. \(K=3\)부터 \(K=100\)까지 검색이 134ms 근처에 머뭅니다. 스키마 라우팅이 랭킹 전에 후보 풀을 이미 묶어 놓기 때문에, 최종적으로 몇 개를 돌려주느냐가 얼마나 뒤지느냐를 바꾸지 않습니다.
\(K\)를 훑어 보면 작은 예산에서 격차가 가장 큽니다. \(K=1\)에서 EverMemOS 대비 +11.8, Mem0 대비 +26.5입니다. \(K=5\)를 넘으면 곡선이 평평해져서 \(K=10\)이 1.3점, \(K=100\)이 8배 토큰을 쓰고 2.3점을 더합니다. 반대로 베이스라인에는 그런 선택지가 없습니다. EverMemOS는 83.13에 닿으려면 top-10이 필요한데, VoiceMem은 \(K=3\)에 362토큰으로 이미 그 위입니다. Mem0과 Zep은 어떤 예산에서도 63을 넘지 못합니다.
무엇이 기여하는가
메커니즘을 하나씩 껐을 때의 손실입니다. 네 데이터셋 전부에서 다섯 개 절제 모두 정확도가 떨어집니다.
제거한 메커니즘 |
LoCoMo |
ES-MemEval |
ChatMem-Bench |
Memora |
|---|---|---|---|---|
상위 층 색인 |
−9.9 |
−5.3 |
−6.7 |
−4.4 |
우뇌 |
−6.3 |
−4.3 |
−5.4 |
−4.4 |
창발 클러스터링 |
−5.5 |
−2.0 |
−3.4 |
−0.2 |
이중 시계열 갱신 |
−5.4 |
−2.0 |
−3.2 |
−1.4 |
통합 검색 |
−2.6 |
−3.1 |
−2.7 |
−0.4 |
상위 층 색인이 어디서나 가장 큽니다. 우뇌가 그다음인데, 정서와 페르소나가 사실 저장소에 없는 정보를 실제로 나른다는 뜻입니다. 창발 클러스터링과 이중 시계열 갱신은 세션이 가장 긴 LoCoMo에서 크고 Memora에서 거의 사라집니다. 통합 검색이 가장 작은데, 저자들은 이를 두고 두 목록을 따로 랭킹해 합집합을 쓰는 방식도 쓸 만한 대안이라고 인정합니다.
창발 클러스터링이 무엇을 만드는지도 확인했습니다. 좌뇌 저장소 510개 항목 중 사전에 없던 두 슬롯이 그래프에서 떠올라 254개, 49.8%를 차지합니다. 두 슬롯 모두 기존 여섯 개 프리셋 슬롯 하나에 들어가지 않습니다. Pets & Outdoor는 218개 항목이 daily_life에서 48%, health에서 27%, relationships에서 17%를 끌어옵니다. 창발이 프리셋 안을 세분화하는 것이 아니라 프리셋 경계를 가로질러 저장소를 다시 분할한다는 이야기이고, 세션이 길어 프리셋이 실제 주제 구조에서 멀어지는 LoCoMo에서 이 메커니즘의 기여가 가장 큰 이유이기도 합니다.
부록에 클러스터 유지 전략 비교가 있습니다. ES-MemEval P1의 32개 세션, 252개 질문을 \(K=5\)로 잰 결과입니다.
전략 |
정확도 (%) |
static 대비 |
|---|---|---|
static (분할 없음) |
72.60 |
- |
size threshold |
71.61 |
−0.99 |
random split |
72.40 |
−0.20 |
emergence (제안) |
74.40 |
+1.80 |
논거를 지탱하는 비교는 창발과 random split입니다. random split은 창발과 같은 횟수만큼 분할하도록 강제됐고, 그럼에도 2.00점 뒤집니다. 이득이 분할 자체가 아니라 올바른 자리에서 분할하는 데서 온다는 뜻입니다. 엉뚱한 자리에서 쪼개면 안 쪼개는 것보다 나쁩니다. size threshold가 static보다 0.99점 아래입니다.
백엔드 전이
색인이 특정 저장소에 종속되는지 확인한 실험입니다. 임계값 재조정 없이 세 백엔드 모두 개선됩니다.
백엔드 |
단독 (%) |
색인 적용 (%) |
차이 |
|---|---|---|---|
Mem0 |
61.68 |
91.20 |
+29.52 |
LangMem |
56.18 |
71.94 |
+15.76 |
Zep |
62.93 |
85.85 |
+22.92 |
평균 |
60.26 |
83.00 |
+22.73 |
다만 저자들이 같은 표에서 한계도 짚습니다. LangMem과 Mem0은 단독 점수가 5.50점 안에 있는데 색인을 얹은 뒤에는 19.26점 벌어집니다. 백엔드 품질이 회복 가능한 폭을 여전히 제한한다는 뜻입니다.
회고
이 논문에는 별도의 한계 절이 없습니다. 대신 본문 곳곳에 저자들이 스스로 물러선 자리가 있어서 그쪽을 모으는 편이 정확합니다.
가장 솔직한 대목은 1홉 이웃 처리 방식을 고른 이유입니다. 이웃 스키마를 한 문장 설명으로 압축할지, 기억 항목으로 펼쳐 상위 \(K\) 자리를 놓고 경쟁시킬지 비교했는데, LoCoMo에서는 91.2와 91.10으로 사실상 구분되지 않습니다. ES-MemEval에서 압축이 2.76점 앞서지만 LoCoMo에서는 프롬프트 토큰을 71.2개 더 씁니다. 저자들은 "더 정확해서가 아니라 후보 풀을 묶어 주기 때문에 압축을 택한다"고 적었습니다. 성능이 아니라 예산 통제가 선택 기준이었다고 명시한 셈입니다.
통합 검색 절제가 −2.6에서 −0.4로 가장 작다는 것도 그대로 인정합니다. 이중 뇌의 핵심 주장이 두 상태를 따로 유지하는 데 있으므로 이 결과 자체가 설계를 흔들지는 않지만, 조회 단계에서 둘을 함께 처리하는 부분은 단순 합집합으로 대체해도 크게 손해가 아니라는 이야기입니다.
숫자 쪽에서는 세 지점을 짚어야 합니다.
첫째, 검색 지연 수치가 두 개입니다. 초록과 3.3절, 5.4절, 결론은 모두 134ms를 말하는데 Figure 1 티저 이미지에는 "Fast: 160ms, 65% reduced"라고 적혀 있습니다. 본문에서 반복적으로 쓰이는 134ms가 정본으로 보이고, 티저 쪽이 갱신되지 않은 것으로 읽힙니다.
둘째, 초록의 "top-5 검색에서 좌뇌가 Mem0의 top-200보다 30점 가까이 앞선다"는 표현이 어느 실험을 가리키는지 모호합니다. Table 1 평균 기준 Mem0 대비 차이는 24.12점이고, 30점에 가까운 값은 백엔드 전이 실험의 LoCoMo 개선폭 +29.52입니다. 두 숫자는 다른 실험이므로 초록만 읽고 인용하면 어긋납니다.
셋째, 서론의 개선폭은 상대 백분율이고 표는 절대 점수입니다. 서론이 말하는 정보 기억 "+46.1% / +16.0%"는 각각 Mem0의 52.27에서 76.39로, MemOS의 65.83에서 76.39로 올라간 비율입니다. 페르소나 "+16.8% / +5.9%"는 파인튜닝 응답 모델을 쓴 VoiceMem‡의 76.56 기준인 반면, 5.2절이 말하는 "+1.89점"은 GPT-4o-mini를 쓴 74.16 기준입니다. 같은 페르소나 결과에 대해 서론과 본문이 서로 다른 행을 인용하고 있습니다.
마지막으로 평가 인프라에 대한 유보가 있습니다. ChatMem-Bench는 이 논문이 제안하고 이 논문이 자기 시스템을 재는 데 쓴 벤치마크인데, 저자들은 구축과 주석 파이프라인의 상세한 소개를 별도 후속 기술 보고서로 미뤘습니다. 표에서 가장 큰 격차가 나는 것이 바로 이 벤치마크이므로, 그 부분의 검증은 후속 문서를 봐야 가능합니다.
정리
기억 검색을 빠르게 만드는 대신 이미 존재하던 침묵 구간으로 옮겼습니다. VAD가 발화 종료를 판정하며 기다리는 500ms를 네 단계로 쪼개, 사용자가 말하는 동안 매칭하고 침묵 200ms 시점에 그래프를 확장해 둔 뒤 마지막 100ms에 백엔드만 뒤집니다. 지연 예산이 구조를 강제한 사례입니다.
작은 검색 예산에서는 랭커가 아니라 후보 풀의 밀도가 성능을 결정합니다. 백엔드 위에 얹은 스키마-엔티티 색인만으로 같은 저장소가 LoCoMo에서 61.68에서 91.20으로 올라가고, 같은 색인이 다른 두 백엔드에서도 15.76점과 22.92점을 더합니다. 라우팅은 천장을 올리는 것이 아니라 천장에 닿는 데 필요한 예산을 낮춥니다.
사실 기억과 정서 기억을 분리한 이유가 성능 이전에 의미에 있습니다. 사람의 지속적 성향과 특정 대상을 향한 감정을 한 노드로 합치면, 지나가는 반응을 기질로 착각하거나 감정에 의미를 주는 원인을 지웁니다. 우뇌를 제거했을 때 네 데이터셋 모두에서 4.3에서 6.3점이 빠진다는 것은, 그 구분이 사실 저장소가 담지 못하는 정보를 실제로 나르고 있다는 근거입니다.