BERT - Pre-training of Deep Bidirectional Transformers for Language Understanding
J. Devlin, M.-W. Chang, K. Lee, and K. Toutanova, "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding," arXiv:1810.04805, 2018.
저자
저자는 제이콥 데블린, 밍웨이 창, 켄턴 리, 크리스티나 투타노바 네 명이고, 모두 Google AI Language 소속이었습니다.
이 조합은 BERT가 무엇과 경쟁했는지를 잘 보여 줍니다. 켄턴 리는 이 논문이 가장 직접적으로 비교하는 ELMo 논문의 공저자입니다. 양방향 LSTM 언어 모델에서 문맥 표현을 뽑는 방식을 직접 만든 사람이 그 방식의 한계를 넘는 논문에 참여한 셈입니다. 데블린, 창, 투타노바는 모두 마이크로소프트 리서치 출신으로, 기계 번역과 질의응답, 구조 예측을 오래 다뤄 온 연구자들입니다. 특히 데블린은 신경망 기반 번역 모델 연구로 ACL 2014 최우수 논문상을 받은 바 있습니다.
1저자 데블린은 2023년 초 OpenAI로 잠시 옮겼다가 몇 달 만에 Google로 돌아왔습니다. 논문은 NAACL 2019 최우수 장편 논문상을 받았습니다.
배경
2018년은 NLP에서 "언어 모델 사전학습"이 막 효과를 보이기 시작한 해입니다. 사전학습된 표현을 실제 과제에 쓰는 방식은 두 갈래였습니다.
- 특징 기반(feature-based): ELMo처럼 사전학습한 표현을 고정된 특징으로 뽑아, 과제마다 따로 설계한 모델에 추가 입력으로 넣습니다.
- 파인튜닝(fine-tuning): OpenAI GPT처럼 과제별 파라미터를 최소한으로 붙이고, 사전학습한 파라미터 전체를 과제 데이터로 다시 학습시킵니다.
두 방식 모두 사전학습 단계에서는 단방향 언어 모델을 썼습니다. GPT는 왼쪽에서 오른쪽으로만 보는 Transformer라서 각 토큰이 앞쪽 토큰만 참조합니다. ELMo는 왼→오, 오→왼 LSTM을 따로 학습해 이어 붙였지만, 두 방향이 같은 층 안에서 섞이지는 않습니다. 저자들은 이 단방향성이 특히 질의응답처럼 양쪽 문맥이 모두 중요한 토큰 단위 과제에 해롭다고 주장합니다.
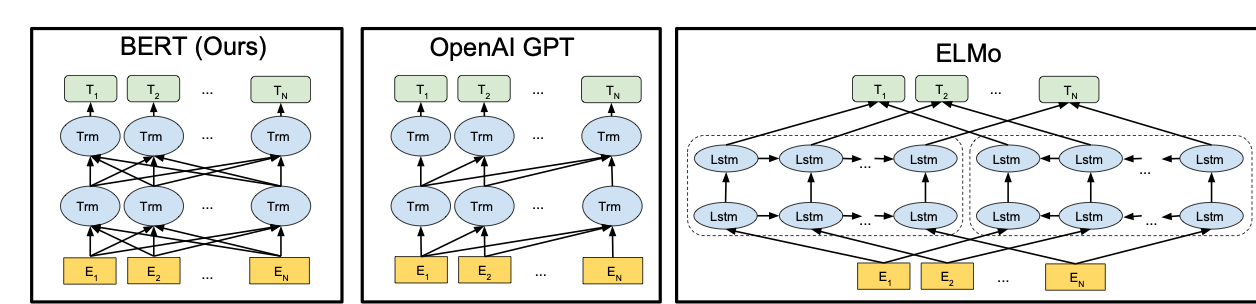
세 모델의 구조 차이입니다. BERT는 모든 층에서 양쪽 문맥을 함께 봅니다. GPT는 왼쪽만 보고, ELMo는 두 방향을 따로 계산한 뒤 마지막에 붙입니다.
그런데 왜 아무도 양방향 언어 모델을 학습시키지 않았을까요. 표준 언어 모델은 앞 단어로 다음 단어를 예측합니다. 여러 층에 걸쳐 양쪽 문맥을 모두 허용하면, 각 단어가 간접적으로 "자기 자신을 보게" 되어 예측이 무의미해집니다. BERT의 핵심 기여는 이 문제를 피하는 사전학습 목표를 찾은 데 있습니다.
어떻게 만들었나
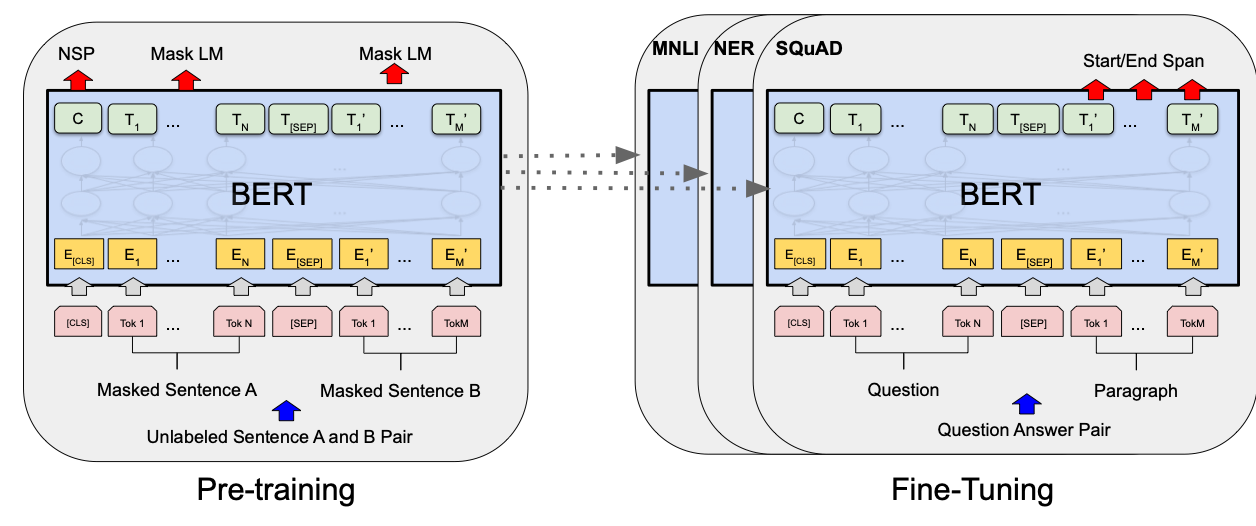
전체 흐름은 사전학습과 파인튜닝 두 단계입니다. 출력층을 빼면 두 단계의 구조가 같고, 과제마다 같은 사전학습 파라미터에서 출발해 전체를 파인튜닝합니다.
모델
구조는 원래 Transformer의 인코더를 거의 그대로 가져왔습니다. 층 수를 \(L\), 은닉 크기를 \(H\), 셀프 어텐션 헤드 수를 \(A\)라고 하고, 피드포워드 크기는 항상 \(4H\)입니다.
| 모델 | \(L\) | \(H\) | \(A\) | 파라미터 |
|---|---|---|---|---|
| BERT-Base | 12 | 768 | 12 | 110M |
| BERT-Large | 24 | 1024 | 16 | 340M |
BERT-Base는 OpenAI GPT와 크기를 일부러 맞췄습니다. 둘의 차이는 사실상 어텐션 마스킹 하나입니다. GPT는 왼쪽만 보도록 마스킹하고 BERT는 마스킹하지 않습니다. 각주에서 저자들은 양방향 버전을 "Transformer 인코더", 왼쪽 전용 버전을 "Transformer 디코더"라고 부르는 관례를 소개하는데, 이 명칭이 이후 굳어졌습니다.
입력 표현
하나의 토큰 시퀀스에 문장 하나 또는 문장 쌍(예: 질문과 지문)을 담습니다. 여기서 "문장"은 언어학적 문장이 아니라 연속된 텍스트 구간입니다.
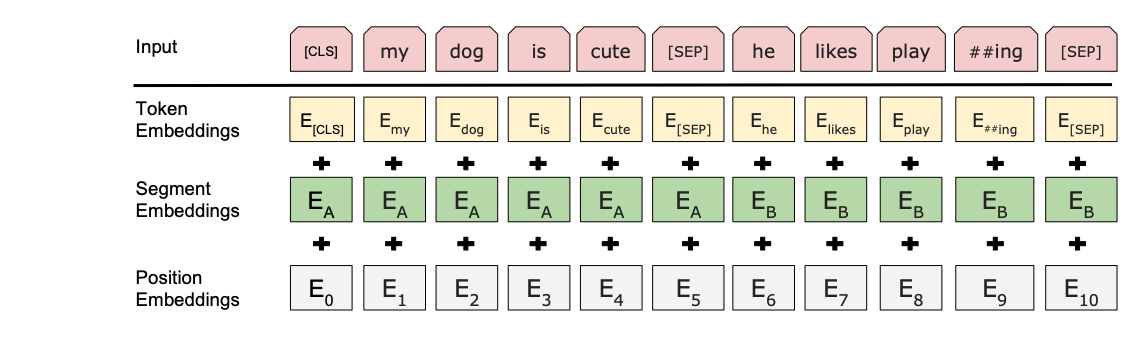
어휘 30,000개의 WordPiece로 토큰화합니다. 모든 시퀀스의 첫 토큰은 분류용 특수 토큰 [CLS]이고, 이 위치의 마지막 은닉 벡터 \(C \in \mathbb{R}^H\)를 시퀀스 전체 표현으로 씁니다. 두 문장은 [SEP]으로 구분하고, 각 토큰이 문장 A와 B 중 어디에 속하는지 알려 주는 세그먼트 임베딩을 더합니다. 최종 입력은 토큰 임베딩, 세그먼트 임베딩, 위치 임베딩의 합입니다.
사전학습 과제 1: Masked LM
양방향으로 학습하기 위해 입력 토큰의 일부를 무작위로 가리고 그 토큰을 맞히게 합니다. 1953년 Taylor가 글의 가독성을 재려고 제안한 빈칸 채우기(Cloze) 절차에서 착안했습니다. 가려진 위치의 마지막 은닉 벡터를 어휘 전체에 대한 softmax에 넣어 원래 토큰을 예측합니다. 가려진 위치 집합을 \(\mathcal{M}\), 가린 입력을 \(\tilde{\mathbf{x}}\)라고 하면 목표는 다음과 같습니다.
\[\mathcal{L}_{\text{MLM}} = -\frac{1}{|\mathcal{M}|} \sum_{i \in \mathcal{M}} \log p\left(x_i \mid \tilde{\mathbf{x}}\right)\]
디노이징 오토인코더와 달리 입력 전체를 복원하지 않고 가린 토큰만 예측합니다. 각 시퀀스에서 WordPiece 토큰의 15%를 고릅니다.
문제는 [MASK] 토큰이 파인튜닝 때는 나타나지 않는다는 점입니다. 사전학습과 파인튜닝의 불일치를 줄이려고, 고른 토큰을 항상 [MASK]로 바꾸지 않고 다음 비율로 처리합니다.
| 처리 | 확률 | 예시 ("my dog is hairy"에서 hairy를 고른 경우) |
|---|---|---|
[MASK]로 교체 |
80% | my dog is [MASK] |
| 무작위 토큰으로 교체 | 10% | my dog is apple |
| 그대로 둠 | 10% | my dog is hairy |
모델은 어떤 토큰을 예측해야 하는지, 어떤 토큰이 바뀌었는지 모르므로 모든 입력 토큰의 문맥 표현을 유지해야 합니다. 무작위 교체는 전체 토큰의 \(15\% \times 10\% = 1.5\%\)에만 일어나므로 언어 이해를 크게 해치지 않는다는 것이 저자들의 설명입니다.
사전학습 과제 2: 다음 문장 예측(NSP)
질의응답이나 자연어 추론은 두 문장의 관계를 이해해야 하는데, 언어 모델링만으로는 이 관계가 직접 학습되지 않습니다. 그래서 문장 A 다음에 오는 문장 B를 50%는 실제 다음 문장(IsNext), 50%는 말뭉치의 무작위 문장(NotNext)으로 넣고 \(C\)로 둘을 구분하게 했습니다. 최종 모델의 NSP 정확도는 97~98%였습니다.
전체 손실은 두 과제 손실의 합입니다.
\[\mathcal{L} = \mathcal{L}_{\text{MLM}} + \mathcal{L}_{\text{NSP}}\]
데이터와 학습
사전학습 말뭉치는 BooksCorpus(8억 단어)와 영어 위키백과(25억 단어)입니다. 위키백과에서는 목록, 표, 제목을 빼고 본문만 썼습니다. 저자들은 긴 연속 시퀀스를 뽑기 위해 문장을 섞은 말뭉치(Billion Word Benchmark 등)가 아니라 문서 단위 말뭉치를 쓰는 것이 결정적이라고 강조합니다.
| 항목 | 설정 |
|---|---|
| 배치 | 256 시퀀스 × 512 토큰 = 128,000 토큰 |
| 스텝 | 100만 (33억 단어 말뭉치 약 40 에폭) |
| 옵티마이저 | Adam, 학습률 \(10^{-4}\), \(\beta_1 = 0.9\), \(\beta_2 = 0.999\), L2 weight decay 0.01 |
| 학습률 스케줄 | 처음 10,000 스텝 warmup 후 선형 감소 |
| 정규화·활성화 | 모든 층 dropout 0.1, ReLU 대신 GELU |
| 시퀀스 길이 | 스텝의 90%는 길이 128, 나머지 10%는 512 |
| 하드웨어 | Base: Cloud TPU 4개(칩 16개), Large: Cloud TPU 16개(칩 64개), 각 4일 |
어텐션 비용이 시퀀스 길이 \(n\)에 대해 \(O(n^2)\)이므로, 대부분을 짧은 시퀀스로 학습하고 마지막 10%만 길이 512로 돌려 위치 임베딩을 학습시켰습니다.
파인튜닝
셀프 어텐션 덕분에 문장 하나짜리 과제든 문장 쌍 과제든 입력과 출력만 바꿔 끼우면 됩니다. 기존에는 두 문장을 따로 인코딩한 뒤 교차 어텐션을 적용했지만, BERT는 두 문장을 이어 붙여 셀프 어텐션을 거는 것만으로 양방향 교차 어텐션을 포함합니다.
- 분류(GLUE 등): 새 파라미터는 분류층 \(W \in \mathbb{R}^{K \times H}\)(\(K\)는 라벨 수)뿐이고, 손실은 \(\log(\text{softmax}(CW^T))\)입니다.
- 추출형 질의응답(SQuAD): 시작 벡터 \(S \in \mathbb{R}^H\)와 끝 벡터 \(E \in \mathbb{R}^H\)만 새로 학습합니다. 지문의 \(i\)번째 토큰 표현을 \(T_i\)라고 하면 그 토큰이 답의 시작일 확률은 다음과 같습니다.
\[P_i = \frac{e^{S \cdot T_i}}{\sum_j e^{S \cdot T_j}}\]
\(i\)에서 \(j\)까지의 후보 구간 점수는 \(S \cdot T_i + E \cdot T_j\)이고, \(j \geq i\)인 구간 중 최고 점수를 답으로 고릅니다.
- 답이 없을 수 있는 질의응답(SQuAD 2.0): 답이 없으면
[CLS]위치에서 시작하고 끝나는 구간으로 취급합니다. 무응답 점수 \(s_{\text{null}} = S \cdot C + E \cdot C\)와 최고 구간 점수 \(\hat{s}_{i,j}\)를 비교해 \(\hat{s}_{i,j} > s_{\text{null}} + \tau\)일 때만 답을 냅니다. 임계값 \(\tau\)는 개발셋에서 F1이 최대가 되도록 고릅니다.
파인튜닝은 사전학습에 비해 매우 저렴합니다. 논문의 모든 결과는 같은 사전학습 모델에서 출발해 Cloud TPU 한 대로 1시간, GPU로 몇 시간이면 재현할 수 있습니다. 배치 16 또는 32, 학습률 \(5 \times 10^{-5}\)·\(3 \times 10^{-5}\)·\(2 \times 10^{-5}\), 에폭 2~4 범위에서 개발셋으로 고르면 대부분의 과제에서 잘 작동했습니다.
결과
GLUE
GLUE 테스트셋 결과입니다(평가 서버 채점). 열 아래 숫자는 학습 예시 수입니다.
| 시스템 | MNLI-m/mm | QQP | QNLI | SST-2 | CoLA | STS-B | MRPC | RTE | 평균 |
|---|---|---|---|---|---|---|---|---|---|
| (학습 예시) | 392k | 363k | 108k | 67k | 8.5k | 5.7k | 3.5k | 2.5k | |
| GPT 이전 SOTA | 80.6/80.1 | 66.1 | 82.3 | 93.2 | 35.0 | 81.0 | 86.0 | 61.7 | 74.0 |
| BiLSTM+ELMo+Attn | 76.4/76.1 | 64.8 | 79.8 | 90.4 | 36.0 | 73.3 | 84.9 | 56.8 | 71.0 |
| OpenAI GPT | 82.1/81.4 | 70.3 | 87.4 | 91.3 | 45.4 | 80.0 | 82.3 | 56.0 | 75.1 |
| BERT-Base | 84.6/83.4 | 71.2 | 90.5 | 93.5 | 52.1 | 85.8 | 88.9 | 66.4 | 79.6 |
| BERT-Large | 86.7/85.9 | 72.1 | 92.7 | 94.9 | 60.5 | 86.5 | 89.3 | 70.1 | 82.1 |
QQP와 MRPC는 F1, STS-B는 Spearman 상관계수, 나머지는 정확도입니다. 평균은 문제가 있는 WNLI를 뺀 값이라 공식 GLUE 점수와 조금 다릅니다.
BERT-Base와 BERT-Large가 모든 과제에서 기존 시스템을 앞섰고, 평균 정확도를 각각 4.5%p, 7.0%p 끌어올렸습니다. 가장 크고 많이 쓰이는 과제인 MNLI에서는 4.6%p 올랐습니다. 공식 리더보드 점수는 BERT-Large 80.5, GPT 72.8입니다. BERT-Base와 GPT는 크기와 구조가 거의 같으므로, 이 차이의 상당 부분은 양방향성과 사전학습 방식에서 나왔다고 볼 수 있습니다. BERT-Large와 BERT-Base의 차이는 학습 데이터가 적은 과제(CoLA, RTE)에서 특히 큽니다.
SQuAD v1.1과 v2.0
SQuAD v1.1(질문 10만 개, 위키백과 지문에서 답 구간 추출) 결과입니다.
| 시스템 | Dev EM | Dev F1 | Test EM | Test F1 |
|---|---|---|---|---|
| 사람 | - | - | 82.3 | 91.2 |
| 리더보드 1위 앙상블 (nlnet) | - | - | 86.0 | 91.7 |
| BiDAF+ELMo (단일) | - | 85.6 | - | 85.8 |
| BERT-Base (단일) | 80.8 | 88.5 | - | - |
| BERT-Large (단일) | 84.1 | 90.9 | - | - |
| BERT-Large (단일 + TriviaQA) | 84.2 | 91.1 | 85.1 | 91.8 |
| BERT-Large (앙상블 + TriviaQA) | 86.2 | 92.2 | 87.4 | 93.2 |
리더보드 상위 시스템은 공개 데이터를 자유롭게 쓸 수 있었기 때문에, BERT도 SQuAD 전에 TriviaQA로 먼저 파인튜닝했습니다. 단일 모델이 기존 1위 앙상블보다 F1이 높습니다. TriviaQA 없이도 F1이 0.1~0.4 떨어질 뿐입니다. 앙상블은 사전학습 체크포인트와 파인튜닝 시드가 다른 7개 시스템입니다.
| 시스템 (SQuAD v2.0) | Dev EM | Dev F1 | Test EM | Test F1 |
|---|---|---|---|---|
| 사람 | 86.3 | 89.0 | 86.9 | 89.5 |
| 리더보드 1위 단일 (MIR-MRC) | - | - | 74.8 | 78.0 |
| BERT-Large (단일) | 78.7 | 81.9 | 80.0 | 83.1 |
답이 없을 수 있는 v2.0에서는 TriviaQA 없이 기존 최고 시스템보다 F1을 5.1 높였습니다. 상식 추론 과제 SWAG에서도 BERT-Large가 테스트 정확도 86.3%로 ESIM+ELMo(59.2%)보다 27.1%p, GPT(78.0%)보다 8.3%p 높았고, 전문가 한 명의 정확도(85.0%, 100개 표본 기준)를 넘었습니다.
구성 요소 실험
사전학습 과제를 바꿔 본 결과입니다(BERT-Base, 개발셋). 데이터, 파인튜닝 방식, 하이퍼파라미터는 모두 같습니다.
| 사전학습 | MNLI-m | QNLI | MRPC | SST-2 | SQuAD F1 |
|---|---|---|---|---|---|
| BERT-Base (MLM + NSP) | 84.4 | 88.4 | 86.7 | 92.7 | 88.5 |
| NSP 제거 | 83.9 | 84.9 | 86.5 | 92.6 | 87.9 |
| 왼→오 LM, NSP 제거 | 82.1 | 84.3 | 77.5 | 92.1 | 77.8 |
| + 무작위 초기화 BiLSTM | 82.1 | 84.1 | 75.7 | 91.6 | 84.9 |
NSP를 빼면 QNLI, MNLI, SQuAD가 떨어집니다. 여기서 MLM을 왼→오 LM으로 바꾸면(GPT와 같은 조건) 모든 과제가 더 떨어지고, MRPC와 SQuAD에서 크게 떨어집니다. SQuAD에서는 토큰 표현에 오른쪽 문맥이 없으니 당연한 결과입니다. 왼→오 모델을 돕기 위해 BiLSTM을 위에 얹으면 SQuAD는 회복되지만 여전히 양방향 사전학습에 한참 못 미치고, GLUE는 오히려 나빠집니다.
ELMo처럼 왼→오와 오→왼 모델을 따로 학습해 이어 붙이는 방법에 대해서도 저자들은 반론을 적었습니다. 비용이 두 배이고, 질의응답에서는 오→왼 모델이 질문을 보고 답을 조건화할 수 없으며, 모든 층에서 양쪽 문맥을 쓰는 깊은 양방향 모델보다 엄밀하게 표현력이 약하다는 것입니다.
모델 크기에 따른 결과입니다(개발셋, 파인튜닝 5회 평균). LM perplexity는 학습 데이터에서 떼어 둔 부분의 Masked LM 기준입니다.
| \(L\) | \(H\) | \(A\) | LM (ppl) | MNLI-m | MRPC | SST-2 |
|---|---|---|---|---|---|---|
| 3 | 768 | 12 | 5.84 | 77.9 | 79.8 | 88.4 |
| 6 | 768 | 3 | 5.24 | 80.6 | 82.2 | 90.7 |
| 6 | 768 | 12 | 4.68 | 81.9 | 84.8 | 91.3 |
| 12 | 768 | 12 | 3.99 | 84.4 | 86.7 | 92.9 |
| 12 | 1024 | 16 | 3.54 | 85.7 | 86.9 | 93.3 |
| 24 | 1024 | 16 | 3.23 | 86.6 | 87.8 | 93.7 |
크기를 키울수록 네 지표가 모두 단조롭게 좋아집니다. 학습 예시가 3,600개뿐이고 사전학습 과제와 성격이 전혀 다른 MRPC도 마찬가지입니다. 저자들은 이것이 충분히 사전학습한 모델이라면 "아주 작은 과제에서도 극단적인 모델 크기 확장이 큰 개선으로 이어진다"는 것을 설득력 있게 보인 첫 연구라고 주장합니다. 당시 기준으로 BERT-Large(340M)는 원 Transformer 인코더(약 100M)의 세 배가 넘었습니다.
특징 기반으로 써도 되는가
파인튜닝 없이 BERT의 층 출력을 고정 특징으로 뽑아 2층 BiLSTM에 넣는 방식도 CoNLL-2003 개체명 인식에서 시험했습니다. 모든 과제를 Transformer 인코더로 표현할 수는 없고, 비싼 표현을 한 번만 계산해 두면 여러 실험을 싸게 돌릴 수 있기 때문입니다.
| 방식 (BERT-Base) | Dev F1 |
|---|---|
| 파인튜닝 | 96.4 |
| 임베딩층만 | 91.0 |
| 마지막 은닉층 | 94.9 |
| 끝에서 두 번째 은닉층 | 95.6 |
| 마지막 4개 층 가중합 | 95.9 |
| 마지막 4개 층 연결(concat) | 96.1 |
| 12개 층 전체 가중합 | 95.5 |
마지막 4개 층을 이어 붙이면 전체 파인튜닝과 0.3 차이밖에 나지 않습니다. BERT는 ELMo의 자리(특징 추출기)와 GPT의 자리(파인튜닝 기반 모델)를 모두 차지할 수 있다는 결론입니다.
부록의 추가 실험도 두 가지 짚을 만합니다. 사전학습을 50만 스텝에서 100만 스텝으로 늘리면 MNLI 정확도가 거의 1.0%p 오릅니다. 또 MLM은 배치마다 15% 토큰만 예측하므로 왼→오 LM보다 수렴이 약간 느리지만, 절대 정확도는 거의 처음부터 앞섭니다. 마스킹 비율 실험(80/10/10 대 100% [MASK] 등)에서는 파인튜닝이 마스킹 전략에 의외로 둔감했습니다. 다만 [MASK]만 쓰면 특징 기반 개체명 인식이 94.9에서 94.0으로 떨어져, 불일치 문제가 실제로 존재함을 보였습니다.
회고
GPT와의 비교에서 섞인 변수. 저자들은 부록 A.4에서 BERT와 GPT의 차이를 솔직하게 나열합니다. BERT는 위키백과를 더해 데이터가 4배 넘게 많고, 배치가 4배 크며(128,000 대 32,000 단어), [CLS]·[SEP]·세그먼트 임베딩을 사전학습 때부터 배우고, 파인튜닝 학습률을 과제별로 골랐습니다. GLUE 표의 BERT 대 GPT 비교에는 이 모든 차이가 섞여 있습니다. 저자들은 같은 조건에서 비교한 구성 요소 실험으로 대부분의 개선이 양방향성과 두 사전학습 과제에서 왔다고 반박합니다. 다만 그 실험은 개발셋 단일 비교입니다.
NSP의 운명. 이 논문의 실험에서는 NSP가 QNLI를 3.5%p 끌어올렸습니다. 그런데 2019년 RoBERTa는 NSP를 빼고 한 문서에서 연속된 문장을 최대 길이까지 채워 넣으면 성능이 같거나 오히려 좋아진다고 보고했습니다. RoBERTa 저자들은 BERT의 "NSP 제거" 실험이 손실 항만 빼고 문장 쌍 입력 형식은 그대로 둔 것일 수 있다고 지적했습니다. 그렇다면 입력 구성의 효과와 과제의 효과가 분리되지 않은 셈입니다. 이후 대부분의 후속 모델이 NSP를 버렸습니다.
선택 편향의 가능성. BERT-Large는 작은 데이터셋에서 파인튜닝이 불안정해서, 무작위 재시작을 여러 번 하고 개발셋 최고 모델을 골랐습니다. 이런 선택은 개발셋 수치를 부풀립니다. 대신 GLUE 평가 서버에는 BERT-Base와 BERT-Large를 한 번씩만 제출했다고 밝혔으므로 테스트 수치는 비교적 믿을 만합니다. GLUE 표에서는 WNLI를 빼고 평균을 냈고, 공식 제출에서는 WNLI에 항상 다수 클래스를 예측했습니다.
구조적 한계. Masked LM은 토큰의 15%에서만 학습 신호를 얻으므로 계산 효율이 낮습니다. 이 문제는 2020년 ELECTRA가 모든 토큰에서 "교체 여부"를 판별하는 방식으로 정면으로 다뤘습니다. 위치 임베딩을 학습하므로 입력은 512 토큰으로 묶여 있습니다. 그리고 인코더 전용 구조라 텍스트를 생성할 수 없습니다. 모델 크기 실험이 보여 준 "클수록 좋다"는 결론은 정확했지만, 그 확장의 주인공은 결국 생성이 가능한 디코더 전용 GPT 계열이 되었습니다.
그래도 남은 것. 논문 공개 1년 뒤인 2019년 Google 검색에 BERT가 들어갔고, RoBERTa, ALBERT, DistilBERT, ELECTRA 같은 후속 모델이 쏟아졌습니다. 생성형 LLM이 주류가 된 지금도 분류, 검색용 임베딩, 리랭킹처럼 텍스트를 "이해만 하면 되는" 자리에서는 BERT 계열 인코더가 여전히 쓰입니다. 코드와 사전학습 모델을 함께 공개해, 누구나 사전학습 없이 파인튜닝만으로 최고 수준 모델을 만들 수 있게 한 점도 영향이 컸습니다.
정리
- 입력의 15%를 가리고 양쪽 문맥으로 맞히는 Masked LM으로 "단방향 언어 모델"이라는 제약을 풀고, 모든 층에서 양방향인 Transformer 인코더를 사전학습했습니다.
- 출력층 하나만 붙여 파인튜닝하는 단일 구조로 GLUE 평균 7.0%p, SQuAD v2.0 F1 5.1을 포함해 11개 과제의 기록을 한꺼번에 경신했고, 작은 과제에서도 모델이 클수록 좋아진다는 것을 보였습니다.
- NSP와
[MASK]불일치, 15% 학습 신호, 생성 불가라는 한계는 후속 연구에서 대부분 고쳐지거나 우회되었습니다. "대규모 사전학습 후 파인튜닝"이라는 틀은 지금의 LLM까지 그대로 이어집니다.