A Simple Framework for Contrastive Learning of Visual Representations
A Simple Framework for Contrastive Learning of Visual Representations (SimCLR, 2020)
Chen, T., Kornblith, S., Norouzi, M., & Hinton, G. (2020). A simple framework for contrastive learning of visual representations. In International Conference on Machine Learning (ICML 2020).
배경
2020년, 자기지도 학습이 핵심 관심사였습니다. MoCo가 주목받았지만 복잡했습니다. Google Research 팀은 ICML 2020에서 놀랍도록 단순한 프레임워크만으로 자기지도 학습이 완전 지도 학습과 동등한 성능을 달성할 수 있음을 보여주었습니다. 10,000회 이상 인용되며 자기지도 학습의 황금기를 열었습니다.
저자 소개
Ting Chen은 UCLA 출신 Google Research 연구원입니다. Simon Kornblith은 Google Brain에서 표현 학습을 연구했습니다. Mohammad Norouzi는 이미지 생성과 검색 전문가입니다. Geoffrey Hinton은 Google Brain 연구원이자 토론토대 명예교수였습니다.
요약
라벨 없는 데이터에서 좋은 표현(representation)을 학습하는 것은 오래된 꿈이었습니다. SimCLR은 이 문제를 간단하고 우아하게 풀었습니다.
핵심 아이디어는 같은 이미지의 두 개 증강본이 유사하고, 다른 이미지의 증강본은 다르도록 학습하는 것입니다. 라벨이 없어도 됩니다. 증강 자체가 "이것은 같은 객체다"라는 신호를 제공합니다.
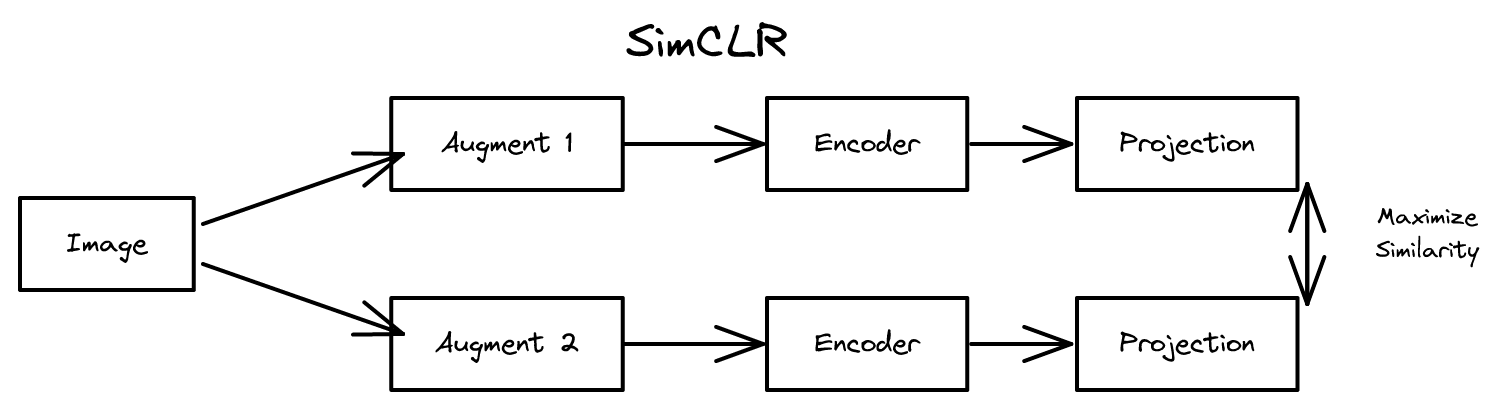
방법은 3단계입니다. 이미지를 무작위로 증강합니다. 신경망을 통과시킵니다. 비선형 프로젝션 헤드를 거칩니다. 그리고 대조 손실(contrastive loss)을 적용합니다. 큰 배치를 사용하면 음의 예(negative examples)를 풍부하게 확보할 수 있습니다.
결과는 획기적입니다. 라벨 없이 학습한 표현이 지도 학습(supervised learning)과 경쟁할 만큼 강력해졌습니다. ResNet-50 4x로 76.5% ImageNet 정확도를 달성했는데(표준 ResNet-50으로는 69.3%), 이는 당시 지도학습 수준과 동등했습니다.
논문 상세
배경: 자기지도 학습의 과제
자기지도 학습(self-supervised learning)은 라벨을 사용하지 않고 데이터 자체의 구조에서 신호를 추출합니다. 예를 들면 다음과 같습니다:
- 이미지의 일부를 숨기고 복원 (masked autoencoder)
- 회전된 이미지의 각도 예측 (rotation prediction)
- 이미지 순서 맞추기 (temporal ordering)
이들은 모두 작동하지만, 표현 품질이 지도 학습만큼 좋지 못했습니다.
대조 학습(contrastive learning)은 다른 접근입니다. 유사한 것은 가깝게, 다른 것은 멀게 배치하는 방식입니다. 문제는 이전 방법들이 비효율적이었거나 복잡했다는 점입니다.
방법론: SimCLR의 4단계
1단계: 데이터 증강
한 이미지 \(x\)에서 무작위로 두 개 증강본을 샘플링합니다.
\[\tilde{x}_i = t_i(x), \quad \tilde{x}_j = t_j(x), \quad t \sim \mathcal{T}\]
증강 종류: 무작위 자르기(random crop), 색상 왜곡(color distortion), 흐림(blur) 등.
중요한 발견: 데이터 증강의 조합이 핵심입니다. 회전만으로는 충분하지 않지만, 여러 증강을 결합하면 학습이 급격히 개선됩니다.
2단계: 신경망 인코더
표준 CNN (예: ResNet-50)으로 두 증강본을 인코딩합니다.
\[\mathbf{h}_i = f({\tilde{x}_i}), \quad \mathbf{h}_j = f(\tilde{x}_j)\]
3단계: 프로젝션 헤드
중요한 개선점으로, 인코더 뒤에 비선형 프로젝션 헤드를 추가합니다.
\[\mathbf{z}_i = g(\mathbf{h}_i) = W^{(2)} \sigma(W^{(1)} \mathbf{h}_i)\]
(논문 이전 방법들은 이 헤드를 사용하지 않았거나, MLP를 사용하지 않았습니다.)
4단계: 대조 손실
NT-Xent(Normalized Temperature-scaled Cross Entropy) 손실을 사용합니다.
\[\ell_{i,j} = -\log \frac{\exp(\text{sim}(\mathbf{z}_i, \mathbf{z}_j) / \tau)}{\sum_{k=1}^{2N} \mathbb{1}_{[k \neq i]} \exp(\text{sim}(\mathbf{z}_i, \mathbf{z}_k) / \tau)}\]
여기서:
- \(\text{sim}(\mathbf{z}_i, \mathbf{z}_j) = \frac{\mathbf{z}_i^T \mathbf{z}_j}{\|\mathbf{z}_i\| \|\mathbf{z}_j\|}\) (코사인 유사도)
- \(\tau\)는 온도 매개변수
- 배치 내 다른 모든 샘플을 음의 예로 사용
결과
ImageNet-1k에서:
- SimCLR (ResNet-50 4x): 76.5% Top-1 정확도 (표준 ResNet-50으로는 69.3%) (라벨 없음)
- 지도 학습 (ResNet-50): 76.5% Top-1 정확도 (약 100만 라벨)
이는 자기지도 학습이 대규모 지도 학습을 동등하게 달성한 첫 번째 사례입니다.
또한:
- 배치 크기가 클수록 성능이 향상됩니다 (배치 크기 4096~8192에서 최고 성능)
- 훈련 에포크가 많을수록 성능이 향상됩니다 (1000 에포크 이상)
- 표현이 강력해서 선형 평가(linear evaluation) 뿐 아니라 미세조정에서도 우수합니다
생각
잘한 점:
- 개념이 간단하면서도 강력합니다. "다른 사진은 다르게"라는 자연스러운 신호를 활용했습니다
- 데이터 증강의 중요성을 체계적으로 입증했습니다. 이후 모든 자기지도 학습이 이를 따랐습니다
- 프로젝션 헤드의 필요성을 보인 것이 중요합니다. 학습 역학을 개선합니다
- 대규모 배치의 효과를 명확히 했습니다. 이는 메모리 효율적 대조 학습으로 이어졌습니다
- 재현성이 높습니다. 코드가 공개되고, 매우 많은 후속 연구가 따랐습니다
한계:
- 큰 배치 크기를 요구합니다. 원래 4096이며, 이는 고가의 GPU가 필요합니다
- 메모리 효율 문제가 있습니다. BYOL이나 SwAV 같은 후속 연구가 메모리 문제를 개선했습니다
- 온도 매개변수 \(\tau\) 같은 하이퍼파라미터 튜닝이 필요합니다
- 이론적 분석이 제한적입니다. "왜" 대조 학습이 작동하는지에 대한 깊은 이해는 부족합니다
의의: 이 논문은 자기지도 학습(self-supervised learning)의 황금기를 열었습니다. BYOL, SwAV, MoCo 등 수많은 변형과 개선이 따랐고, 이들은 현대 비전-언어 모델(CLIP 등)의 기초가 되었습니다.
또한 대조 학습이 단순히 "좋은 특징"을 학습하는 것뿐 아니라, 데이터의 본질적 구조를 포착한다는 것을 보여주었습니다. 10,000회 이상 인용된 이유가 바로 이것입니다.
실제로 현대 컴퓨터 비전은 대부분 사전훈련(pretraining)을 거치며, 그 사전훈련의 상당 부분이 대조 학습 기반입니다.
후속 연구 링크
이 논문의 한계는 Hinton의 이후 연구에서 다루어졌습니다:
- 큰 배치 필요 → Big Self-Supervised Models are Strong Semi-Supervised Learners: SimCLRv2에서 큰 모델 + 소량 라벨 미세조정으로 라벨 효율성을 극대화했습니다